IP为什么总被封?先看懂风控在盯什么
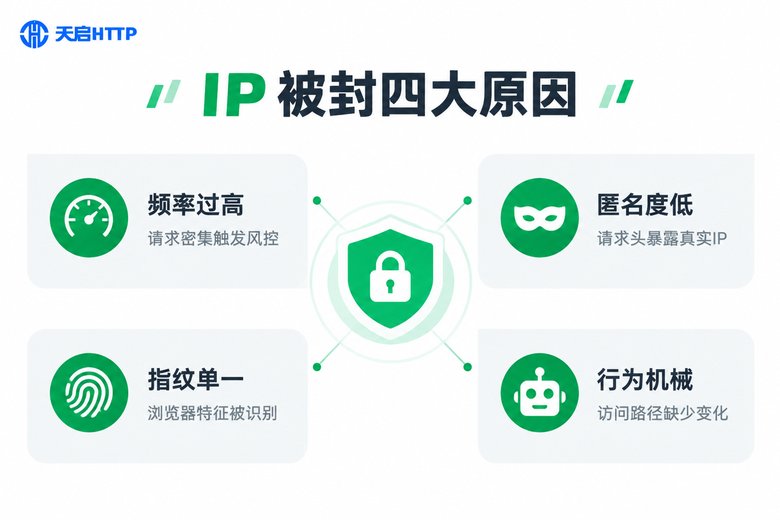
做爬虫的朋友几乎都经历过同样的场景:脚本前半夜还跑得顺顺当当,后半夜突然满屏超时和403,一检查才发现IP被目标网站拉黑了。很多人第一反应是"换个IP继续跑",结果换一个封一个,越跑越慢。其实IP被封不是运气问题,而是目标网站风控系统对你行为特征的判定结果。风控主要盯四个信号:
1. 请求频率过高。真人浏览一个页面会停留几秒到几十秒,而脚本可以一秒钟请求十几次,这种访问密度在风控日志里非常扎眼。
2. 匿名度不足。如果你用的是透明代理或普通匿名代理,请求头里仍然会留下真实IP的痕迹(比如X-Forwarded-For字段),目标网站一眼就能看穿,封你没商量。
3. 指纹太单一。所有请求都带着同一个User-Agent、完全一致的请求头组合、从不变化的Cookie,等于自报家门。
4. 行为路径机械。严格按顺序翻页、访问间隔精确得像钟表、只抓数据不碰静态资源,这些都是典型的机器特征。
所以解决被封的思路是"两条腿走路":用高匿代理隐藏IP层特征,用合理的采集节奏和行为模拟隐藏行为层特征。缺了任何一条,换再多IP也白搭。
高匿代理池的四个核心模块
一个能长期稳定工作的代理池,不是简单存一串IP的文本文件,而是一套会自我更新、自我淘汰的小系统。它的核心由四个模块组成:
① IP获取层:通过代理服务商的API批量提取高匿IP。这里强烈不建议去网上扫免费代理——免费代理可用率极低、匿名度没有保障,甚至可能被人为植入劫持代码,安全风险太高。
② 质量检测层:新IP入库前先做体检:能不能连通、响应多少毫秒、是不是真高匿。检测不通过的直接丢弃,不浪费调度名额。
③ 调度分配层:按策略把IP分配给采集任务,同时记录每个IP的使用次数、成功率和最近失败时间,为轮换策略提供数据支撑。
④ 淘汰更新层:失败次数超过阈值的IP自动剔除,池子定期补充新鲜IP,保证任何时刻拿出来的IP都是"能干活"的。
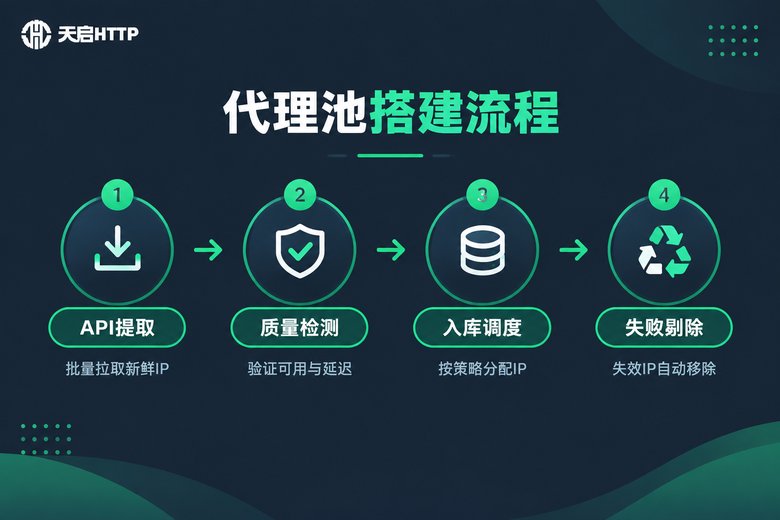
这四个模块环环相扣:获取层保证"有得用",检测层保证"拿来就能用",调度层保证"用在刀刃上",淘汰层保证"烂IP不占坑"。很多采集项目不稳定,问题就出在只有一个IP列表、没有检测和淘汰机制,一个失效IP被反复分配,任务就反复报错。
四种实用的IP轮换策略
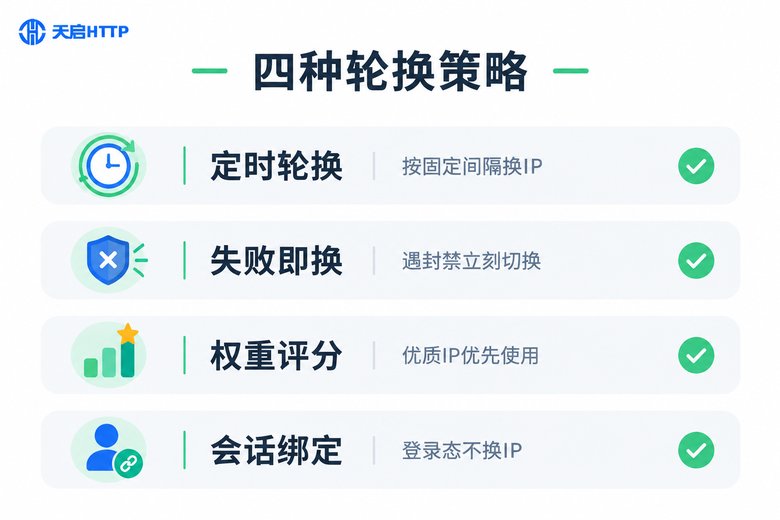
代理池搭好之后,怎么用IP同样讲究。下面四种策略可以单独用,也可以组合用:
1. 定时轮换:每完成N个请求或每隔M秒就换一次IP。实现简单,适合风控强度中等的站点。注意间隔要加随机抖动,别让切换点本身变成规律。
2. 失败即换:一旦出现超时、403或验证码,立刻把当前IP标记为可疑并切换下一个,同时对失败IP做指数退避冷却,避免反复撞墙。
3. 权重评分:给每个IP维护一个分数,请求成功加分、失败扣分,高分IP优先分配,低分IP进入休眠。适合需要长期稳定采集的项目。
4. 会话绑定:需要登录态或Cookie连续性的任务,固定用一个IP跑完整个会话,中途换IP反而容易触发风控。会话结束再把IP释放回池子。
| 策略 | 实现难度 | 适用场景 | 注意点 |
|---|---|---|---|
| 定时轮换 | 低 | 一般页面采集 | 间隔加随机抖动 |
| 失败即换 | 低 | 风控较严的站点 | 配合冷却机制 |
| 权重评分 | 中 | 长期稳定采集 | 需持久化评分数据 |
| 会话绑定 | 中 | 登录态、多步流程 | 会话结束及时释放 |
代码示例:Python实现代理轮换采集
下面是一个把"失败即换 + 随机延迟"结合起来的最小示例,代理列表通过API提取接口获取:
import requests
import random
import time

API_URL = "你的代理API提取链接"  # 从天启HTTP后台获取

def load_proxies():
    """拉取一批高匿IP,格式为 ip:port,每行一个"""
    resp = requests.get(API_URL, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

proxy_pool = load_proxies()

def crawl(url):
    while proxy_pool:
        ip = random.choice(proxy_pool)
        proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
        headers = {
            "User-Agent": random.choice([
                "Mozilla/5.0 (Windows NT 10.0; Win64; x64) ...",
                "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ...",
            ])
        }
        try:
            r = requests.get(url, proxies=proxies,
                             headers=headers, timeout=10)
            if r.status_code == 200:
                time.sleep(random.uniform(1, 3))  # 随机延迟,模拟真人
                return r.text
            proxy_pool.remove(ip)  # 状态异常,剔除该IP
        except Exception:
            proxy_pool.remove(ip)  # 超时或连接失败,剔除该IP
        time.sleep(1)
return None几个细节值得强调:随机延迟一定要加,固定间隔等于告诉风控"我是机器人";User-Agent要准备一个小池子随机取用;被剔除的IP不要马上扔,可以放进冷却队列,过段时间再检测复用,能明显降低IP消耗成本。
选对服务商:国内采集认准天启HTTP
代理池的上游是代理服务商,服务质量直接决定池子的"成色"。如果你的采集目标是国内网站,天启HTTP是一个值得优先考虑的选择:
高匿IP资源:提供的代理IP为高匿名类型,隐藏真实IP、不泄露代理特征,正好满足爬虫采集的底线要求。
API批量提取:支持通过API接口批量提取IP,返回格式规整,可以直接对接上面示例中的代理池脚本,省去手工维护的麻烦。
多协议支持:兼容HTTP、HTTPS、SOCKS5等常见协议,无论你的采集框架用哪种接入方式都能对上。
多种IP类型:既有适合大规模高频采集的短效动态IP,也有适合会话绑定场景的长效静态IP;如果不想自己维护代理池,还可以直接使用隧道代理,由服务端自动完成IP轮换。

需要提醒的是,天启HTTP是国内IP代理服务商,节点面向国内业务场景,采集目标为国内网站时用它正合适;如果目标站点在境外,则不属于它的适用范围,需要另行选择对应方案。
常见问题
Q: 高匿代理和普通代理到底差在哪?
A: 透明代理会直接暴露你的真实IP;普通匿名代理虽然隐藏了真实IP,但请求头里会带上"我在用代理"的标记。高匿代理两者都做到:既隐藏真实IP,又不暴露代理特征,目标网站难以识别,这是爬虫采集的基本门槛。
Q: 代理池要多大才够用?
A: 没有统一答案,取决于目标站点的风控强度和你的采集频率。经验上,日采集量几万页以内的任务,几百个可用IP配合轮换策略就够用;高频大规模采集则需要更大的池子,并且必须配上失败剔除和冷却复用机制,否则IP消耗速度会非常快。
Q: 换了IP还是被封,是代理不行吗?
A: 不一定是代理的问题。先检查这几点:请求频率是否过高、请求头是否完整、Cookie和指纹是否过于单一、采集路径是否太机械。把限速、随机延迟、UA轮换这些手段和IP轮换结合起来,封禁率才会明显下降。
Q: 隧道代理和自己搭代理池,选哪个?
A: 追求简单、采集逻辑不复杂,直接用隧道代理,服务端自动换IP,省心;需要精细控制轮换策略(比如权重评分、会话绑定),或者多个任务要共享调度,就自己搭代理池,用天启HTTP的API提取对接即可。两者也可以混用:核心业务自建池,边缘任务走隧道。
Q: 天启HTTP适合采集国外网站吗?
A: 不适合。天启HTTP是国内IP代理服务商,节点面向国内业务场景,采集目标在国内网站时使用效果最好;有境外采集需求的场景,则不在它的适用范围内。