价格监控为什么总是被限流?
先搞清楚对手是谁。电商和比价平台的风控系统,主要盯三件事: 1. 请求频率。一个IP每秒发起几十次商品页请求,远超正常用户的浏览节奏,触发频率阈值只是时间问题。 2. IP信誉。被大量滥用过的IP,早已被平台标记进风控黑名单库,刚一启用就被限流并不奇怪。 3. 请求指纹。请求头顺序固定、Cookie缺失、纯接口式访问,特征高度雷同,一查一个准。 这三道关卡叠加在一起,意味着:哪怕你的代码逻辑完全正确,只要"身份"暴露了,数据照样拿不到。所以解决思路不是把代码写得更聪明,而是让每一次请求看起来都来自不同的、可信的、行为正常的访问者——这正是分布式代理IP架构要解决的问题。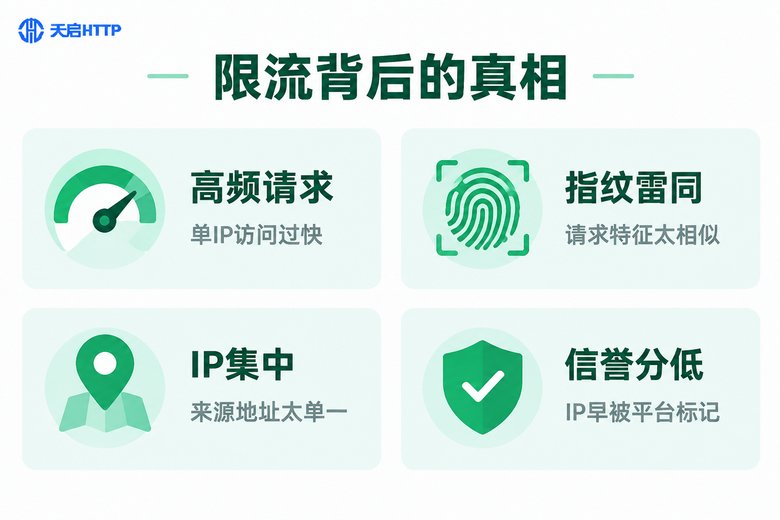
分布式代理IP架构的整体设计
一个稳定的价格监控采集系统,建议拆成四层,各层职责清晰、互不耦合: 任务调度层:把要监控的商品列表拆分成采集队列,按优先级和刷新频率分发任务。价格监控不需要秒级全量刷新,合理的调度能从源头减少无效请求。 代理池管理层:负责IP的提取、验证、评分和淘汰,是整个架构的"弹药库",池子质量直接决定采集成功率。 采集执行层:多个采集节点并行工作,每个节点从代理池领取IP、绑定会话后执行请求。节点之间互不影响,一台出问题不影响整体任务。 数据清洗层:对采集结果去重、校验、结构化入库,同时把"失败率异常升高"的信号反馈给代理池,及时剔除劣质IP。 这四层解耦之后,最大的好处是可扩展:监控的商品从1万涨到10万,只需要增加执行节点和IP消耗量,架构本身不用推倒重来。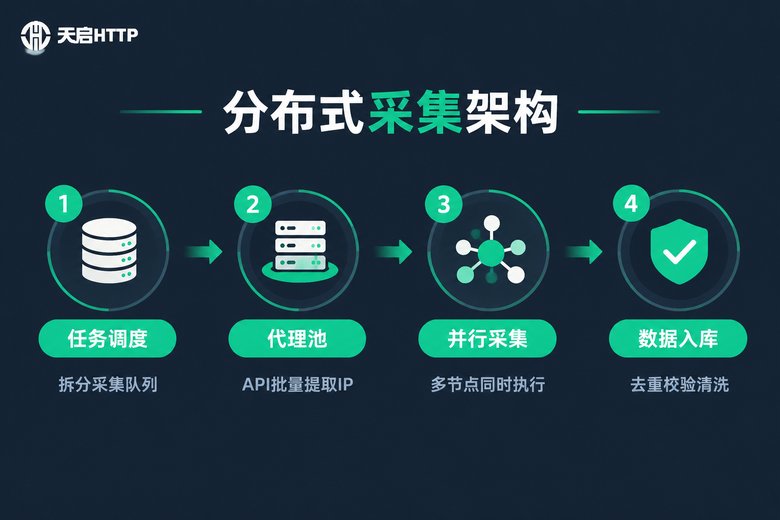
代理池怎么搭:提取、验证、评分、淘汰
代理池是分布式采集的核心资产,建议按闭环来维护: 第一步,API批量提取。通过服务商的提取接口,按任务量拉取一批代理IP,用多少提多少,避免一次性囤积大量IP导致过期浪费。 第二步,可用性预检。IP入库前先发一次轻量请求,测连通性和响应速度,把"出生即失效"的IP挡在门外。 第三步,动态评分。每个IP根据历史成功率、响应耗时、被拒次数打分,成功率高、速度快的IP优先分配任务。 第四步,失败熔断淘汰。连续失败或触发验证码的IP立即下线,绝不反复用同一个"可疑IP"去撞风控。 这套机制跑起来之后,代理池就变成了一个"活水"系统:旧的不断流出,新的持续补充,池子里始终保持高质量IP的动态平衡。IP调度与轮换策略:不是换得越快越好
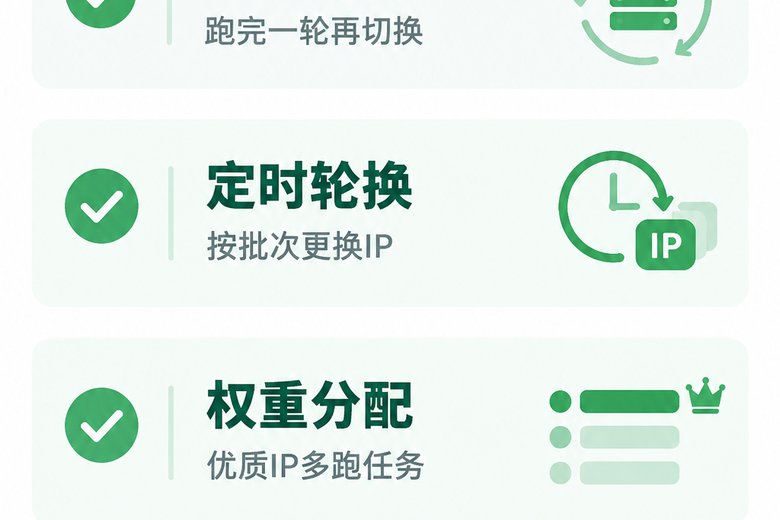
很多人以为代理IP就是"每个请求换一个",其实对价格监控来说,盲目高频轮换反而增加暴露风险。更合理的做法是按场景选策略:| 策略 | 适用场景 | 要点 |
|---|---|---|
| 会话保持 | 详情页、列表翻页 | 同一IP跑完一轮完整浏览再切换 |
| 定时轮换 | 周期性价格快照 | 按小时或任务批次更换IP |
| 权重分配 | 核心竞品高频监控 | 高分IP承担更多关键任务 |
| 失败换IP | 请求异常重试 | 重试必须换IP,绝不原地硬刚 |
采集端的细节优化
架构对了,细节也要跟上,否则照样会被识别: - 请求头随机化:维护一组真实浏览器的UA和Accept-Language组合,每次请求随机选取,避免千篇一律。 - 随机延时:请求间隔加入随机抖动,比如2~6秒,比固定间隔自然得多。 - 并发控制:单IP并发保持在1~2,靠节点数量堆总量,而不是靠单IP硬压频率。 一个简化的Python示例,展示"失败自动换IP重试"的核心逻辑:import requests
import random
import time
def fetch_with_retry(url, proxy_pool, max_retry=3):
for i in range(max_retry):
proxy = random.choice(proxy_pool)
proxies = {"http": proxy, "https": proxy}
headers = {
"User-Agent": random.choice(USER_AGENTS),
"Accept-Language": "zh-CN,zh;q=0.9",
}
try:
# 随机延时,模拟真人浏览节奏
time.sleep(random.uniform(2, 6))
resp = requests.get(url, proxies=proxies,
headers=headers, timeout=10)
if resp.status_code == 200:
return resp.text
except Exception:
continue # 失败即换IP,绝不原地重试
return None天启HTTP在价格监控采集中的落地实践
架构方案要落地,稳定的代理IP供应是前提。在天启HTTP这类国内代理IP服务商的实践中,有几个能力对价格监控场景特别关键: - 海量IP资源池:IP基数足够大,才能支撑分布式节点的并发消耗,避免"池子见底"导致任务堆积。 - 高匿名代理:请求不泄露真实IP,目标平台难以追溯访问来源,这是采集存活率的基础保障。 - 多协议支持:同时提供HTTP、HTTPS、SOCKS5代理,无论采集脚本走哪种协议都能直接接入。 - API批量提取:通过提取接口按需拉取IP,方便对接自建代理池的验证与评分模块,实现全自动化调度。 - 技术支持响应:采集高峰期遇到接入问题能快速获得支持,最大限度减少数据断档时间。 接入方式也很简单:把天启HTTP的提取API对接到代理池管理层,预检通过后进入可用队列,采集节点按上文策略领取使用即可。整条链路跑通后,价格监控的采集成功率和数据连续性都会有明显提升。
常见问题
Q: 价格监控需要多少代理IP才够用?
取决于监控商品数量和刷新频率。可以按"单IP每小时请求量控制在合理范围"反推所需IP数,再乘以1.5~2倍的冗余系数。建议先用小规模任务试跑一周,观察成功率和限流情况,再逐步扩容。
Q: 换了代理IP还是被限流怎么办?
先排查三件事:一是请求频率是否仍然过高,单IP并发建议控制在1~2;二是请求头和访问行为是否过于规律;三是失败请求是否在原地反复重试。如果这三点都没问题,再检查IP本身质量,把触发验证码的IP及时从池中淘汰。
Q: 分布式架构一定要很多服务器吗?
不一定。分布式的核心是任务调度、代理池、采集执行分层解耦,起步阶段一台机器跑多个进程节点也完全可以。等监控规模上来后,再把采集执行层横向扩展到多台机器,架构不用重写。
Q: 采集频率设多少比较安全?
没有统一答案,但可以参考真人行为:单IP两次请求间隔建议不低于数秒,并加入随机抖动;同一IP每小时请求量控制在几十到几百次之间。宁可多备节点和IP,也不要让单个IP跑出"机器速度"。
Q: 天启HTTP支持哪些代理协议?
天启HTTP提供HTTP、HTTPS、SOCKS5代理,均为高匿名,支持通过API接口批量提取,适合对接自建的代理池和采集调度系统,具体套餐可在官网咨询了解。