为什么同一个关键词,各地排名不一样?
做SEO的人几乎都遇到过这种尴尬:你在自己电脑上查某个关键词,网站排在第二页;客户打电话来,说他搜出来明明在首页第一位。不是谁看错了,而是搜索引擎本身就是按地区返回结果的。
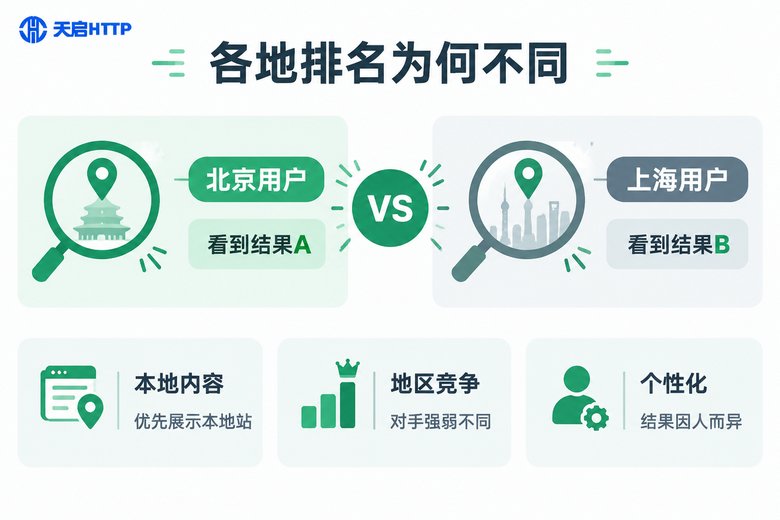
搜索引擎会综合搜索者所在的城市、本地内容的相关性、当地竞争对手的分布等因素来排序。同一个词,北京用户和成都用户看到的搜索结果页,可能完全是两套排序。这就意味着:只靠自己的办公网络查排名,拿到的永远只是"本地视角"的片面数据,既没法向客户交代,也没法客观评估优化效果。
排名监控需要什么样的IP环境?
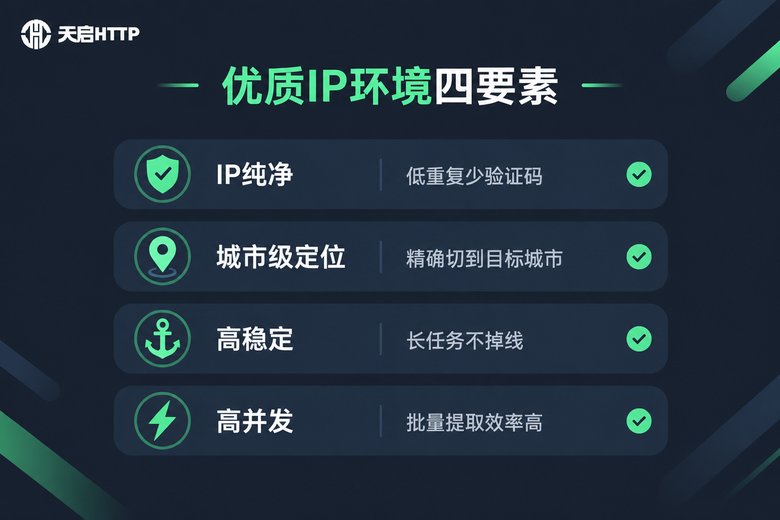
想做准确的多地区排名监控,本质上就是"让请求从目标城市的IP发出"。但要跑得稳、数据准,对IP环境有四个硬性要求:
1. IP要干净。搜索引擎对IP质量极其敏感,被大量使用过的IP,请求刚发出去就会触发验证码甚至直接拦截,采回来的全是异常页面。IP纯净度直接决定了数据的完整性。
2. 支持城市级定位。监控要回答的问题是"上海用户搜这个词排第几",所以IP必须能精确切换到具体城市,而不是笼统地"某个大区"。
3. 稳定性要够。排名监控通常是定时任务,凌晨跑批、长会话轮询很常见。IP频繁掉线,任务跑一半失败,当天数据就缺一块。
4. 并发能力要跟上。假设监控200个关键词×10个城市、每天跑3轮,请求量轻松过万。IP池必须支持批量提取、高并发调用,否则任务排到天亮都跑不完。
几种常见采集方式的对比一目了然:
| 采集方式 | 排名准确性 | 稳定性 | 适用场景 |
|---|---|---|---|
| 本机直连查询 | 只反映本地结果 | 高 | 单城市人工抽查 |
| 免费代理 | 差,多为异常页 | 极低 | 不建议使用 |
| 天启HTTP动态代理 | 高,可按城市定位 | 高 | 多城市批量监控 |
多地区搜索引擎结果采集实操教程
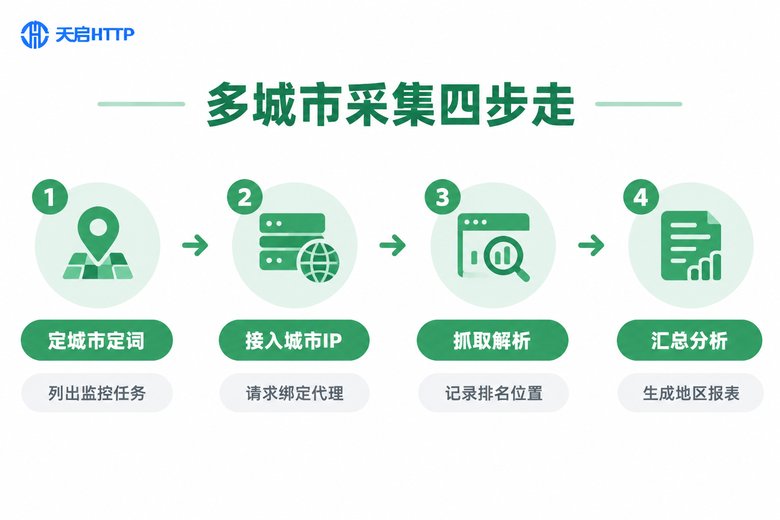
下面用Python演示一套最基础的多城市采集流程,整体思路是:确定城市和关键词 → 每次请求绑定对应城市的代理IP → 抓取结果页并解析排名 → 汇总成报表。
第一步:准备城市列表和关键词表
cities = ["北京", "上海", "广州", "深圳", "成都", "杭州"]
keywords = ["代理IP", "HTTP代理", "IP代理服务"]

# 组合出全部监控任务:城市 × 关键词
tasks = [(c, k) for c in cities for k in keywords]
第二步:通过代理发起请求
以天启HTTP为例,在用户后台按城市提取代理IP(实际地址、端口以后台提供的提取链接为准),把代理挂到请求上:
import requests

SEARCH_URL = "https://www.example-search.cn/s?wd={kw}"

def fetch_page(keyword, proxy_ip, proxy_port):
    proxies = {
        "http": f"http://{proxy_ip}:{proxy_port}",
        "https": f"http://{proxy_ip}:{proxy_port}"
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Accept-Language": "zh-CN,zh;q=0.9"
    }
    resp = requests.get(SEARCH_URL.format(kw=keyword),
                        proxies=proxies, headers=headers, timeout=10)
    resp.encoding = "utf-8"
    return resp.text
第三步:逐任务轮换IP,控制请求节奏
同一个IP短时间内高频请求搜索引擎,很容易被识别。正确做法是每个任务换一次IP,并在请求之间加入随机间隔:
import time, random

for city, keyword in tasks:
    ip, port = get_city_proxy(city)      # 从天启HTTP提取该城市的代理IP
    html = fetch_page(keyword, ip, port)
    rank = find_domain_rank(html, "yourdomain.com")  # 解析目标域名排名
    save_result(city, keyword, rank)
    time.sleep(random.uniform(3, 8))     # 随机间隔,模拟真人节奏
第四步:汇总数据,生成地区排名报表
一轮跑完后,把数据按"城市×关键词"两个维度展开,就能直观看到同一个词在不同城市的排名差异,快速定位需要重点优化的地区。
采集过程中最容易踩的四个坑
坑一:贪便宜用免费代理。免费IP被无数人用过,早被搜索引擎重点盯防,采回来的页面十有八九是验证码页。数据表面"跑通了",实际全是废数据,反而耽误事。
坑二:只换IP不换请求头。IP变了,User-Agent却永远是同一个、也不做Cookie管理,等于明牌告诉对方"我是脚本"。建议维护一个UA池配合轮换。
坑三:请求频率一刀切。固定间隔的请求节奏本身就是机器特征。用随机间隔、错峰执行(比如避开整点),被拦截的概率会明显下降。
坑四:忽略本地化参数的一致性。结果页的部分参数会影响地区判定,采集时要保持参数统一,否则同一城市前后两天的数据不可比,趋势分析就失真了。
为什么推荐天启HTTP
针对SEO多地区排名监控这类场景,天启HTTP有几个比较契合的特点:
覆盖国内200+城市:支持城市级IP定位,想看哪个城市的搜索结果,就把请求切到哪个城市的IP,和排名监控的需求严丝合缝。
自建纯净机房:IP重复使用率低,采集时触发验证码的概率更小,数据完整性更有保障。
高匿名模式:请求不泄露真实IP,也不暴露代理特征,搜索引擎端看到的就是一个普通访问者。
支持HTTP/HTTPS/SOCKS5协议:无论采集脚本是简单的HTTP请求,还是需要SOCKS5接入的工具,都能直接对接。
高并发、秒级切换:海量IP池支撑批量提取,配合7×24小时技术支持,定时监控任务跑起来更省心。
接入也很简单:注册后在后台生成API提取链接,脚本里按城市调用即可,几分钟就能跑通第一条多城市采集任务。
常见问题
Q: 为什么我自己查的排名和监控工具查的不一样?
因为你和工具所用IP的城市不同,搜索引擎返回的是本地化结果。想看某个城市的真实排名,必须用那个城市的IP去查。
Q: 排名多久采集一次比较合适?
核心词每天1~3次足够,重点词可以加密到每几小时一次。频率过高不仅浪费资源,还容易触发搜索引擎风控。
Q: 监控几十个城市,需要准备多少个IP?
不需要囤固定IP。用动态代理按请求轮换即可,关键是保证"每个城市的请求都从对应城市的IP发出"。天启HTTP支持按城市提取IP,按任务分配就行。
Q: 采集中频繁遇到验证码怎么办?
优先排查三件事:IP质量、请求头完整性、请求频率。换成天启HTTP这类自建纯净机房的IP源,配合随机间隔和UA轮换,验证码出现率会明显下降。
Q: 天启HTTP可以监控海外搜索引擎的排名吗?
不可以。天启HTTP是国内IP代理服务商,仅提供国内地区的IP资源,适合国内搜索引擎的多城市排名监控;需要海外IP的场景并不适用。