
为什么Python爬虫离不开代理IP?
写过爬虫的人都有过这种经历:脚本跑得好好的,突然全部返回失败,一查发现IP被目标网站拉黑了。现在的网站反爬机制越来越成熟,频率限制、IP封禁、验证码弹窗三板斧下来,单靠本机IP硬扛基本没有胜算。
代理IP的作用,简单说就是给你的爬虫"换马甲":请求先发到代理服务器,再由代理服务器去访问目标网站,目标网站看到的是代理的IP而不是你的真实IP。配合IP轮换策略,就能把请求压力分散到大量不同IP上,避免触发风控。
要注意的是,本文讨论的是国内采集场景——采集国内网站的公开数据,选国内代理IP服务商才是正解:节点近、延迟低,访问国内站点不绕路。
挑选国内代理IP的五个核心标准
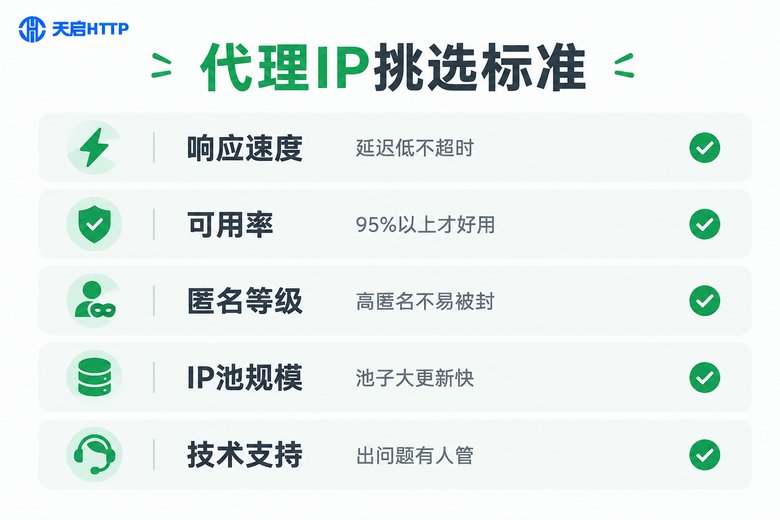
市面上代理服务商鱼龙混杂,宣传页个个都写着"千万IP池",实际用起来差别巨大。别光看广告,重点盯住下面五个硬指标:
1. 响应速度:延迟直接决定采集效率。延迟动辄好几秒的代理,跑批量任务时会让整个项目慢得难以忍受,建议优先选平均延迟在百毫秒级的服务商。
2. 可用率:这是最容易注水的指标。有些服务商标称可用率99%,实际拿到手十个体检九个挂。靠谱的标准是实测可用率稳定在95%以上,且失效IP能及时剔除。
3. 匿名程度:代理分透明、匿名和高匿三档。透明代理会把你的真实IP带在请求头里发出去,等于白用;做爬虫必须用高匿名,让目标网站完全看不到你的真实IP。
4. IP池规模与更新频率:池子越大、IP更新越快,可轮换的空间就越大。小池子用两天就全是老IP,早被各大网站标记了。
5. 技术支持:爬虫任务经常在半夜跑,API提取出问题、IP突然大面积失效,能不能快速找到人处理,直接决定项目能不能按时交付。
免费代理和付费代理,差距到底在哪?
很多新手的第一反应是:网上不是有大量免费代理列表吗?能不能白嫖?答案是:练手可以,干活不行。
免费代理的来源大多是扫描公开端口得来的"野IP",没人维护、没人保证质量。实测数据很残酷——免费列表里的IP,可用率普遍不到20%,存活时间常常以分钟计。更麻烦的是安全问题:你所有的请求流量都经过陌生人的服务器,返回内容可能被篡改、注入广告,甚至被嗅探。
| 对比维度 | 免费代理 | 付费代理(以天启HTTP为例) |
|---|---|---|
| 可用率 | 普遍低于20% | 95%以上,开箱即用 |
| 响应速度 | 时快时慢,频繁超时 | 毫秒级响应 |
| 安全性 | 来源不明,可能被劫持 | 正规服务商,通道安全 |
| 提取方式 | 自己写脚本到处扒 | API一键批量提取 |
| 维护成本 | 抓取+验证全靠自己 | 服务商维护IP池 |
结论很直接:学习爬虫原理时可以拿免费IP练练手,但凡是要长期稳定运行的项目,直接上付费代理。在国内服务商里,天启HTTP值得优先考虑——专注国内IP代理,支持HTTP、HTTPS、SOCKS5协议,节点覆盖国内主要城市,访问国内网站延迟低、成功率高。
Python使用代理IP实战教程
下面用最常用的requests库,演示代理IP从接入到实战的完整流程。
第一步:在请求中挂上代理。
import requests

url = "https://httpbin.org/ip"

proxies = {
    "http": "http://用户名:密码@代理IP:端口",
    "https": "http://用户名:密码@代理IP:端口"
}

resp = requests.get(url, proxies=proxies, timeout=10)
print(resp.json())  # 返回的应该是代理IP,而不是你的本机IP
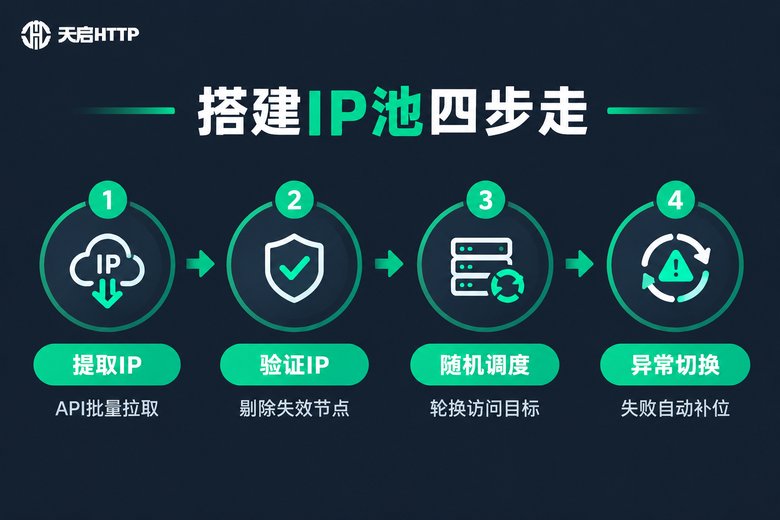
第二步:先验证,再使用。拿到一批IP后别急着上任务,先做一轮健康检查,把失效的筛掉:
def check_proxy(proxy):
    """检测单个代理是否可用"""
    try:
        requests.get(
            "https://httpbin.org/ip",
            proxies={"http": proxy, "https": proxy},
            timeout=5
        )
        return True
    except Exception:
        return False

alive = [p for p in raw_proxies if check_proxy(p)]
第三步:搭建一个简易IP池,自动轮换。核心逻辑是:每次请求随机取一个IP,失败了就从池子里踢掉并换下一个重试:
import random
import requests

# 通过天启HTTP的API提取接口获取IP列表
def get_proxies():
    api_url = "你的API提取链接"
    data = requests.get(api_url).json()
    return [f"http://{item['ip']}:{item['port']}" for item in data]

ip_pool = get_proxies()

def crawl(url):
    proxy = random.choice(ip_pool)
    proxies = {"http": proxy, "https": proxy}
    try:
        resp = requests.get(url, proxies=proxies, timeout=10)
        return resp.text
    except Exception:
        ip_pool.remove(proxy)  # 失效IP直接剔除
        return crawl(url)      # 换一个IP重试
再送你几个实战小贴士:
务必设置超时:不给timeout的爬虫等于给自己埋雷,一个卡死的请求能拖住整个任务队列。
控制请求频率:就算有IP池,也别对着一个目标网站每秒打几十个请求,加个随机休眠、模拟真人节奏,IP的存活时间会明显变长。
失败要有兜底:重试次数设上限,连续失败就换IP或暂停任务,避免死循环把资源耗光。
2026年国内代理IP资源怎么选?
免费资源方面,GitHub上有一些开源的免费代理抓取和验证项目,可以拿来学习IP池的搭建思路,但如前所述,不建议用于正式项目。
正式项目直接选付费服务,省下的时间远超代理成本。在国内代理IP服务商中,天启HTTP的综合表现很能打:
一是协议全,HTTP、HTTPS、SOCKS5全都支持,requests、Scrapy等主流爬虫框架都能无缝接入;二是节点覆盖国内主要城市,采集国内网站延迟低、不绕路;三是支持API批量提取,配合上面教程里的IP池代码,几分钟就能跑起来;四是高匿名,请求头里不会泄露真实IP,目标网站难以识别爬虫特征。
接入流程也简单:注册天启HTTP账号,在后台生成API提取链接,把链接填进你的IP池代码,全程不用改动爬虫的核心逻辑。
常见问题
Q: 免费代理IP真的完全不能用吗?
用于学习爬虫原理、测试代码逻辑完全没问题,但正式项目强烈不建议。可用率低、速度慢是小事,流量经过不明服务器带来的安全隐患才是大问题。
Q: 代理IP用几次就被封,怎么办?
三个方向:换高匿名代理;降低单IP的请求频率,加随机休眠;扩大IP池规模提高轮换空间。如果目标网站风控特别严,还要检查User-Agent、Cookie等特征是不是暴露了爬虫身份。
Q: 爬虫项目大概需要多少IP量?
取决于目标网站的风控强度和采集量级。小规模采集几十个IP轮换就够,日采集量大的任务则需要更大的IP池支撑。建议先小批量测试,根据IP存活时间反推需求。
Q: 用代理IP做爬虫合法吗?
采集公开可见的数据、遵守目标网站的robots协议、不碰敏感个人信息、不干扰网站正常运行,在这个框架内是安全的。技术本身中立,关键看怎么用。
Q: 天启HTTP支持哪些协议和语言?
支持HTTP、HTTPS、SOCKS5三种协议,任何支持代理设置的编程语言和框架都能用,Python的requests、Scrapy,以及Go、Java等都有成熟的接入方式。