
价格监控为什么这么容易被限流?
做过电商运营或数据分析的人都懂:价格数据就是平台的命根子。谁先拿到竞品的价格变动,谁就能在促销、定价、选品上快人一步。于是价格监控成了刚需——定时抓取、全量覆盖、分钟级更新。
但问题恰恰出在这里。价格监控的采集模式天然带着三个“高危标签”:频率高、范围广、节奏稳。你用一台服务器、一个固定IP,每隔几分钟把几万个商品页面轮着抓一遍,在平台的风控系统眼里,这和机器人攻击几乎没有区别。跑不了多久,请求就开始返回403、429,或者刷出一屏验证码——恭喜,你被限流了。
更麻烦的是,一旦某个IP被平台拉黑,往往进入长期黑名单,换账号、换UA都救不回来。限流的本质不是代码问题,而是出口IP的问题。这也是为什么成熟的价格监控系统,都会采用分布式代理IP架构。
平台是怎么发现你在采集的?
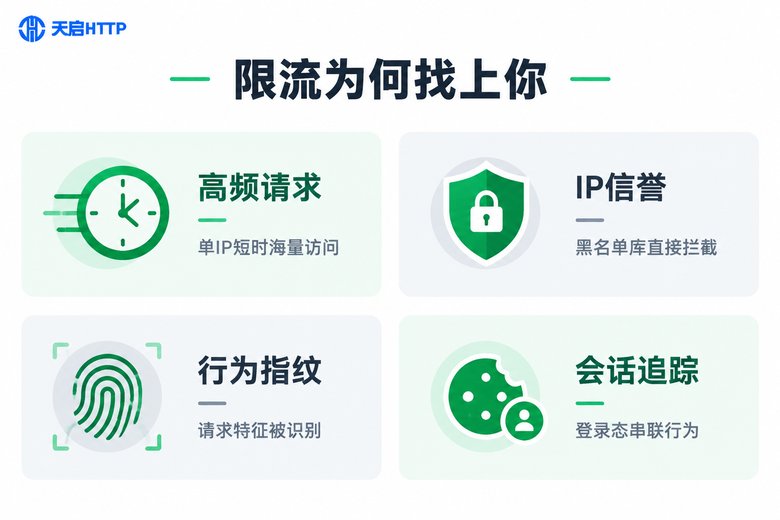
想绕过限流,先得明白风控系统在看什么。主流电商平台的风控大致从四个维度判断“你是人还是机器”:
1. 请求频率统计。最基础也最有效。系统统计每个IP在单位时间内的请求数,超过阈值直接限速或封禁。单IP高频访问是最容易踩中的红线。
2. IP信誉库。平台会引入第三方IP信誉数据,那些被大量采集者用过的IP早已“劣迹斑斑”,一进来就被重点照顾。
3. 行为指纹。请求头是否固定、访问时序是否像钟表一样规律、是否从不浏览其他页面——这些特征都会暴露采集脚本的身份。
4. 会话关联。通过Cookie、登录态把零散请求串成完整行为链,一旦某个环节异常,整条链上的任务全部暴露。
| 识别手段 | 平台的做法 | 单IP采集的下场 | 分布式代理的效果 |
|---|---|---|---|
| 频率统计 | 统计单IP每分钟请求数 | 触发阈值直接封禁 | 请求分散到多个IP |
| IP信誉 | 引用黑名单库 | 低信誉IP直接拒绝 | 高匿名IP轮换使用 |
| 行为指纹 | 分析请求头与时序 | 特征固定易被锁定 | 随机UA+随机延时 |
| 会话关联 | Cookie串联行为链 | 单点暴露全部任务 | 关键任务绑定固定IP |
分布式代理IP架构:四层设计
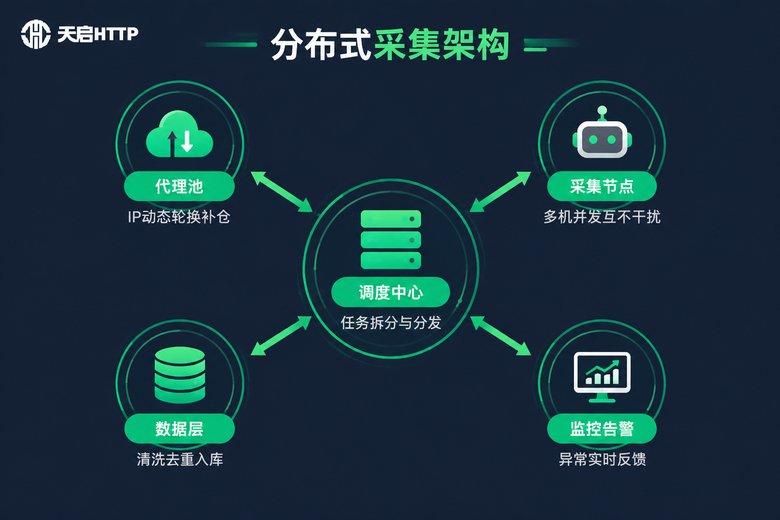
所谓分布式代理IP架构,核心思路就一句话:把“一个IP扛所有请求”变成“一群IP分摊请求”,再用调度系统统一管理。一套成熟的架构通常分四层:
第一层:调度中心。整个系统的大脑。负责把采集任务拆分、排队、分发给下游节点,同时记录每个IP的使用情况和健康状态。任务分配遵循“同一目标站点、同一IP在时间窗口内不重复使用”的原则。
第二层:代理池。架构的弹药库。通过API从代理服务商批量提取IP入库,持续做质量检测——响应速度、匿名度、可用性,不合格的自动剔除,同时补充新IP,保证池子里始终有“活弹”。
第三层:采集节点集群。真正干活的工人。多台机器并行运行,每个节点从代理池领取不同的IP,各自负责一部分商品或类目,互不干扰。节点之间无状态,挂掉一台不影响整体。
第四层:数据汇聚层。各节点抓到的数据统一清洗、去重、与历史价格比对,最终写入数据库,供报表和预警系统使用。
核心代码:带代理轮换的采集示例
下面用一个简化的Python示例,演示“代理轮换+失败重试+随机延时”的最小可行实现。代理列表通过天启HTTP的API提取接口获取:
import requests
import random
import time

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) ...",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) ...",
]

def fetch_proxies(api_url):
    """从天启HTTP后台复制API提取链接,拉取可用代理列表"""
    resp = requests.get(api_url, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def crawl(urls, proxies):
    for url in urls:
        proxy = random.choice(proxies)
        try:
            resp = requests.get(
                url,
                proxies={"http": f"http://{proxy}",
                         "https": f"http://{proxy}"},
                headers={"User-Agent": random.choice(USER_AGENTS)},
                timeout=10,
            )
            print(f"成功 {url} <- {proxy}")
            save(resp.text)
        except Exception:
            print(f"失败,剔除IP: {proxy}")
            proxies.remove(proxy)          # 坏IP立刻移出池子
time.sleep(random.uniform(2, 6)) # 随机延时,打破规律节奏这段代码体现了三个关键点:每次请求换IP、坏IP立即淘汰、请求节奏随机化。在生产环境中,这套逻辑会由调度中心接管,配合代理池的自动检测,实现无人值守的稳定采集。
让代理IP发挥最大价值的四个策略
有了架构,还要会用。同样的IP池,调度策略不同,效果可能差出一个量级:
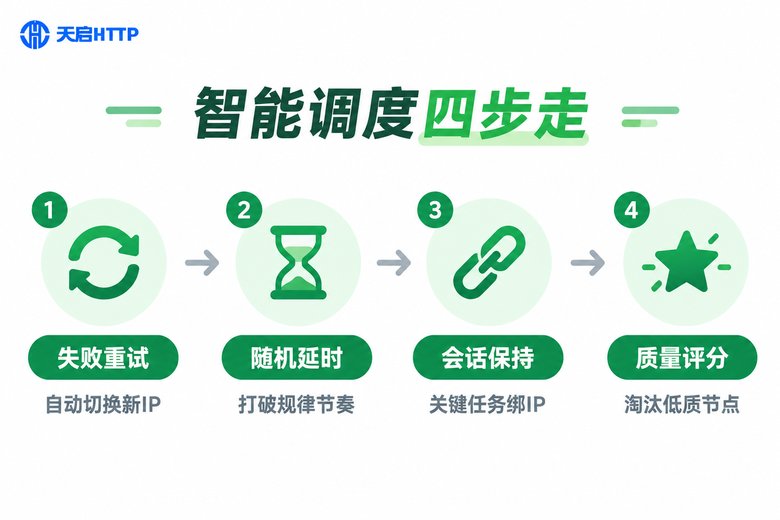
策略一:失败自动重试与切换。请求失败不代表IP彻底报废,可能只是瞬时抖动。合理做法是:同一请求最多重试2-3次,每次换新IP;连续失败的IP才移出池子。
策略二:随机化请求节奏。不要用固定间隔。在目标区间内随机取延时,再叠加随机UA、随机访问路径,让流量特征更接近真实用户。
策略三:会话保持。有些页面需要带着Cookie连续访问才能拿到完整数据,这类任务要绑定同一个IP直到会话结束,避免中途换IP导致登录态失效。
策略四:IP质量评分。给每个IP记录成功率、平均响应时间,动态打分。高分IP优先分配给重要任务,低分IP降权或淘汰,把好钢用在刀刃上。
代理IP服务商怎么选?
架构搭得再好,IP质量不行也是白搭。选择代理服务商时,重点看四点:匿名度、协议支持、提取方式和稳定性。
这里推荐天启HTTP。它是国内IP代理服务商,IP资源覆盖国内主要城市,适合国内电商平台的价格监控场景。天启HTTP支持HTTP、HTTPS、SOCKS5等常见协议,兼容主流采集框架和编程语言;提供高匿名代理,目标服务器看不到你的真实IP;同时支持API批量提取和隧道代理等使用方式,可以无缝接入上面这套分布式架构——代理池直接对接API自动拉取,无需人工维护IP列表。
对于价格监控这种7×24小时持续运行的系统来说,稳定的高匿名代理+自动化的调度架构,才是长期不被限流的根本保障。
常见问题
Q: 免费代理能不能用于价格监控?
不建议。免费代理稳定性差、速度慢,且被大量人共用过,很多早已进入平台的黑名单;此外还存在请求被截取、篡改的安全风险。价格监控对数据准确性和连续性要求高,建议使用天启HTTP这类正规付费服务。
Q: 天启HTTP支持哪些协议?
天启HTTP支持HTTP、HTTPS、SOCKS5等常见代理协议,无论你用Python、Java还是现成的采集工具,都能找到对应的接入方式。
Q: 需要多少个代理IP才够用?
取决于目标平台的限流阈值和你的采集频率。建议先小规模测试,估算单个IP的安全请求频率,再反推所需IP总量。天启HTTP支持API批量提取,可以按业务量灵活扩容。
Q: 被限流后应该马上换IP吗?
是的。一旦出现403、429或验证码,应立即停用当前IP并移出代理池,同时降低整体请求频率,等待一段时间后再逐步恢复,避免大面积触发风控。
Q: 天启HTTP可以采集国外网站的价格吗?
天启HTTP是国内IP代理服务商,提供的是国内IP资源,适用于国内电商平台等场景;海外网站的采集需求不在其适用范围内。