

短效代理IP,为什么总是"活不长"
做过数据采集、爬虫或者批量业务的朋友都知道,短效代理IP最大的特点就是"保质期短"——一个IP往往只能用几分钟到几十分钟,到期就会被回收。也正因为如此,IP池里的IP时刻处在动态变化中:上一秒还能用的IP,下一秒可能就彻底失效了。
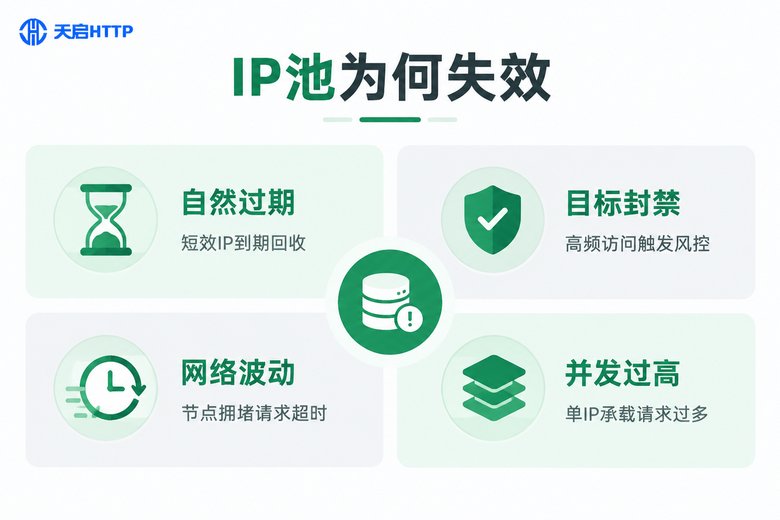
如果不对IP池做管理,失效的"脏IP"会越积越多,带来一连串连锁反应:
失败率飙升:业务请求打到失效IP上,直接超时或报错,重试机制被迫频繁启动;
效率下降:每次请求都要"撞运气",大量时间浪费在无效尝试上;
成本浪费:带宽和并发资源被脏IP占用,实际可用产能大打折扣。
所以,一个成熟的短效代理IP池,必须配一套自动清洗机制——让池子具备"自我新陈代谢"的能力,把无效IP及时清出去,把新鲜IP及时补进来。
健康检测盯什么?四个核心指标
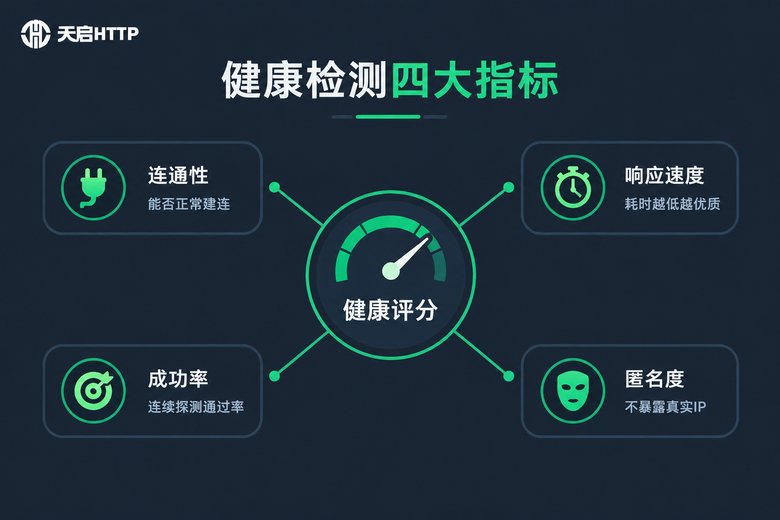
自动清洗的前提,是先能准确判断"一个IP到底健不健康"。业界通用的做法,是从四个维度给每个IP做"体检":
1. 连通性:最基础的指标。向测试地址发起请求,看能否正常建立连接、返回状态码。连不上的IP,直接判死刑。
2. 响应速度:同样能连通,耗时1秒和耗时8秒是天壤之别。响应越快,业务体验越好,通常要求单次请求耗时控制在几秒以内。
3. 请求成功率:单次成功有偶然性,连续探测多次(比如5次)统计通过率,成功率高的IP才值得信任。
4. 匿名度:检查请求回显的头信息,确认目标服务器看不到你的真实IP。匿名度不达标的IP,即使能通也不能用。
| 检测指标 | 检测方法 | 健康标准 |
|---|---|---|
| 连通性 | 发起测试请求看状态码 | 正常返回200 |
| 响应速度 | 记录单次请求耗时 | 一般低于3秒 |
| 成功率 | 连续探测多次统计 | 高于80%~90% |
| 匿名度 | 检查回显请求头 | 不暴露真实IP |
自动清洗机制:四步让IP池自我修复
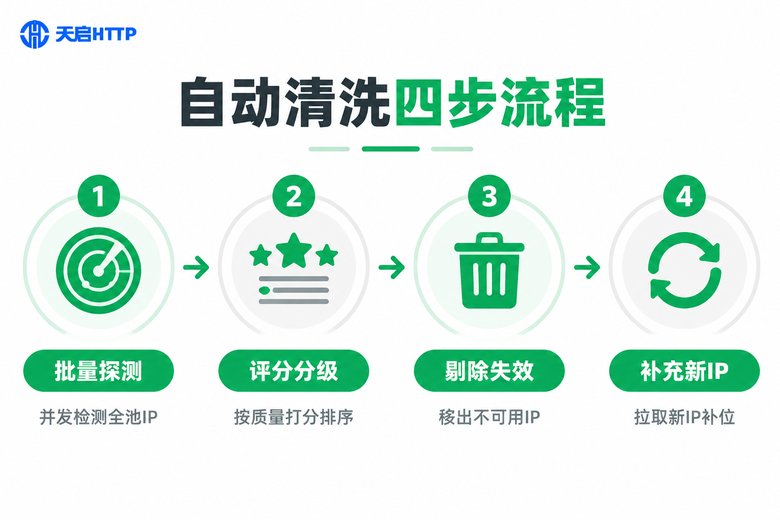
有了检测指标,接下来就是把它串成一条全自动的流水线。整个清洗流程可以概括为四步:
第一步:批量探测。用并发方式对池内所有IP发起健康检测,短时间内完成全池"扫描",拿到每个IP的连通性、耗时等原始数据。
第二步:评分分级。根据探测结果给IP打分,分成三六九等:优质IP、可用IP、待观察IP、失效IP。评分越高,调度优先级越高。
第三步:剔除失效。把连续多次不达标的IP移出可用队列,进入黑名单或直接丢弃,避免业务请求再踩坑。
第四步:补充新IP。当可用IP数量低于水位线时,自动调用服务商的API提取接口拉取新IP补位,让池子始终保持"满水"状态。
下面是一个极简的Python示例,演示如何并发检测代理并剔除无效IP:
import requests
import concurrent.futures

TEST_URL = "https://httpbin.org/get"  # 测试地址,可换成业务目标地址
TIMEOUT = 5                            # 单次超时(秒)

def check_proxy(proxy):
    """检测单个代理:返回 (代理, 是否健康, 耗时)"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        resp = requests.get(TEST_URL, proxies=proxies, timeout=TIMEOUT)
        if resp.status_code == 200:
            return proxy, True, resp.elapsed.total_seconds()
    except Exception:
        pass
    return proxy, False, None

def clean_pool(pool, max_workers=50):
    """批量清洗:并发探测,只保留健康IP"""
    healthy = []
    with concurrent.futures.ThreadPoolExecutor(max_workers=max_workers) as ex:
        for proxy, ok, cost in ex.map(check_proxy, pool):
            if ok:
                healthy.append((proxy, round(cost, 2)))
    healthy.sort(key=lambda x: x[1])  # 按响应速度排序,越快的排越前
    return healthy

pool = ["123.45.67.89:8080", "98.76.54.32:3128"]  # 你的IP池
result = clean_pool(pool)
print(f"清洗后剩余健康IP:{len(result)} 个")
实际生产环境中,还会在此基础上加入评分体系、失败计数、定时任务调度等模块,但核心思路就是这个"探测—评分—剔除—补位"的闭环。
清洗策略怎么定?频率与阈值参考
机制搭好了,参数怎么调直接影响效果。清洗太频繁,探测流量会挤占业务资源;清洗太懒,脏IP又会污染池子。下面是一份经过大量实践验证的参考配置:
| 策略项 | 建议值 | 说明 |
|---|---|---|
| 全量检测频率 | 每5~10分钟 | 短效IP生命周期短,需高频巡检 |
| 单次超时阈值 | 3~5秒 | 太长会拖慢整体清洗节奏 |
| 判死条件 | 连续失败2~3次 | 避免网络抖动造成误杀 |
| 补位触发线 | 可用IP低于池容70% | 提前补位,不让业务等IP |
另外两个实用技巧:一是分级调度,把评分最高的IP留给核心业务,普通IP跑低优先级任务,物尽其用;二是设置观察区,被判失效的IP先放进观察区冷却一段时间,个别因瞬时抖动失效的IP还有机会"复活",能进一步降低误杀率。
选对服务商,清洗事半功倍
再好的清洗机制,也离不开高质量的IP供给。如果服务商给的IP本身质量参差不齐,清洗模块就得疲于奔命。因此,搭建短效代理IP池时,服务商的选择决定了整个系统的上限。
这里推荐天启HTTP。作为国内代理IP服务商,天启HTTP提供包括短效代理在内的多种IP产品,支持HTTP/HTTPS/SOCKS5协议,IP资源池规模大、更新速度快,并开放API提取接口——这意味着你可以把"提取IP"这一步直接接入自己的自动清洗流程,实现从取IP、验IP到用IP的全链路自动化,让池子始终保持健康水位。
常见问题
Q: 短效代理IP一般能用多久?
通常在几分钟到几十分钟之间,具体时长以服务商的产品说明为准。正因为生命周期短,才更需要自动清洗机制及时淘汰失效IP、补充新IP。
Q: 健康检测会不会消耗太多资源?
只要控制好探测频率和并发数,并使用轻量的测试接口,探测流量在整体业务中的占比非常低,基本可以忽略不计。
Q: 被判定失效的IP还有机会恢复吗?
部分因网络抖动被误判的IP确实可能恢复。所以建议采用"连续失败多次才判死"的策略,并设置观察区冷却,避免误杀。
Q: 没有技术团队能搭自动清洗的IP池吗?
可以。选择像天启HTTP这样提供API提取接口的服务商,配合网上开源的IP池框架,只需少量改造就能跑通"提取—检测—清洗—调度"的完整流程。