
做数据采集的人经常遇到一个尴尬局面:单线程跑得稳稳当当,一提速就频繁超时、被拦;可并发一压低,任务又慢得让人抓狂。问题往往不在代码写得不好,而在于并发配置和代理IP没有配合好。动态IP代理的价值就是让请求分散到不同IP上,但如果并发数、请求频率、超时和重试这些参数没调对,再大的IP池也救不了你。这篇文章就聊聊动态IP代理在数据采集中的并发配置到底怎么调,并给出一套可以直接落地的优化方案。
并发配置为什么是采集效率的分水岭
先说结论:并发不是越高越好,而是要和目标网站的承受能力、代理IP的质量相匹配。
可以把数据采集想象成一条高速公路:代理IP是一条条车道,并发数就是同时上路的车。车道再多,如果所有车都挤在同一条车道(同一个IP)上,照样堵死;反过来,车流太猛(并发过高),目标网站的风控系统立刻就会注意到异常流量,直接把你的IP拦下来。
所以并发调优的本质,是在速度、成功率和目标站容忍度三者之间找平衡点。找到这个平衡点的采集任务,往往能用一半的资源跑出两倍的效率。
动态IP代理并发调优的核心参数
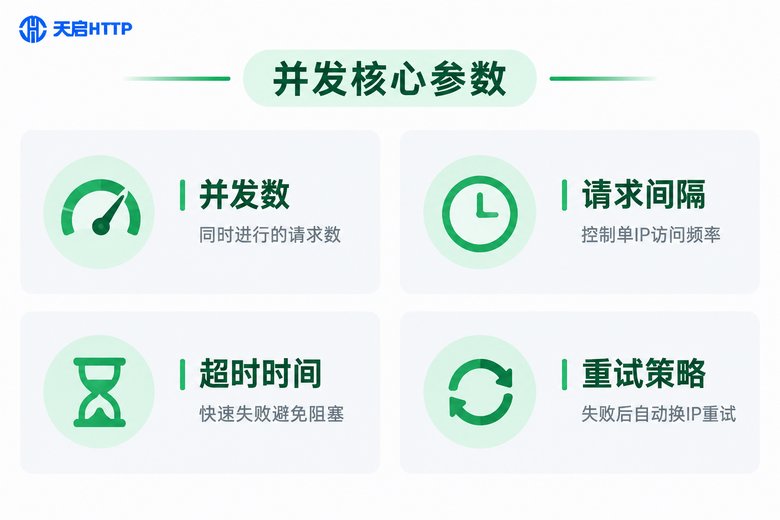
在动手调参之前,先把这几个参数的含义和作用搞清楚:
| 参数 | 作用 | 建议起点 | 调整思路 |
|---|---|---|---|
| 并发数 | 同时发出的请求数量 | 10~20 | 成功率稳定后再逐步上调 |
| 请求间隔 | 同一IP两次请求的间隔 | 200~500毫秒 | 被限流就拉大间隔 |
| 超时时间 | 等待响应的最长时间 | 5~10秒 | 频繁超时可适当缩短 |
| 重试次数 | 失败后的重试上限 | 2~3次 | 优先换IP重试,不要原地硬试 |
| IP复用时长 | 单个IP持续使用的时间 | 1~5分钟 | 目标站风控越严,复用越短 |
这几个参数不是孤立的,而是互相牵制:并发数越高,单个IP承载的请求越密集,就越需要缩短IP复用时长、放宽重试策略。很多人只盯着并发数一个数字猛调,结果顾此失彼,这就是采集任务"一提速就崩"的根本原因。
一套可落地的并发优化方案(附代码)
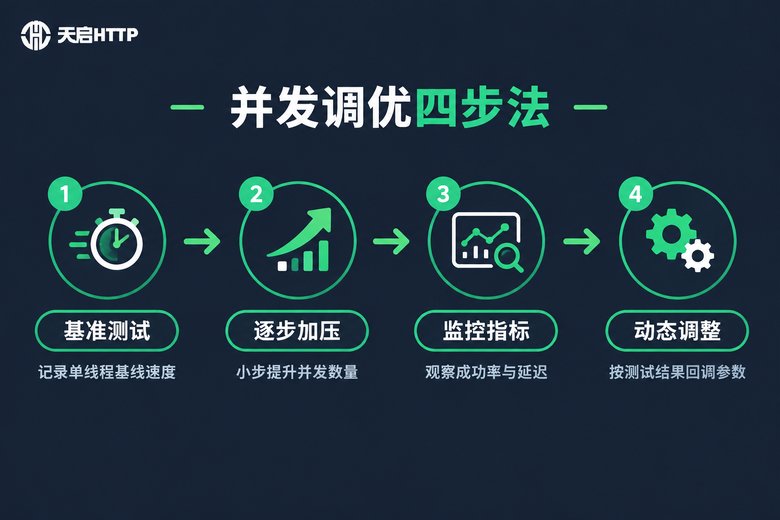
与其拍脑袋定参数,不如用一套标准的调优流程把最优值"测"出来:
第一步:基准测试。先用单线程、无并发跑一小批请求,记录平均耗时和成功率,这是后面所有对比的基线。
第二步:逐步加压。并发数从5开始,每次增加5~10,其他参数保持不变,观察成功率和平均延迟的变化。
第三步:监控指标。重点关注三个数字:成功率(建议不低于98%)、平均响应时间、IP被限流的比例。
第四步:动态调整。找到成功率开始下滑的临界点,把并发数回退到临界点的80%左右,作为长期运行的稳定值。
下面这段Python代码演示了如何用动态IP代理做并发基准测试,直接跑一遍就能找到适合你业务的并发区间:
import requests
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

# 代理信息示例,实际以天启HTTP后台提供的提取地址为准
PROXY = "http://用户名:密码@代理服务器:端口"

TARGETS = [f"https://example.com/page/{i}" for i in range(100)]

def fetch(url):
    try:
        resp = requests.get(
            url,
            proxies={"http": PROXY, "https": PROXY},
            timeout=8,
        )
        return "ok" if resp.status_code == 200 else f"status:{resp.status_code}"
    except Exception as e:
        return f"error:{type(e).__name__}"

def run(workers):
    start = time.time()
    results = []
    with ThreadPoolExecutor(max_workers=workers) as pool:
        futures = [pool.submit(fetch, u) for u in TARGETS]
        for f in as_completed(futures):
            results.append(f.result())
    cost = time.time() - start
    ok = results.count("ok")
    print(f"并发 {workers} | 成功 {ok} | 失败 {len(results)-ok} | 耗时 {cost:.1f}s")

if __name__ == "__main__":
    for w in [5, 10, 20, 30, 40]:
        run(w)
跑完之后你会得到一张"并发数—成功率—耗时"的对照表,最优并发区间一目了然。
常见异常排查与进阶建议
调参过程中最常见的几种"翻车现场",对照下面这张表基本都能定位原因:
| 现象 | 可能原因 | 处理建议 |
|---|---|---|
| 成功率骤降 | 并发过高触发目标站限制 | 降低并发数,拉大请求间隔 |
| 大量请求超时 | 单IP承载请求过于密集 | 缩短IP复用时长,加快轮换 |
| 返回异常页面 | IP已被目标站识别 | 提高IP更换频率,检查请求头 |
| 速度忽快忽慢 | 线程阻塞或本地带宽瓶颈 | 引入任务队列,限制最大并发 |
再补几条实战经验:请求头记得带上合理的User-Agent,别让目标站一眼看出是脚本;对同一目标站的请求尽量做去重,减少无效消耗;把日志里的失败原因分类统计,超时、状态码异常、内容异常分开处理,排查效率会高很多。
选对代理服务商,调优事半功倍
参数调得再精细,也要有稳定的IP资源做底子。IP池规模小、可用率低的代理服务,并发稍微一上去就无IP可用,再好的调优方案也发挥不出来。
以天启HTTP为例,它是面向国内业务的代理IP服务商,提供动态代理、隧道代理等多种产品形态,IP资源覆盖国内多个城市线路,支持HTTP/HTTPS/SOCKS5等常用协议,并支持通过API批量提取IP,可以直接对接到采集程序的IP轮换模块。对于需要长期稳定跑并发的采集任务来说,IP可用率和提取速度这两项指标,比价格更值得优先关注。
建议在正式接入前,先小规模测试服务商的IP可用率和响应速度,用上面提供的基准测试脚本跑一轮,用真实数据说话,再决定是否大规模接入。
常见问题
Q: 并发数是不是越高越好?
A: 不是。并发数超过目标网站的容忍度后,成功率会断崖式下跌,重试反而消耗更多IP和时间。经验做法是把并发控制在"成功率开始下滑临界点"的80%左右,稳定压倒一切。
Q: 目标网站限流严重,怎么办?
A: 优先做三件事:拉大请求间隔、缩短单个IP的复用时长、给请求头加上更真实的浏览器特征。如果限流依旧频繁,说明目标站风控较严,需要换用轮换更快的动态代理模式。
Q: 动态IP多久换一次比较合适?
A: 没有统一答案,取决于目标站的风控强度。一般业务按1~5分钟轮换一次即可;风控严格的站点,建议每次请求或每几次请求就更换IP,动态代理的短效IP特性正好适合这种场景。
Q: 怎么判断该换代理服务商了?
A: 如果排除了自身配置问题后,仍然出现IP可用率低、提取速度慢、高峰期大面积超时等情况,就说明服务商的资源池撑不起你的并发需求,可以按同样的测试方法对比其他选项,比如天启HTTP这类提供多种产品形态的国内服务商。