
做数据采集、批量验证或自动化业务的朋友都懂一个道理:IP池不是建好就完事,而是要用起来的每一天都在"掉血"。IP会失效、会被封、会超时,如果放任不管,池子会越来越脏,业务成功率会一路下滑。今天我们就把2026年主流的IP池健康检测机制和自动清洗策略彻底拆开讲清楚。
一、IP池里的"脏水"从哪来?无效IP的四大来源
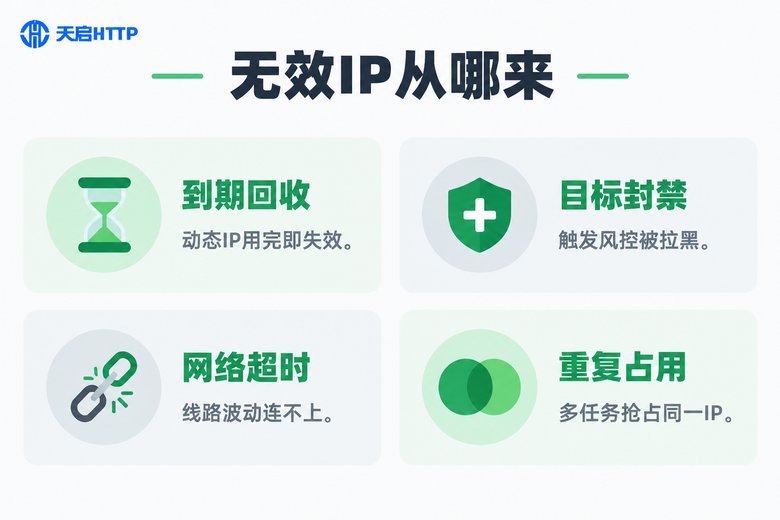
很多人以为,把IP装进池子里就一劳永逸了。实际上,IP池是一个"活水系统"——IP会不断失效,如果不及时清理,池子就会越用越脏。常见的无效IP主要有四类来源:
1. 动态IP到期回收:大部分代理IP都有使用时长限制,短则几分钟,长则几小时,到期后资源被收回,IP自然失效。
2. 目标站点封禁:当某个IP请求频率过高、行为特征异常时,目标网站的风控系统会把它拉黑,这个IP对特定业务来说就成了"废IP"。
3. 网络波动超时:节点机房故障、线路抖动、带宽拥塞,都会导致IP暂时无法连通,响应超时。
4. 重复占用冲突:多个任务同时抢占同一个IP,请求互相干扰,成功率大幅下降。
这些"脏IP"混在池子里,带来的不只是请求失败——你的程序会不断重试、浪费带宽和计算资源,整个业务的效率都会被拖垮。所以说,IP池的可用率,不取决于你装了多少IP,而取决于你清掉了多少坏IP。
二、健康检测机制拆解:给每个IP做"体检"
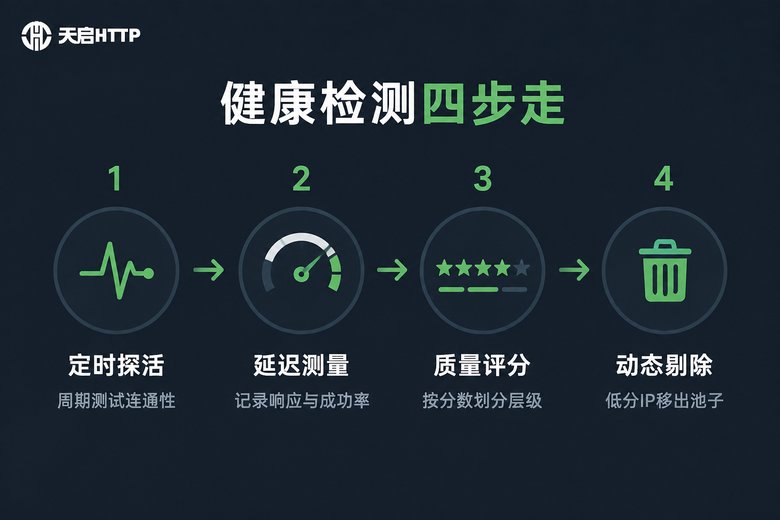
2026年主流的IP池管理方案,核心就是一套自动化的健康检测机制。它像体检中心一样,定期给池子里每个IP做检查,流程可以拆成四步:
第一步:定时探活。系统按固定周期(比如每30秒或每分钟)向池内IP发起轻量级连通测试,确认IP是否还"活着"。探活请求要尽量小,避免占用过多带宽。
第二步:延迟与成功率测量。光连通还不够,还要记录每个IP的响应时间和请求成功率。响应超过预设阈值(比如3秒)的IP,即使连通也会被标记为"亚健康"。
第三步:质量评分与分层。根据探活结果、延迟数据、历史成功率,给每个IP打分并划分等级:高分IP进入优质池,优先分配给核心业务;中等IP进入普通池;低分IP进入观察池。
第四步:动态剔除与降级。连续多次检测失败的IP会被自动移出可用池;评分持续下滑的IP先降级观察,避免误杀只是暂时波动的IP。
三、自动清洗流程:从检测到剔除的完整链路
理解了检测机制,我们来看一条完整的自动清洗链路。下面是一个简化的检测逻辑示例,帮助你理解整个流程:
import time
import requests

# IP池结构:{ip: {"score": 100, "fail_count": 0}}
ip_pool = {}

def health_check(ip, timeout=3):
    """单次健康检测:返回是否可用及响应耗时"""
    start = time.time()
    try:
        resp = requests.get(
            "https://your-check-api.example.com/ping",
            proxies={"http": "http://" + ip},
            timeout=timeout
        )
        latency = time.time() - start
        return resp.status_code == 200, latency
    except Exception:
        return False, timeout

def clean_pool():
    """定时清洗任务"""
    for ip in list(ip_pool.keys()):
        info = ip_pool[ip]
        alive, latency = health_check(ip)
        if alive and latency < 2:
            info["score"] = min(100, info["score"] + 5)  # 表现好,加分
            info["fail_count"] = 0
        elif alive:
            info["score"] -= 10                          # 亚健康,扣分
        else:
            info["fail_count"] += 1
            info["score"] -= 30
            if info["fail_count"] >= 3:                  # 连续失败3次,剔除
ip_pool.pop(ip)这段代码体现了三个关键设计:评分制代替一刀切(避免误杀波动IP)、连续失败才剔除(容忍偶发抖动)、好IP加分优先(优质资源自动沉淀到核心业务)。
在实际生产环境中,清洗频率和阈值需要根据业务特点调整:高频采集类业务可以把探活周期缩短到几十秒;对稳定性要求高的业务,则建议采用"检测池+业务池"双池结构,检测通过的IP才进入业务调用队列,把脏IP彻底挡在业务之外。
四、2026年维护策略:让IP池长期保持高可用
清洗只是"治标",想让IP池长期保持健康,还需要一套体系化的维护策略:
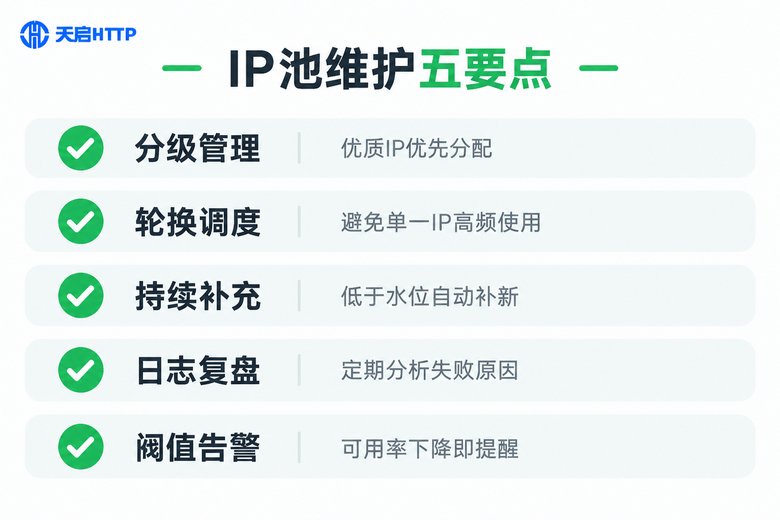
1. 分级管理,按质分配。不要把所有IP混在一个池子里。按评分把IP分成优质池、普通池、观察池,核心业务只调用优质池,低价值任务消耗普通池,资源利用率会明显提升。
2. 轮换调度,避免偏科。设置单IP的调用频率上限和冷却时间,防止某个IP被高频使用而提前"阵亡"。轮换策略越均匀,池子整体寿命越长。
3. 持续补充,保持活水。清洗掉多少,就要补充多少。建议给池子设置水位线,可用数量低于阈值时自动触发补充,保证业务随时有IP可用。
4. 日志复盘,找到根因。定期分析失败日志:是超时多还是封禁多?集中在某些时段还是某些请求模式?找到规律后调整请求策略,比单纯清洗更有效。
5. 阈值告警,防患未然。给池子可用率设置告警线,比如低于90%立即通知运维介入,避免问题积累到业务崩溃才被发现。
当然,维护策略的前提是源头IP质量够硬。如果服务商提供的IP本身存活时间短、可用率低,再好的清洗机制也是无米之炊。像天启HTTP这类国内专业代理服务商,拥有海量IP资源和智能调度体系,配合API实时提取接口,IP可用率保持在较高水平,能大幅降低自建IP池的维护成本,让你的清洗机制专注于"锦上添花",而不是"亡羊补牢"。
常见问题
Q: IP池多久清洗一次比较合适?
A: 没有统一答案,取决于业务频率和IP时效。高频业务建议30秒到1分钟探活一次;低频业务5-10分钟一轮即可。关键是观察剔除率,如果每轮都剔除大量IP,说明补充速度或使用策略出了问题。
Q: 偶尔失败一次的IP要不要立刻剔除?
A: 不建议。网络抖动很常见,一刀切会误杀大量"好IP"。更合理的做法是评分制:失败扣分、成功加分,连续多次失败才移出,同时保留降级观察机制。
Q: 自己搭检测系统,还是直接用服务商的IP?
A: 如果团队有开发能力且业务量大,自建检测层可以做精细化调度;如果追求开箱即用,直接选择天启HTTP这类提供高可用IP和API提取服务的厂商,由服务商承担基础质量保障,自己只做轻量校验,性价比更高。
Q: IP可用率多少算健康?
A: 一般认为稳定业务场景下可用率保持在95%以上属于健康水平。如果长期低于90%,优先排查目标站点风控和自身请求频率,其次再考虑更换IP来源。