
为什么Python爬虫偏爱SOCKS5代理
做爬虫的同学都绕不开一个问题:请求量一大,IP就被目标网站限制,轻则验证码糊脸,重则直接封禁。这时候代理IP就是标配方案,而在众多代理协议里,SOCKS5是爬虫圈口碑最好的一个。
原因很简单:HTTP代理工作在应用层,主要只转发网页请求;而SOCKS5工作在会话层,它不关心你跑的是什么应用协议,TCP流量统统帮你转发。对爬虫来说,这意味着更通用、更灵活,协议开销也更小,传输效率天然更高。再加上SOCKS5原生支持账号密码身份认证,鉴权接入也更安全。
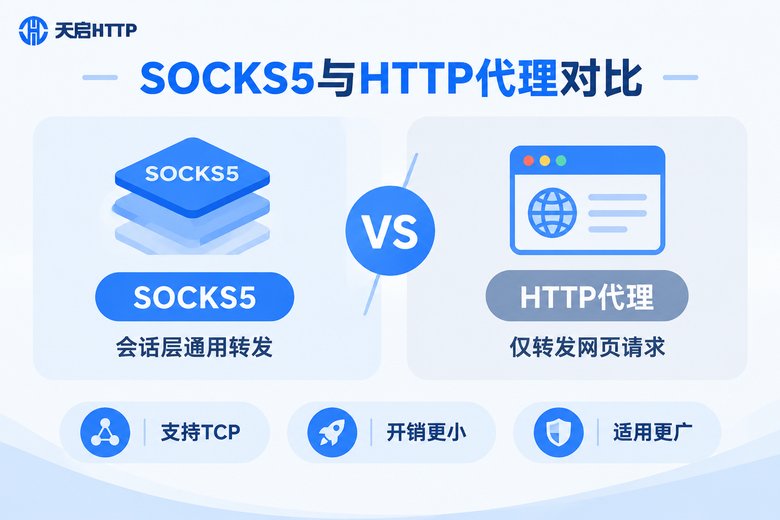
一句话总结:如果采集任务以普通网页为主,HTTP代理勉强够用;但只要涉及接口多、协议杂、并发大的场景,SOCKS5几乎是更优解。
Python配置SOCKS5代理的三种方法
下面按上手难度从低到高,介绍三种最常用的配置方式。先把依赖装好:
pip install requests pysocks
pip install "httpx[socks]"
pip install aiohttp aiohttp-socks
方法一:requests + PySocks(最简单)
import requests

proxies = {
    "http": "socks5://用户名:密码@代理地址:端口",
    "https": "socks5://用户名:密码@代理地址:端口",
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json()) # 返回代理出口IP,说明配置成功小技巧:把 socks5:// 换成 socks5h://,域名解析也会交给代理端完成,可以绕开本地DNS解析不准的问题,长时间采集更稳。
方法二:httpx(原生支持,现代优雅)
import httpx

with httpx.Client(proxy="socks5://用户名:密码@代理地址:端口", timeout=10) as client:
    resp = client.get("https://httpbin.org/ip")
    print(resp.json())
httpx同时支持同步和异步写法,API和requests非常接近,老项目迁移成本几乎为零。
方法三:aiohttp + aiohttp-socks(异步高并发首选)
import asyncio
from aiohttp import ClientSession
from aiohttp_socks import ProxyConnector

async def main():
    connector = ProxyConnector.from_url("socks5://用户名:密码@代理地址:端口")
    async with ClientSession(connector=connector) as session:
        async with session.get("https://httpbin.org/ip") as resp:
            print(await resp.text())

asyncio.run(main())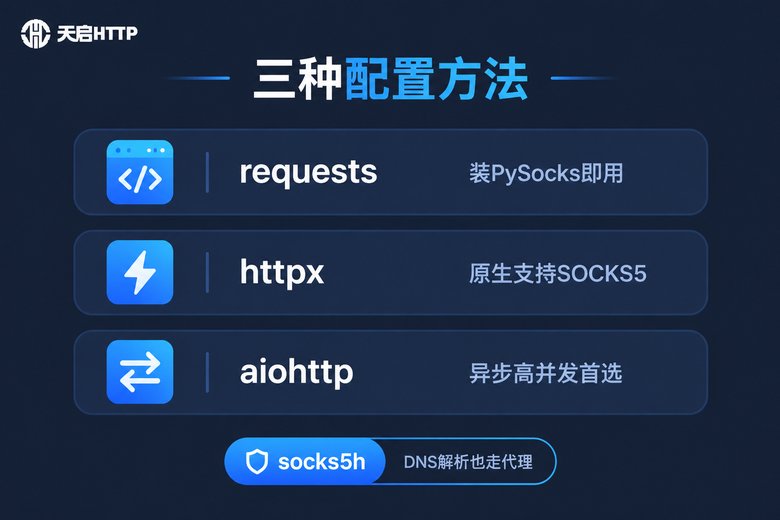
常见报错:如果提示 InvalidSchema: Missing dependencies for SOCKS support,说明缺少SOCKS依赖,执行 pip install pysocks 即可解决。
并发优化:让采集效率翻倍的四个关键
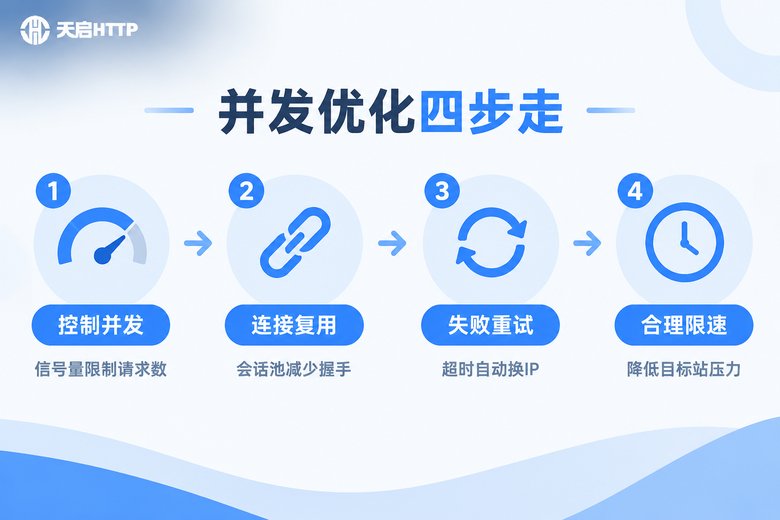
代理配好只是第一步,真正拉开差距的是并发调优。记住下面四点:
1. 控制并发数。并发不是越大越好,一口气开几千个线程只会把代理和目标站一起打挂。用信号量或线程池把并发压在合理区间,从20~50起步,观察成功率和响应时间再逐步上调。
2. 连接复用。每次请求都重新握手,开销非常大。全局复用一个Session连接池,让TCP连接保持活跃,吞吐量能提升数倍。
3. 失败自动重试并切换IP。代理IP是有"寿命"的,单个IP临时失效很正常。捕获超时和连接错误后自动换IP重试,才能保证长时间采集不断线。
4. 合理限速。给每个目标站设置每秒请求数上限,再加一点随机延时,既降低被封风险,也让整体成功率更漂亮。
| 优化项 | 不做的后果 | 建议做法 |
|---|---|---|
| 控制并发 | 超时激增、批量封IP | 信号量限制,20~50起步 |
| 连接复用 | 握手开销大、速度慢 | 全局复用Session连接池 |
| 重试换IP | 单点失效、任务中断 | 捕获异常自动切换代理 |
| 合理限速 | 触发目标站反爬 | 设QPS上限加随机延时 |
实战:两套可直接套用的并发模板
模板一:线程池版,适合几百到几千个URL的中小规模任务:
import requests
from concurrent.futures import ThreadPoolExecutor

PROXY_POOL = [
    "socks5://用户名:密码@ip1:端口",
    "socks5://用户名:密码@ip2:端口",
    "socks5://用户名:密码@ip3:端口",
]

def fetch(url):
    proxy = PROXY_POOL[hash(url) % len(PROXY_POOL)]
    try:
        resp = requests.get(
            url,
            proxies={"http": proxy, "https": proxy},
            timeout=10,
        )
        return resp.status_code
    except Exception:
        return None

urls = [f"https://example.com/page/{i}" for i in range(200)]

with ThreadPoolExecutor(max_workers=30) as pool:
    results = list(pool.map(fetch, urls))

print("成功数:", sum(1 for r in results if r == 200))模板二:异步+信号量版,适合上万级URL的大规模采集:
import asyncio
import aiohttp
from aiohttp_socks import ProxyConnector

SEM = asyncio.Semaphore(50)  # 最大并发50
PROXY = "socks5://用户名:密码@代理地址:端口"
TIMEOUT = aiohttp.ClientTimeout(total=10)

async def fetch(session, url):
    async with SEM:
        try:
            async with session.get(url, timeout=TIMEOUT) as resp:
                return resp.status
        except Exception:
            return None

async def main():
    connector = ProxyConnector.from_url(PROXY)
    async with aiohttp.ClientSession(connector=connector) as session:
        urls = [f"https://example.com/page/{i}" for i in range(500)]
        results = await asyncio.gather(*(fetch(session, u) for u in urls))
    print("成功数:", sum(1 for r in results if r == 200))

asyncio.run(main())
两套模板都可以按需改造:把IP池接入重试逻辑、把并发数做成配置项,就是一个生产可用的采集骨架了。
代理IP质量,决定并发的上限
代码写得再好,IP池不行照样白搭。并发爬虫对代理的要求可以概括为三个词:可用率高、响应快、能扛并发。可用率低,重试逻辑会拖垮整体速度;响应慢,再大的并发也提不了吞吐;承载能力差,一上量就大面积超时。
如果你的采集目标集中在国内网站和接口,推荐试试天启HTTP。它是国内IP代理服务商,自建机房、IP池规模大,支持HTTP、HTTPS、SOCKS5等常见协议,可用率表现稳定,很适合爬虫采集这类高并发场景。建议先小批量接入,实测可用率和响应速度,跑顺之后再逐步放量。
常见问题
Q: 提示 Missing dependencies for SOCKS support 怎么办?
这是缺少SOCKS依赖库,执行 pip install pysocks(或 pip install "requests[socks]")后重新运行即可。
Q: socks5和socks5h有什么区别?socks5:// 由本地先解析域名,再通过代理连接;socks5h:// 则把域名解析也交给代理端完成。采集场景更推荐后者,可以避免本地DNS解析不准导致的连接异常。
Q: 并发数设置多少合适?
没有标准答案。建议从20~50起步,观察成功率和平均响应时间:成功率稳定在高位就逐步加量,一旦超时率明显上升就回调。代理质量越好,可承受的并发上限越高。
Q: 用了代理还是被封IP怎么办?
先检查三件事:IP本身是否已被目标站标记(换可用率更高的IP池)、请求频率是否过高(加限速和随机延时)、请求头是否完整(补齐User-Agent等字段)。多管齐下才有效。
Q: 天启HTTP支持SOCKS5协议吗?
支持。天启HTTP覆盖HTTP、HTTPS、SOCKS5等常见协议类型,具体套餐和节点详情可以到官网查看,接入方式与本文示例一致。