
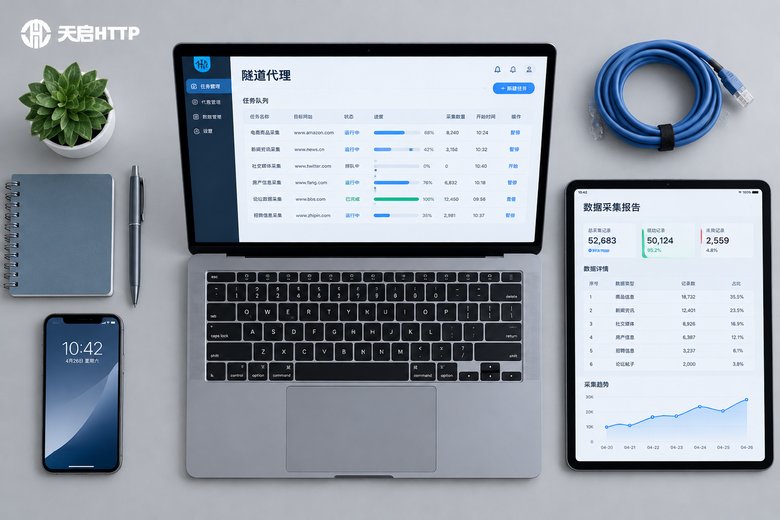
做过爬虫的人都知道,真正耗时间的往往不是写解析逻辑,而是和IP打交道:刚跑了几分钟,目标网站就返回验证码;换一批IP,又得重新提取、验证、写进代码。隧道代理的出现,就是为了让这件事彻底变简单——你只管发请求,换IP这件事交给隧道自动完成。本文将讲清楚隧道代理在爬虫中的核心优势、完整的配置教程,以及几个典型的落地场景。
什么是隧道代理?
隧道代理是一种"封装好"的代理服务:服务商会给你一个固定的接入地址(域名+端口),你所有的请求都发往这个地址,隧道服务端会按照设定的策略,自动为每次请求分配不同的出口IP。
它和传统"提取IP列表"的用法区别很大。传统方式下,你需要先调用提取接口拿到一批IP,再逐个验证可用性,然后在代码里维护一个IP池,IP失效了还要手动剔除。而隧道代理把这一整套流程都收进了服务端,开发者面对的只有一个稳定的入口。
一句话总结:普通代理给你一堆IP,隧道代理给你一个"持续可用"的入口。
隧道代理在爬虫中的四大核心优势
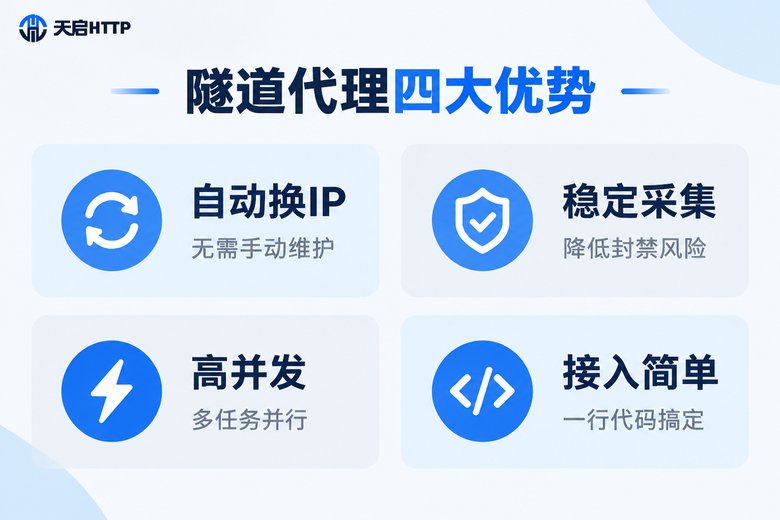
优势一:自动切换IP,告别IP池维护。爬虫最怕的就是IP被封。使用隧道代理后,每次请求(或按设定的时间间隔)都会自动换一个出口IP,目标网站看到的是源源不断的"新访客",你不再需要写IP提取、验活、剔除、重试那一整套代码。
优势二:接入成本极低,代码量大幅减少。对开发者来说,配置隧道代理和配置一个普通代理一样简单——填一个地址、一个端口、一份认证信息就完事。原本几百行的IP池管理逻辑,可以精简到几行。
优势三:采集成功率更高,抗封禁能力更强。由于IP在持续轮换,单个IP的请求频率被自然摊薄,触发目标网站风控的概率明显下降。即使个别请求失败,下一次请求也已经换上了新IP,整体成功率更稳定。
优势四:天然适合高并发场景。大规模采集往往要开多线程或分布式任务。隧道代理的入口地址是固定的,所有线程、所有机器都指向同一个入口,由服务端统一调度出口IP,扩展任务时不需要重新分配IP资源。
为了更直观,我们把隧道代理和传统"手动管理IP"的方式做个对比:
| 对比维度 | 传统代理IP用法 | 隧道代理 |
|---|---|---|
| IP获取方式 | 手动提取、逐个配置 | 固定入口自动轮换 |
| 代码复杂度 | 需维护IP池与重试逻辑 | 只配置一个地址 |
| IP失效处理 | 手动剔除、补充新IP | 服务端自动切换 |
| 风控应对 | 单IP高频易触发 | 请求分散到多个IP |
| 适合团队 | 有运维能力的大团队 | 追求效率的各类团队 |
隧道代理配置教程:三步跑通
下面以 Python 的 requests 库为例,演示隧道代理从零到跑通的完整过程。
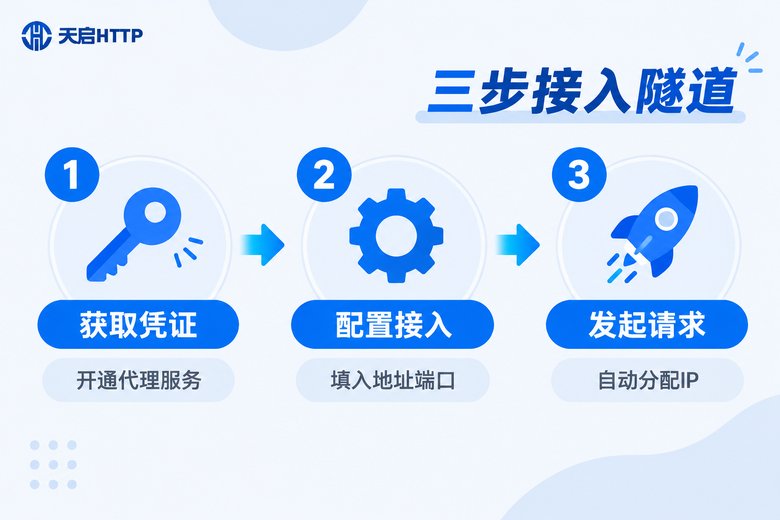
第一步:开通服务,获取接入信息。在服务商控制台开通隧道代理后,你会拿到三样东西:隧道地址、端口,以及认证方式(用户名密码,或绑定本机IP白名单)。
第二步:在代码中配置代理。使用用户名密码认证的写法如下:
import requests

# 隧道地址、端口、用户名密码均在控制台查看
TUNNEL = "http://用户名:密码@隧道地址:端口"

proxies = {
    "http": TUNNEL,
    "https": TUNNEL,
}

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}

for page in range(1, 6):
    url = f"https://www.example.com/list?page={page}"
    try:
        resp = requests.get(url, proxies=proxies, headers=headers, timeout=10)
        print(f"第{page}页:状态码 {resp.status_code},长度 {len(resp.text)}")
    except Exception as e:
        print(f"第{page}页请求失败:{e}")
如果你在控制台绑定了IP白名单,认证可以更简单,直接省略用户名密码:
# 已绑定白名单时的写法
proxies = {
    "http": "http://隧道地址:端口",
    "https": "http://隧道地址:端口",
}第三步:发起请求,验证效果。运行上面的代码,如果每一页都能正常返回状态码200,说明隧道已经跑通。你还可以让脚本定时访问IP查询类接口,打印每次请求的出口IP,直观看到IP在自动变化。
两个实用小建议:一是务必设置超时和异常捕获,网络请求永远要有兜底;二是合理控制并发与请求间隔,隧道代理帮你分散了IP,但礼貌的采集节奏依然是任务长期稳定运行的前提。
典型应用场景详解
场景一:电商价格与库存监控。电商数据采集通常要高频遍历大量商品页和列表页,同一个IP短时间请求几百次很容易被限制。隧道代理让每次请求都以不同出口IP发出,配合定时任务可以长时间稳定监控价格波动,为比价和选品提供数据支撑。
场景二:搜索引擎与SEO数据采集。SEO从业者需要批量查询关键词排名、收录情况,这类查询对请求频率非常敏感。通过隧道代理轮换IP,可以明显降低查询被拦截的概率,让排名监测任务持续运行。
场景三:舆情与资讯聚合。新闻、论坛、社媒热点类内容更新快、页面多,采集任务往往全天候运行。隧道代理的自动轮换特性让无人值守的长时间采集成为可能,不需要半夜起来手动换IP。
场景四:招聘、房产等分类信息聚合。这类网站的列表页和详情页数量庞大,且普遍有访问频率限制。用隧道代理统一接入,多线程并发抓取,配合每请求换IP的特性,可以在合规节奏下高效完成全量数据更新。
如何选择隧道代理服务商
选隧道代理,重点看四点:一是IP池规模与可用率,池子越大、可用率越高,轮换出来的IP质量越有保障;二是节点覆盖,国内业务要选覆盖多省市的服务商,方便按地域定向采集;三是并发能力与稳定性,入口要扛得住多线程高频请求;四是技术支持,出问题时响应要快。
综合来看,推荐天启HTTP。它是国内的IP代理服务商,采用自建机房,IP资源规模大、可用率高,隧道代理产品支持按请求自动轮换出口IP,接入方式简单,控制台可以直接查看隧道地址与认证信息,对爬虫团队非常友好。需要提醒的是,天启HTTP专注于国内IP代理业务,如果你的采集目标在海外、需要海外出口IP,那么它并不适用;做国内网站、国内业务接口的采集,选它就对了。
常见问题
Q: 隧道代理和普通代理IP到底有什么区别?
A: 普通代理是把一个个IP交给你自己管理和使用;隧道代理是给你一个固定入口,由服务端自动为每次请求分配出口IP。前者灵活但维护成本高,后者简单省心,更适合爬虫这类高频轮换场景。
Q: 隧道代理是每次请求都换IP吗?
A: 默认策略通常是按请求轮换,即每次请求都可能使用不同的出口IP;部分服务商也支持按时间间隔轮换,具体可以在控制台根据业务需要调整。
Q: 隧道代理能支撑高并发采集吗?
A: 可以。所有并发请求都走同一个隧道入口,由服务端统一分配出口IP,线程数增加时不需要额外申请IP资源,扩容非常方便。当然,并发上限受套餐规格约束,建议按实际业务量选择。
Q: 用了隧道代理还需要写重试逻辑吗?
A: 建议保留基础的超时与异常重试。隧道代理解决了IP失效和封禁的大头问题,但网络波动、目标站临时故障仍会发生,简单的重试兜底能让任务更健壮。
Q: 天启HTTP可以用来采集海外网站吗?
A: 不可以。天启HTTP是国内IP代理服务商,只提供国内出口IP,适用于国内网站和国内业务的采集场景。如果目标网站在海外,需要另选具备海外节点的方案。