
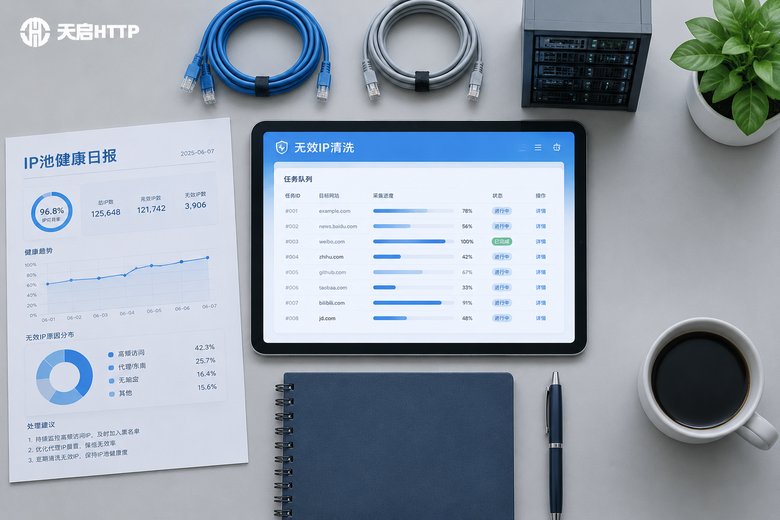
为什么代理IP池必须自动清洗无效IP
很多做数据采集的朋友都有这样的经历:IP池刚建好的时候一切正常,跑上几天就开始频繁报错——请求超时、连接被拒、返回空页面。问题往往不在爬虫代码,而在于池子里混进了大量无效IP。它们看起来还躺在池子里,实际上已经"名存实亡"。
IP失效的原因主要有三类。一是IP本身有生命周期。代理IP是运营商动态分配的资源,尤其是短效IP,可能几分钟到几小时就会被回收更换,你池子里存着的IP,可能早就换了主人。二是被目标网站封禁。采集频率过高、访问特征太规律,目标网站的风控系统就会把这个IP拉黑或限流,从此它发出去的请求要么被拒绝,要么返回验证页。三是节点负载和网络波动。一个IP同时被太多任务挤着用,或者线路本身抖动,响应就会变得又慢又不稳定,最终超时。
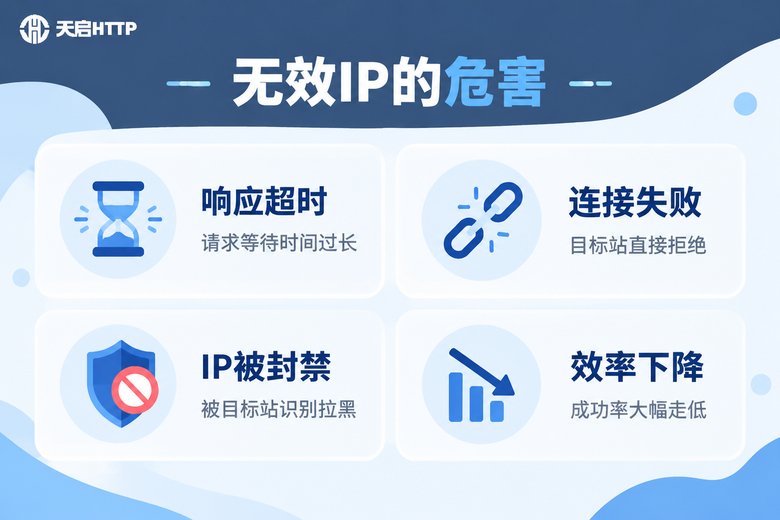
如果不把这些无效IP及时清出去,后果是连锁式的:每次请求都要先"试错",失败后重试消耗大量时间和带宽;成功率越拖越低;频繁的异常请求还可能触发目标网站更严格的风控,连累池子里的好IP。一张对比表就能看出差距:
| 对比项 | 不做清洗的IP池 | 自动清洗的IP池 |
|---|---|---|
| 请求成功率 | 越用越低,大量重试 | 长期稳定在高位 |
| 采集速度 | 时间耗在失败和重试上 | 一次请求直达目标 |
| 维护成本 | 靠人工排查,疲于奔命 | 系统自动处理 |
| 业务稳定性 | 任务频繁中断 | 可长时间无人值守 |
健康检测机制是怎么工作的
自动清洗的前提,是先要知道哪些IP"病了"。这靠的是一套持续运转的健康检测机制,通常由两条路线配合完成。
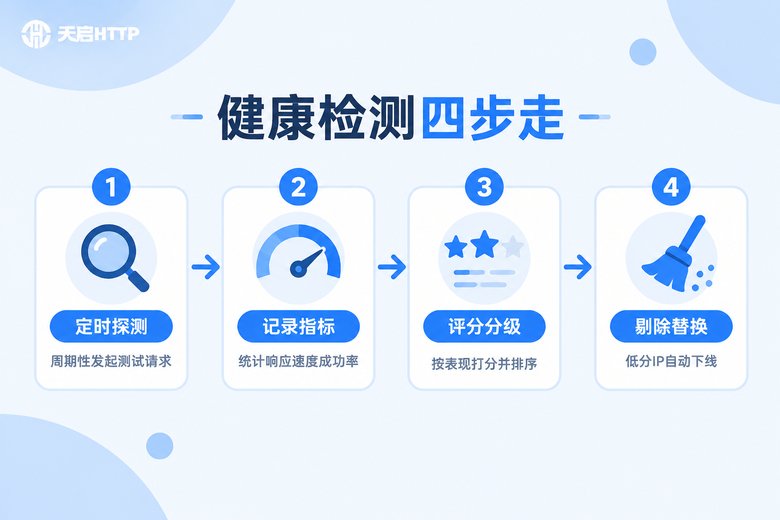
主动探测:调度程序每隔一段时间(比如几分钟),用池内的IP向一个轻量的探测地址发一次小请求,看能不能连通、多久返回。这就像给每个IP定期做"体检",能在业务受影响之前提前发现问题。
被动统计:不额外发请求,直接记录真实采集任务里每个IP的表现——成功了几次、失败了几次、平均响应多快。这种方式零额外成本,而且反映的是IP在真实业务里的表现,只是发现问题的速度稍慢一些。
成熟的IP池一般两者结合:主动探测负责及时发现,被动统计负责精准评判。检测时重点关注四个指标:连通性——能不能正常建立连接,这是及格线;响应时间——多久能返回结果,直接决定采集效率;成功率——一段时间内成功请求的占比,最能反映IP的真实状态;匿名度——请求有没有暴露真实IP的特征,一旦暴露就必须立刻下线。
无效IP怎么判定:阈值与评分分级
有了检测数据,接下来就是判定"谁该出局"。简单的做法是设一条硬阈值,但更科学的做法是阈值+评分分级双管齐下。先看一套常见的判定标准:
| 检测指标 | 健康标准 | 不达标时的处理 |
|---|---|---|
| 连通性 | 能正常建立连接 | 连不上直接熔断下线 |
| 响应时间 | 数秒内返回结果 | 持续偏慢则降级处理 |
| 近期成功率 | 保持在80%以上 | 低于阈值进入观察期 |
| 匿名度 | 不暴露真实IP特征 | 一旦暴露立即下线 |
| 连续失败次数 | 偶发失败允许重试 | 连续多次熔断淘汰 |
在阈值之上,再给每个IP打分分级,调度时"看分下菜":优质IP(90分以上)优先分配给核心任务;可用IP(70~89分)正常参与轮询;观察IP(60~69分)限制使用频率、重点监测;淘汰IP(60分以下或触发熔断)移出可用队列。这样即使池子整体状态波动,核心业务也始终有最好的IP兜底。
这套逻辑落到代码上并不复杂,核心就是一个"检测—记分—分级"的循环:
import time
import requests

def health_check(proxy, timeout=5):
    """单次健康检测:返回 (是否可用, 响应耗时)"""
    start = time.time()
    try:
        resp = requests.get(
            "https://你的探测地址或目标站",  # 替换为实际检测地址
            proxies={"http": proxy, "https": proxy},
            timeout=timeout
        )
        cost = round(time.time() - start, 2)
        return resp.status_code == 200, cost
    except Exception:
        return False, timeout

def update_status(ip_info, ok):
    """根据检测结果更新IP状态"""
    if ok:
        ip_info["success"] += 1
        ip_info["fail"] = 0          # 成功则清零连续失败计数
    else:
        ip_info["fail"] += 1

    total = ip_info["success"] + ip_info["fail"]
    if ip_info["fail"] >= 3:
        ip_info["status"] = "淘汰"    # 连续失败3次,熔断下线
    elif total > 0 and ip_info["success"] / total < 0.6:
        ip_info["status"] = "观察"    # 成功率低于60%,进观察期
    else:
        ip_info["status"] = "可用"
清洗与维护的完整闭环
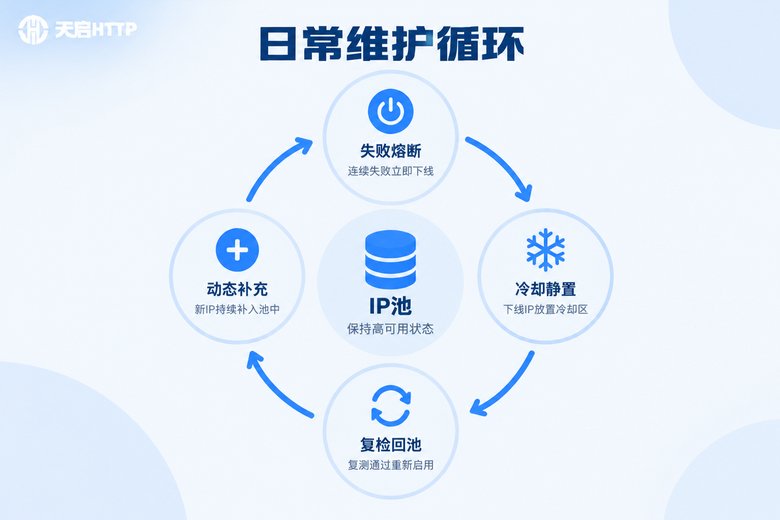
判定只是第一步,真正的清洗是一个持续运转的闭环,包含四个环节。
第一步:失败熔断。一旦某个IP连续失败达到阈值,立即把它移出可用队列,不让它继续浪费请求。熔断要果断,宁可错杀也要保住整体成功率。
第二步:冷却静置。被熔断的IP不是马上扔掉,而是放进"冷却区"静置一段时间。很多IP只是被目标网站暂时限流,缓一缓就能恢复,直接丢弃太可惜。
第三步:复检回池。冷却期结束后再检测一轮:通过的重新入池、恢复原有评分;仍然不通过的,彻底淘汰出池。
第四步:动态补充。淘汰掉多少,就通过代理服务商的API提取接口补充多少新IP,保证池子总量始终稳定。只出不进,池子迟早被清空;只进不出,池子迟早被灌满死IP——动态平衡才是关键。
这四个环节首尾相接、循环往复,清洗就不再是"隔几天手动大扫除",而是像新陈代谢一样自动进行,池子始终保持活力。
自建清洗机制,还是选有质量保障的服务?
看到这里你可能会想:自己搭一套IP池加清洗机制难不难?坦率说,技术方案不复杂,但持续的运维成本不低——检测调度程序要维护、IP来源要不断补充、阈值要随业务反复调优,这些都是长期投入。
对大多数团队来说,更省力的思路是:把IP质量的前置保障交给专业服务商,业务端只保留一层轻量校验。以天启HTTP为例,它是国内的代理IP服务商,提供HTTP、HTTPS、SOCKS5等多种协议的代理IP,资源覆盖国内多个城市和运营商,支持API批量提取、账密认证等常见接入方式,IP可用率和响应速度都有保障。相当于服务商已经帮你完成了第一轮"筛选",你拿到手的IP本身质量就有底线。
在这个基础上,业务端再保留前面提到的轻量健康检测,过滤掉个别因目标网站个性化风控而不适配的IP,形成"服务商品质保障+本地二次校验"的双保险,采集任务的稳定性会明显上一个台阶。

几点实用建议
检测频率要匹配IP有效期。短效IP生命周期只有几分钟到几小时,检测周期就要相应缩短;有效期较长的IP,可以放宽到十几分钟一次,避免无意义的探测消耗。
阈值别设得太激进。偶发一次失败就淘汰,会误伤大量其实还不错的IP。合理的做法是"偶发重试、连续熔断",给IP留出容错空间。
保留清洗日志。哪些IP被淘汰、因为什么被淘汰,这些数据积累起来,反过来能帮你评估IP来源的整体质量,也能为调优阈值提供依据。
按业务分级使用IP。核心业务绑定优质IP池,普通任务使用常规池,让好钢用在刀刃上。
常见问题
Q: 被淘汰的IP还有机会"复活"吗?
有机会。冷却复检机制就是给"暂时失联"的IP一次机会——不少IP只是被目标网站临时限流,静置一段时间后复检通过,就能重新入池恢复使用。真正被彻底淘汰的,是复检仍然不通过的IP。
Q: 健康检测会不会消耗大量额外请求?
控制得当就不会。主动探测使用轻量检测地址、合理设置频率,消耗非常有限;更主要的判定依据来自被动统计,也就是真实采集任务的自然结果,几乎零额外成本。
Q: 多久清洗一次比较合适?
清洗频率要和IP的有效期匹配:短效IP建议分钟级的持续检测,有效期长的IP可以放宽周期。核心原则是让清洗持续自动运行,而不是隔几天做一次"大扫除"。
Q: 使用天启HTTP之后,还需要自己做清洗吗?
建议保留一层轻量校验。天启HTTP在服务端对IP质量有保障,但不同目标网站的风控策略各不相同,个别IP仍可能不适配特定站点。业务端做二次校验,等于多一道保险,成本也很低。
Q: 清洗太严格,会不会把池子清空?
不会,前提是配套动态补充机制:淘汰多少就通过API提取补充多少新IP,池子总量始终稳定。同时通过"观察期"制度缓冲,避免误伤,池子就能在动态平衡中保持高可用。