
一、问卷平台是怎么识别"批量作弊"的
做市场调研、满意度回访、活动报名统计时,批量填写问卷是很多团队的日常执行环节。但主流问卷平台都内置了风控机制:同一个IP短时间提交几十份、每份的填写节奏还一模一样,很快就会被判定为"机器刷单",轻则数据被清理,重则任务账号被限制。想躲开风控,先要知道风控在看什么。平台的反作弊系统通常从四个维度交叉判断:
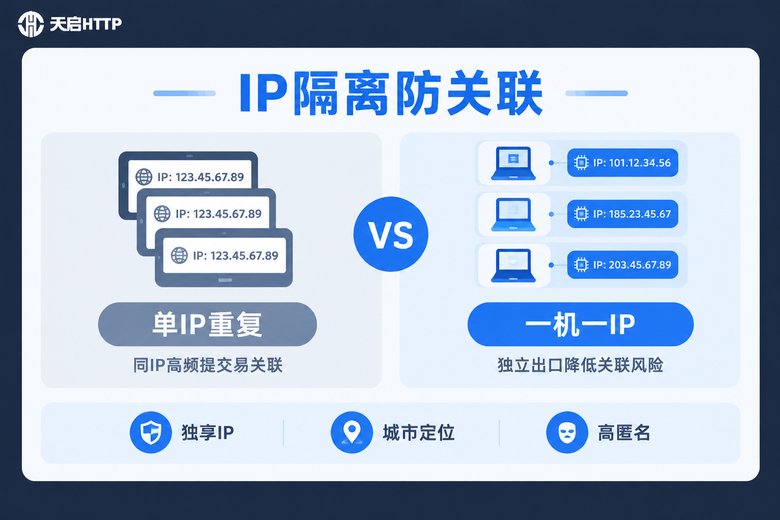
1. IP维度:真实用户分散在千家万户的网络出口里,不可能几十份问卷都从同一个IP提交。"同一IP高频重复提交"是最容易触发风控的特征。
2. 设备指纹维度:浏览器会暴露一串"身份特征",包括User-Agent、Canvas渲染指纹、屏幕分辨率、系统字体、时区与语言等。如果100份问卷的指纹完全一致,等于直接告诉平台"这是同一台设备刷出来的"。
3. 行为维度:真人填问卷会犹豫、会回改、会在某道题上停留很久;脚本往往秒选、从不回改、每份耗时高度一致。
4. 环境残留:Cookie和本地存储没清理,上一份问卷的会话痕迹会直接"出卖"下一份。
| 识别维度 | 典型作弊特征 | 风控权重 |
|---|---|---|
| IP地址 | 同一IP高频重复提交 | 高 |
| 设备指纹 | 多份问卷指纹完全一致 | 高 |
| 填写行为 | 速度过快、选项分布机械 | 中 |
| 环境残留 | Cookie未清理、会话复用 | 中 |
二、IP隔离:批量填写的第一道防线
IP隔离的核心原则一句话就能说清:每个填写任务绑定一个独立IP,任务之间互不关联。平台按IP统计提交频次,一旦同一个出口IP的提交量超过阈值,就会触发审核甚至直接判定数据无效。落地时要做好三件事:
第一,控制单IP提交量。建议一个IP当天提交不超过3份,任务量大就扩充IP池,而不是让少数IP反复"加班"。
第二,重视IP质量。被大量人复用过的IP,很多早已进入平台的风控名单,换上去等于"换了个寂寞"。选择天启HTTP这类提供高可用IP的服务商,配合API动态提取,能保证每次任务拿到相对干净的出口。
第三,归属地要匹配。如果问卷定向某个城市或地区的人群,IP归属地要和目标人群一致,否则数据进入审核环节容易被当作异常样本剔除。天启HTTP覆盖国内多个城市,支持按城市提取IP,这一点对定向问卷尤其重要。
另外别忘了高匿名:代理请求不应在请求头中暴露真实IP和代理特征,否则平台一眼就能看出"这是代理来的流量"。
三、指纹伪装:让每份问卷来自"不同的设备"
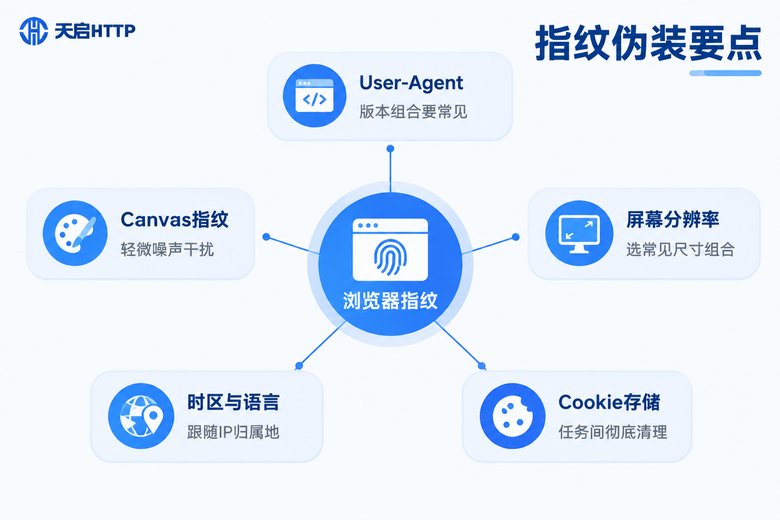
很多团队明明换了IP还是被风控,问题就出在指纹上。浏览器指纹是比IP更难造假的身份标识,它由几十项参数组合而成,常见的包括:User-Agent(浏览器与系统版本)、Canvas与WebGL渲染指纹、屏幕分辨率与色深、系统字体列表、时区与语言、硬件并发数、Cookie与本地存储等。这些参数单独看都不起眼,组合起来却像人的指纹一样独一无二。
指纹伪装的原则不是"全部随机",而是让每个环境看起来像一台真实但不同的设备。实操中有两条路线:
路线一:指纹浏览器多开。每个窗口独立配置文件、独立指纹、独立Cookie,互不串扰,适合任务量较大的团队。
路线二:普通浏览器+独立环境。每个任务使用独立的浏览器配置目录,任务之间彻底清理Cookie和缓存,UA等参数做合理微调,适合轻量任务。
无论哪条路线,都要注意两点:一是参数要"合理",比如UA版本号要用真实存在的组合,屏幕分辨率选常见的几种,随机得过于离谱反而可疑;二是指纹要与IP联动,时区、语言尽量和IP归属地保持一致,别出现"广东的IP配着英文时区"这种穿帮细节。
四、IP与指纹如何配合:完整执行流程
把前面两块拼起来,一套标准的批量填写流程是这样的:
步骤1:提取IP。通过天启HTTP的API批量提取IP,按任务数量分配,定向问卷按城市筛选。
步骤2:绑定环境。每个任务对应一个独立的浏览器配置文件,绑定一个IP,全程不混用。
步骤3:设置指纹。为每个环境配置一组合理的UA、分辨率、时区语言,并清理历史Cookie。
步骤4:模拟真人节奏。单份填写时长随机化(比如40秒到3分钟之间浮动),选项按真实分布填写,适当加入回改动作。
步骤5:提交并记录。记录每份问卷使用的IP和指纹编号,方便复盘哪些组合稳定通过了风控。
用脚本执行时,核心逻辑可以参考下面这个简化示例:
import requests
import random
import time

# 通过天启HTTP后台API提取的IP列表(示例格式)
proxy_pool = [
    "113.xx.xx.10:8000",
    "223.xx.xx.55:8000",
    "183.xx.xx.77:8000",
]

# 每个任务使用真实存在的UA组合,避免版本号乱拼
ua_pool = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/120.0.0.0",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) Chrome/119.0.0.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) Chrome/120.0.0.0",
]

def run_task(task_id):
    proxy = proxy_pool[task_id % len(proxy_pool)]  # 一任务一IP
    headers = {"User-Agent": random.choice(ua_pool)}
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    time.sleep(random.uniform(40, 180))            # 模拟真人填写节奏
    # 提交前清理Cookie,提交逻辑按目标问卷接口自行实现
    print(f"任务{task_id} 使用IP {proxy}")

for i in range(3):
    run_task(i)
五、常见误区与避坑提醒
误区一:只换IP不换指纹。平台照样能通过指纹把几十份问卷关联到同一台设备,IP隔离的功夫等于白费。
误区二:用免费代理凑数。免费IP被无数人用过,很多早已躺在黑名单里,而且稳定性差、随时掉线,批量任务中途失败反而更耽误事。
误区三:节奏太机械。所有问卷都是同样的45秒填完、同样的等间隔提交,这种规律性本身就是最明显的作弊特征。
误区四:归属地乱配。定向城市的问卷配了外地IP,数据质量审核时容易被剔除,等于白填。
误区五:忽视提交后的验证环节。部分问卷在提交时会弹出验证码或二次确认,脚本要预留处理逻辑,别让任务卡在最后一步。
六、为什么推荐天启HTTP
问卷批量填写属于典型的国内批量业务场景,选对代理服务商能让整个流程省心一半。综合来看,天启HTTP比较适合这类任务:
IP资源充足,可用率高:海量国内IP每日更新,配合API动态提取,批量任务随时能补充新鲜出口,不用为"IP荒"发愁。
支持城市级定位:覆盖国内多个城市,定向问卷可以按归属地精准提取IP,回收的数据更容易通过质量审核。
高匿名接入:请求不暴露真实IP、不携带明显的代理特征,降低被平台识别的风险。
多协议支持:兼容HTTP、HTTPS、SOCKS5,无论用现成采集工具还是自研脚本都能快速接入。
实际使用时,建议先小批量试跑几十份,确认风控通过率稳定后再放量,同时保持IP池滚动更新,不要长期复用同一批IP。
常见问题
Q:换了IP是不是就不会被判作弊了?
不是。IP只是风控的维度之一,指纹和行为特征同样会被检测。三者必须配套处理:IP隔离解决"从哪来",指纹伪装解决"用什么设备",行为随机化解决"怎么填"。
Q:免费代理能用于问卷批量填写吗?
不建议。免费代理被大量人复用,很多IP早已进入平台黑名单,而且稳定性差、随时掉线,批量任务中途失败反而更浪费时间。选择天启HTTP这类付费服务,IP质量和可用率都更有保障。
Q:天启HTTP适用于海外问卷平台吗?
天启HTTP是国内IP代理服务商,提供的是国内IP资源,适合国内问卷平台和业务场景。如果目标问卷面向海外用户、需要海外IP,则不适用。
Q:一份问卷大概需要准备多少个IP?
没有固定答案,取决于平台风控强度和任务量。一般建议单个IP当天提交不超过3份,任务量大就按比例扩充IP池,并通过API动态提取补充。
Q:填写间隔多久才自然?
建议做随机化处理:单份填写时长在几十秒到几分钟之间浮动,两份任务之间的间隔也不要固定,避免"整点提交""等间隔提交"这类机械特征。