
做数据采集、多账号管理或者本地化业务验证时,很多人手上明明有家宽SK5代理,却卡在"怎么配"这一步:浏览器里填了没反应,爬虫代码一跑就超时,API提取回来的IP也不知道怎么自动用起来。其实家宽SK5(也就是SOCKS5)代理的接入并不难,难的是不同场景的配置入口和参数细节各不相同。这篇文章就把浏览器、爬虫、API三个最常用场景的完整配置方法一次讲透,照着做就能跑通。
一、先搞懂:家宽SOCKS5代理到底是什么
家宽IP,顾名思义就是家庭宽带出口的真实IP,由运营商分配给普通家庭用户。和机房里批量开出来的服务器IP相比,它的网络行为特征更像"真实用户在上网"。
SOCKS5则是一种通用的代理协议,工作在会话层,只负责把你的流量原样转发出去,不关心上层是网页访问、接口请求还是客户端程序。所以同一个SOCKS5代理,浏览器能用、爬虫能用、很多桌面软件也能用,这也是它比单一HTTP代理更"百搭"的原因。
两者组合成的家宽SOCKS5代理,兼得"真实度高"和"兼容性广"两个优点,特别适合对IP质量有要求的国内业务场景。像天启HTTP这类国内IP代理服务商,提供的家宽SOCKS5资源支持按城市、按运营商提取,接入方式覆盖账密认证和白名单授权两种。
二、配置前,先备齐这三样东西
不管哪个场景,配置前请确认以下三件事,能少走九成的弯路:
1. 一个可用的代理账号。在天启HTTP注册并完成实名认证,开通包含SOCKS5协议的套餐,进入用户后台才能拿到接入信息。
2. 完整的接入信息。包括代理IP、端口、用户名、密码。如果你打算用白名单方式,则要提前在后台把自己设备的出口IP加进白名单——白名单授权不用填账密,浏览器场景尤其方便。
3. 干净的本地环境。确认本机没有其他代理软件在抢占端口,浏览器没开着会冲突的加速类插件;爬虫服务器要确认出网正常、能访问代理端口。
一个小建议:先在浏览器里把代理调通,再迁移到爬虫和API场景。浏览器调通说明账号、授权、网络都没问题,后面再出问题就只剩代码层面的事了。
三、场景一:浏览器配置SOCKS5代理
浏览器是验证代理是否可用的最快途径,推荐用插件方式,配置一次即可随时切换。需要说明的是,Windows系统自带的"手动设置代理"对SOCKS5支持有限,所以插件是更稳妥的选择。
Chrome / Edge:用代理管理插件
以常见的 SwitchyOmega 插件为例:
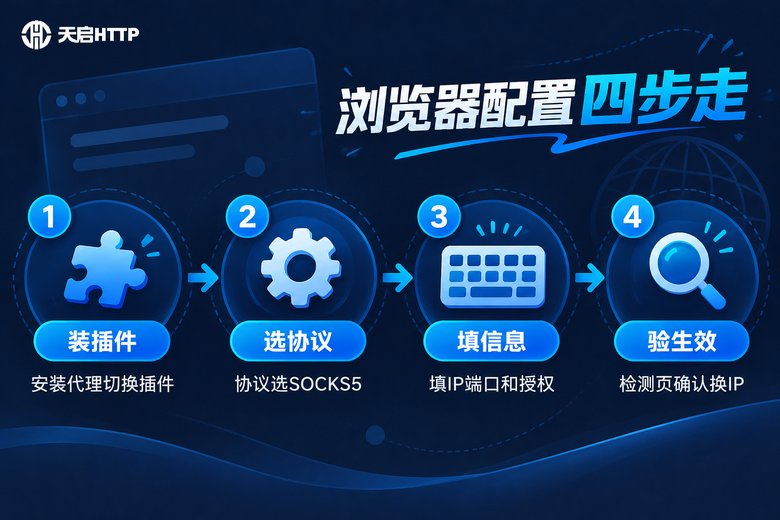
1. 在浏览器扩展商店安装插件,新建一个情景模式;
2. 代理协议选择 SOCKS5,填入后台拿到的代理IP和端口;
3. 授权方式建议优先选白名单——部分浏览器插件对SOCKS5账密弹窗的支持不稳定,在天启HTTP后台把本机出口IP绑定白名单后,插件里只填IP和端口即可;
4. 保存后点击插件图标切换到该情景模式,打开任意IP查询页面,显示的IP变成代理IP就说明配置成功。
Firefox:自带代理设置,无需插件
Firefox 可以直接在"设置 → 网络设置 → 手动配置代理"里填写SOCKS主机和端口,协议选 SOCKS v5,首次连接时会弹出认证窗口,输入账号密码即可。另外记得勾选"使用SOCKS v5时代理DNS",让域名解析也走代理,避免DNS泄露导致访问异常。
浏览器场景配置完成后,顺手验证两件事:IP是否切换、归属地是否是你要的城市。这两点都正常,说明整条代理链路没有问题。
四、场景二:爬虫程序接入SOCKS5代理
爬虫场景的核心,是把代理写进HTTP库的 proxies 参数。以 Python 的 requests 为例,先安装SOCKS支持:
pip install requests[socks]然后这样配置:
import requests

# 账密认证方式
proxies = {
    "http": "socks5h://用户名:密码@代理IP:端口",
    "https": "socks5h://用户名:密码@代理IP:端口",
}

# 白名单授权方式(无需账密)
# proxies = {
#     "http": "socks5h://代理IP:端口",
#     "https": "socks5h://代理IP:端口",
# }

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())   # 返回的 origin 是代理IP就说明接入成功
两个细节值得注意:
前缀用 socks5h 而不是 socks5。socks5h 表示域名解析也交给代理端完成,采集时能避免本地DNS污染和解析泄露;socks5 则在本地解析域名,某些网络环境下会出问题。
一定要加超时和重试。家宽动态IP有生命周期,单条请求失败要能自动换下一条,而不是卡死整个任务:
import time
import requests

def fetch(url, proxy_list, max_retry=3):
    """依次尝试代理列表,全部失败返回 None"""
    for proxy in proxy_list[:max_retry]:
        proxies = {
            "http": f"socks5h://{proxy}",
            "https": f"socks5h://{proxy}",
        }
        try:
            resp = requests.get(url, proxies=proxies, timeout=(5, 10))
            if resp.status_code == 200:
                return resp
        except Exception:
            time.sleep(1)   # 失败稍等再换下一条
    return None
如果你用的是 Scrapy 等框架,思路完全一样:在下载中间件里把代理写进 request.meta["proxy"],格式同样是 socks5h://IP:端口,再配合支持SOCKS5的中间件组件即可。并发量大的任务,建议提前把代理按城市分组,让同一业务固定走同一地区的IP,采集结果的地域一致性会好很多。
五、场景三:通过API动态提取,自动换IP
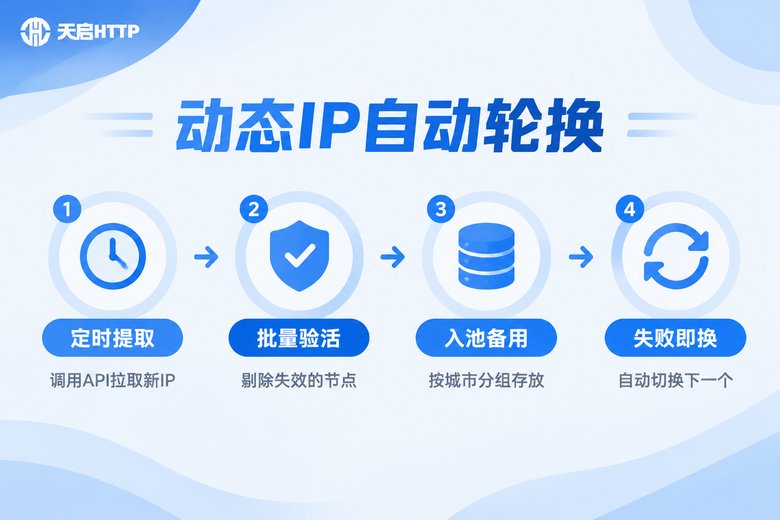
家宽动态IP会定期变化,靠手动改配置根本跟不上。第三种场景就是用API提取链接把这件事自动化:程序定时调用API拉取最新可用IP,验活后放进本地IP池,请求失败自动切换。
在天启HTTP后台可以生成API提取链接,支持设置提取数量、提取间隔和返回格式(文本、JSON等),绑定白名单后调用链接即可直接拿到代理列表。下面是一个最小可用的示例:
import requests

API_URL = "你的API提取链接"   # 在天启HTTP后台生成

def refresh_pool():
    """调用API提取链接,返回代理列表"""
    r = requests.get(API_URL, timeout=10)
    # 返回格式以你在后台设置的为准,默认每行一个 ip:port
    return [line.strip() for line in r.text.splitlines() if line.strip()]

def fetch_with_pool(url, pool):
    """依次尝试池内代理,全部失败返回 None"""
    for proxy in pool:
        proxies = {
            "http": f"socks5h://{proxy}",
            "https": f"socks5h://{proxy}",
        }
        try:
            resp = requests.get(url, proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp
        except Exception:
            continue
    return None

if __name__ == "__main__":
    pool = refresh_pool()
    resp = fetch_with_pool("https://httpbin.org/ip", pool)
    if resp is None:
        pool = refresh_pool()   # 池子耗尽,重新提取一批
        resp = fetch_with_pool("https://httpbin.org/ip", pool)
    print(resp.text if resp else "代理全部失效,请检查提取设置")
三个工程化建议:
1. 控制提取频率。API提取有频率限制,不要在失败循环里疯狂调用提取链接,建议用定时任务(比如每隔几分钟)刷新一次池子。
2. 提取后先验活再入池。拿到IP先发一个轻量请求测试连通性,把失效的挡在池子外面,业务请求的成功率会明显提升。
3. 记录每个IP的失败次数。连续失败多次的IP直接踢出池子,避免任务时间浪费在坏节点上。
六、三场景配置速查表
| 场景 | 配置入口 | 授权建议 | 关键参数 | 适合谁 |
|---|---|---|---|---|
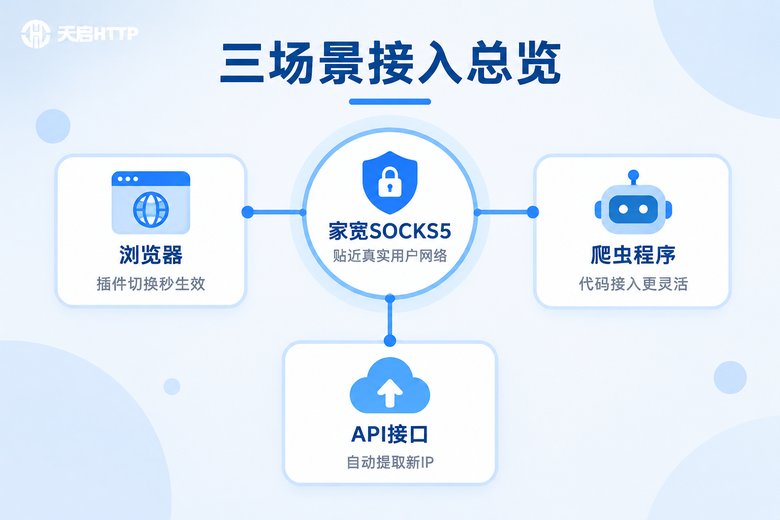
| 浏览器 | SwitchyOmega / Firefox 网络设置 | 白名单优先 | 协议选SOCKS5,勾选代理DNS | 人工核对、日常查数据 |
| 爬虫 | HTTP库的 proxies 参数 | 账密或白名单 | socks5h前缀 + 超时重试 | 批量采集任务 |
| API自动接入 | 定时调用API提取链接 | 白名单 | 提取数量、频率、验活入池 | 长期任务、多机部署 |
建议的落地顺序:先用浏览器跑通链路 → 再把同样的接入信息搬进爬虫 → 最后用API把换IP环节自动化。三步走完,整套家宽SOCKS5代理的使用流程就闭环了。
七、连不上?五个高频问题排查
1. 请求一直超时。先确认代理IP是否还在有效期内(动态IP会过期),再检查白名单里绑的是不是当前机器的出口IP——出口IP变了,白名单就失效了。
2. 提示认证失败。检查账密是否复制完整,密码里的特殊字符在URL中需要转义;另外SOCKS5的认证和HTTP代理的认证是两回事,别把HTTP的授权方式套在SOCKS5上。
3. IP没变,还是本机IP。浏览器场景多半是插件情景模式没启用,或者系统代理发生了冲突;爬虫场景检查 proxies 字典是不是 http 和 https 两个键都写了。
4. 速度明显偏慢。优先提取和目标业务同城市或相邻城市的节点,物理距离越近延迟越低;高峰时段可以适当调高超时阈值。
5. 部分网页打不开。确认浏览器勾选了"代理DNS",爬虫确认用的是 socks5h 前缀,让域名解析也走代理链路。
八、家宽SOCKS5代理,为什么推荐天启HTTP
选服务商主要看四点:IP质量、协议支持、接入方式和售后响应。天启HTTP作为专注国内业务的IP代理服务商,在这几方面都比较扎实:
真实的家宽IP资源。IP来自国内家庭宽带,配合自建机房统一维护,可用性和稳定性有保障,适合电商、爬虫、数据分析等对IP质量敏感的国内场景。
多协议支持。同时支持HTTP、HTTPS、SOCKS5等主流协议,本文三个场景用同一个账号就能全部覆盖,不用为不同工具分别采购。
灵活的接入方式。账密认证和白名单授权都支持,API提取链接可以按需设置数量、频率和返回格式,从浏览器手动配置到爬虫自动化都能平滑衔接。
覆盖国内多城市。节点分布广,可以按城市、按运营商定向提取,做地域性业务时尤其方便。
需要提醒的是,天启HTTP只提供国内IP,如果你的业务需要海外IP,它并不适用;选型前先确认自己的业务范围,再决定是否开通。
常见问题
Q: 家宽IP和机房IP有什么区别?
家宽IP由运营商分配给家庭用户,网络行为特征更接近真人;机房IP来自数据中心,批量特征明显。对风控较敏感的国内业务,家宽IP通常通过率更高。
Q: SOCKS5和HTTP代理怎么选?
只挂网页和接口请求,HTTP代理够用;要兼容多种客户端程序、希望域名解析也走代理,选SOCKS5更省心。天启HTTP两种协议都支持,可以按场景切换。
Q: 爬虫里前缀写socks5还是socks5h?
推荐socks5h,让域名在代理端解析,避免本地DNS污染和泄露;只有明确需要在本地解析域名的场景才用socks5。
Q: 白名单和账密认证能同时用吗?
一般二选一即可。白名单适合出口IP固定的服务器和浏览器场景;账密适合出口IP经常变化的环境。具体以天启HTTP后台支持的授权方式为准。
Q: 配置完访问IP查询页显示的还是本机IP?
按顺序排查:插件情景模式是否启用、协议是否选了SOCKS5、白名单是否绑定了当前出口IP、是否有其他代理软件抢占了系统代理。
Q: API提取的IP用不了怎么办?
先检查提取链接的返回格式和代码解析逻辑是否一致,再确认提取的IP是否已过有效期;建议提取后先验活再入池,并在代码里保留"重新提取一批"的兜底逻辑。