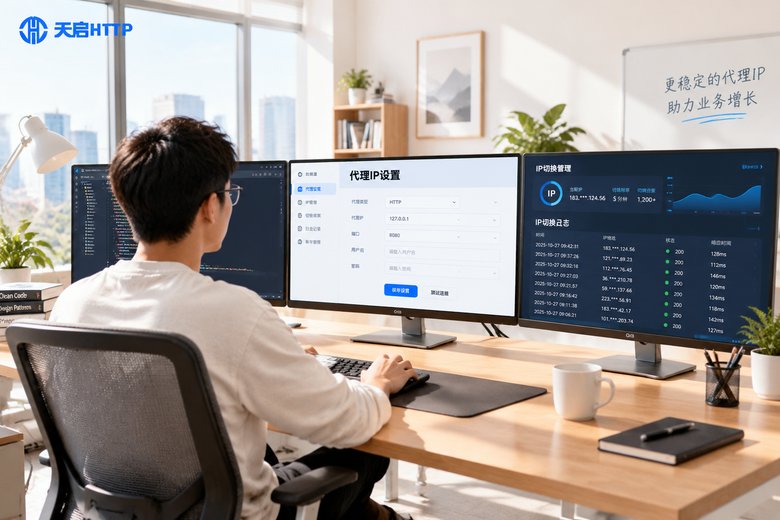
很多人第一次用代理IP,卡住的不是技术,而是不知道去哪里填、填完怎么确认生效。其实HTTP代理IP的配置逻辑非常简单:几乎所有联网程序都留有“代理入口”,你要做的只是把代理服务器的IP地址和端口填进去,再按服务商要求完成认证。本文按浏览器、爬虫程序、API批量调用三大场景,把配置步骤一次讲清楚,并附上常见问题的排查思路。
设置前,先准备好这三样东西
不管在哪个场景配置,先确认手上有:
1. 代理IP和端口:例如 114.123.45.67:8080,从代理服务商后台复制;
2. 认证方式:要么提前在后台把本机IP加入白名单,要么准备好账号密码;
3. 协议类型:确认拿到的是HTTP/HTTPS代理,端口和协议要对得上。
以天启HTTP为例,注册后在用户后台即可提取IP和端口,认证方式支持白名单绑定和账密认证两种,后续所有配置都基于这两项信息展开。
场景一:浏览器怎么设置HTTP代理
浏览器配置最简单,适合日常访问、多账号登录等轻量场景。
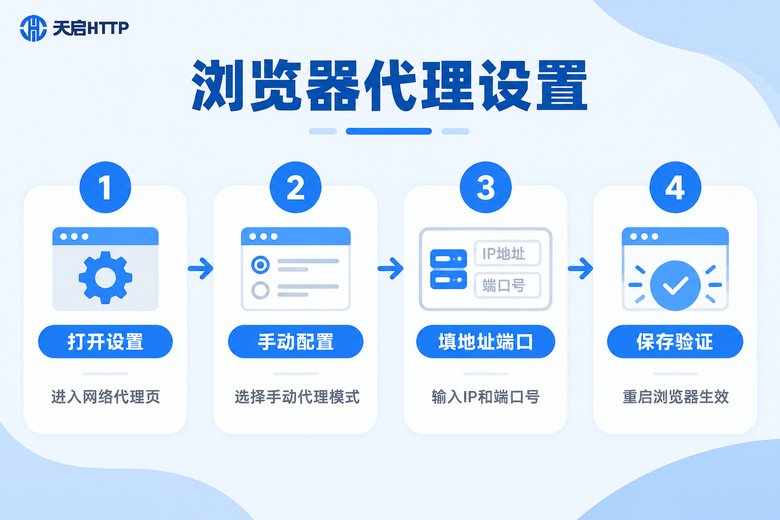
Windows 系统代理(Chrome、Edge 通用):Chrome 和 Edge 默认跟随系统代理,改系统设置即可:
1. 打开「设置」→「网络和Internet」→「代理」;
2. 找到「手动设置代理」,打开开关;
3. 填入代理IP地址和端口,点击保存。
Firefox 独立代理:Firefox 有自己的网络设置,不占用系统配置:打开「设置」→「网络设置」→「手动配置代理」,在 HTTP 代理一栏填入IP和端口,勾选“也将此代理用于HTTPS”,确定即可。
验证是否生效:配置完成后,访问任意能显示本机IP的查询页面,如果显示的IP变成了你的代理IP,说明配置成功。用完后建议及时关闭代理开关,避免代理IP到期后浏览器无法正常上网。
场景二:爬虫程序接入代理IP
爬虫场景下,代理是在代码里配置的,核心是给每个请求挂上代理参数。以 Python 的 requests 为例:
import requests

# 方式一:账密认证
proxies = {
    "http": "http://用户名:密码@114.123.45.67:8080",
    "https": "http://用户名:密码@114.123.45.67:8080"
}

# 方式二:白名单认证(本机IP已在后台绑定)
# proxies = {"http": "http://114.123.45.67:8080",
#            "https": "http://114.123.45.67:8080"}

try:
    # httpbin.org/ip 仅用于回显当前出口IP,验证代理是否生效
    resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
    print(resp.json())
except requests.exceptions.RequestException as e:
    print("当前IP请求失败,应剔除并更换:", e)
几个关键点务必注意:
一定要加 timeout:代理IP是有寿命的,失效IP如果不设超时,程序会一直卡死;
做好异常处理:请求失败就把IP从池子里剔除,换下一个继续跑;
控制请求频率:即使换了IP,访问太快依然容易触发目标网站的限制,配合随机延时更稳妥。
如果你用 Scrapy 框架,可以在中间件里统一给所有请求挂代理,不用逐个请求修改:
# middlewares.py
import random

class ProxyMiddleware:
    def process_request(self, request, spider):
        proxy = random.choice(spider.settings.getlist("PROXY_LIST"))
        request.meta["proxy"] = "http://" + proxy

# settings.py 中配置IP池
# PROXY_LIST = ["114.123.45.67:8080", "114.123.45.68:8080"]
场景三:通过API批量提取IP,自动换IP
手动复制IP只适合临时用一两次。真正跑批量任务时,标准做法是用服务商提供的API提取链接:程序定时请求这个链接,拉回一批新鲜IP,自动灌进本地IP池轮询使用。
import requests

def refresh_pool():
    # 提取链接在服务商后台生成,注意遵守最小提取间隔
    text = requests.get("你的API提取链接", timeout=10).text
    return [line.strip() for line in text.splitlines() if line.strip()]

pool = refresh_pool()

for ip_port in pool:
    proxies = {"http": "http://" + ip_port,
               "https": "http://" + ip_port}
    try:
        r = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=8)
        print(ip_port, "可用 →", r.json())
    except Exception:
        print(ip_port, "失效,剔除")
这套“提取 → 验活 → 轮询 → 剔除 → 再提取”的循环,就是绝大多数采集系统的代理调度雏形。天启HTTP的API提取支持按需设定提取数量和间隔,配合上面的代码即可直接落地运行。
三种场景配置方式对比
| 使用场景 | 配置位置 | 核心特点 | 适合人群 |
|---|---|---|---|
| 浏览器 | 系统代理或浏览器网络设置 | 一次配置,全局生效 | 日常访问、账号运营 |
| 爬虫程序 | 代码中的 proxies 参数 | 精细控制,可自动轮换 | 数据采集开发 |
| API提取 | 定时请求提取链接 | 批量获取,自动化换IP | 多账号、批量任务 |
配置完常见问题,这样排查
1. 代理连不上:先确认IP是否还在有效期内;再检查端口有没有抄错;最后核对认证——白名单绑定的本机IP变了(比如换了网络环境),或账密填错,都会导致连接被拒。
2. 验证页面显示的还是本机IP:检查 proxies 字典的键名是否写对(必须是 http 和 https);浏览器配置的话,试试完全重启浏览器;系统代理保存后不生效,多半是其他安全软件接管了代理设置。
3. 速度忽快忽慢:换一个节点试试,优先选择离你或目标服务器较近的城市节点;短效IP临近到期时速度普遍会下降,属于正常现象,及时更换即可。
4. 频繁要求重新认证:多为白名单与实际出口IP不一致导致,重新在后台绑定当前IP,或直接切换为账密认证方式。
代理服务商怎么选?
配置方法学会了,IP质量才是决定体验的关键。选服务商重点看四点:IP池规模与城市覆盖(节点越多,越不容易撞IP)、可用率(无效IP越少,程序空转越少)、并发能力(批量任务能不能同时跑)、提取是否方便(API是否支持自定义数量、间隔和格式)。
如果你主要做国内业务,可以优先试试天启HTTP。它是专注国内市场的IP代理服务商,提供HTTP/HTTPS代理,自建机房,节点覆盖国内多个城市,支持账密认证和白名单绑定两种方式,API批量提取与高并发调用都能适配本文讲到的全部场景。注册后在后台生成提取链接,按上面的步骤接入即可跑通。
常见问题
Q: 设置完代理,怎么快速确认已经生效?
最简单的办法是访问能回显IP的测试接口或查询页面,看返回的IP是否变成了代理IP。爬虫程序则看响应内容中的IP字段,和提取到的代理IP一致即为生效。
Q: HTTP代理和HTTPS代理是两回事吗?
平时说的HTTP代理大多同时支持转发HTTPS流量。浏览器里勾选“将此代理用于HTTPS”、代码里把 https 键也配置上即可。如果某个节点访问加密网站报错,多半是该节点不支持HTTPS,换一个节点就行。
Q: 爬虫挂了代理还是被限制,是什么原因?
常见原因有三个:一是IP质量差或已被大量复用;二是请求频率太高,换了IP也扛不住;三是请求头特征太明显。建议选用可用率高的服务商、加随机延时、完善请求头,并配合IP轮换策略。
Q: 一个代理IP可以多台设备或多任务同时用吗?
取决于服务商的并发与绑定规则。像天启HTTP支持高并发调用,白名单或账密认证通过后,多任务并行使用没有问题,具体以后台说明为准。
Q: 免费代理IP能用吗?
免费IP来源不明,普遍存在速度慢、存活时间短、被大量复用甚至被监听的风险。涉及账号安全和数据采集的业务,建议使用正规付费服务,稳定性和安全性都有保障。