为什么并发配置直接决定采集效率
做过数据采集的人都有体会:单线程一个个请求地发,跑一晚上可能才采几千条数据,效率低得让人着急。并发,就是同时发起多个请求,让采集任务从"一个人排队"变成"多窗口同时办理"。而代理IP在这件事里扮演的是"身份底座"的角色——每一个并发请求,都需要一个独立的IP身份去承载,否则目标网站一眼就能看出这些请求来自同一个来源。
但并发配置绝不是把线程数拉满那么简单。配置过低,速度上不去,白白浪费手里的IP资源;配置过高,轻则超时堆积、失败率飙升,重则触发目标网站风控,整批IP被限制,任务直接瘫痪。并发调优的本质,是在"速度"和"安全"之间找到平衡点。下面我们把这件事拆开讲清楚。
并发配置的四个核心参数
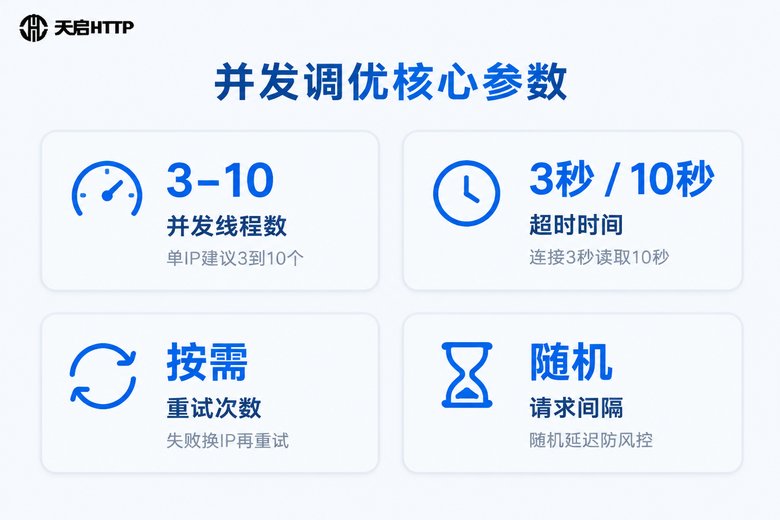
调并发之前,先搞清楚到底有哪些参数在起作用。绝大多数采集任务的并发问题,都出在下面这四个参数上:
1. 并发线程数:同一时刻发出的请求数量,这是最核心的参数。注意它不是越大越好,而是要和你的IP数量、目标网站的承受能力匹配。
2. 超时时间:分为连接超时和读取超时两段。设置太长,失败的请求会长时间占用线程,拖慢整体进度;设置太短,正常的慢响应会被误判为失败。经验值是连接超时3-5秒、读取超时10-15秒。
3. 重试机制:请求失败后重试几次、怎么重试。关键原则是重试必须换IP,同一个IP上立刻重试,大概率还是失败,还会加深目标网站对你的"坏印象"。
4. 请求间隔:请求之间的时间节奏。加入随机延迟(比如0.5-2秒之间随机),比固定间隔更像真人操作,更不容易触发风控。
| 参数 | 建议值 | 说明 |
|---|---|---|
| 单IP并发线程 | 3-10个 | 风控严的站点从3开始 |
| 连接超时 | 3-5秒 | 频繁超时说明IP质量差 |
| 读取超时 | 10-15秒 | 页面复杂可适当放宽 |
| 重试次数 | 1-2次 | 重试必须更换代理IP |
| 请求间隔 | 0.5-2秒随机 | 模拟真人访问节奏 |
并发数到底怎么算
很多新手最困惑的就是:我的并发到底该开多少?这里给一个简单的估算思路。
总并发 ≈ 可用IP数量 × 单IP并发数。比如你手上有100个可用IP,单IP开5个并发,总并发就是500。反过来说,如果你只有10个IP却想开500并发,等于让每个IP扛50个请求,被封几乎是一定的。
另一个必须考虑的因素是目标网站的承受能力。一个日访问量几千的小站点,能承受的每秒请求数可能只有几十,你一口气打过去几百个并发,对方服务器直接被打挂,风控也会立刻把你拉黑。而大型平台本身承受力强,可以适当放宽。
实操上建议这样起步:先估算目标站点正常用户的峰值流量,把你的总并发控制在这个量级的10%-20%,然后通过实测逐步调整。记住一个原则:宁可先慢一点跑稳,也不要一上来就猛冲。
四步优化法:从试压到动态调节
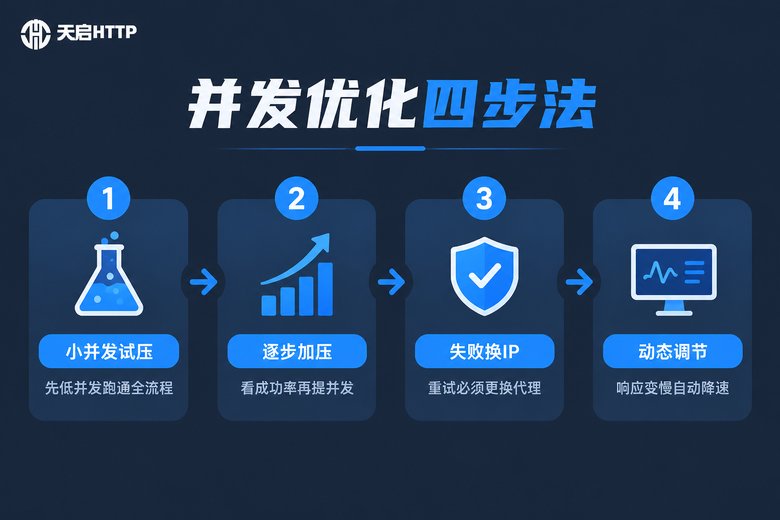
理论讲完了,下面是一套可以直接落地的四步优化流程:
第一步,小并发试压。用10-20的总并发先把整个流程跑通,确认请求、解析、存储每个环节都没问题。这个阶段的目的不是快,而是排除程序本身的bug。
第二步,逐步加压。流程稳定后,每次把并发提升20%-30%,观察成功率和平均响应时间。如果成功率维持在98%以上、响应时间没有明显变慢,说明还有加压空间;一旦成功率下滑,就退回上一档。
第三步,失败换IP重试。把"失败→换IP→重试"写进代码逻辑里,重试次数控制在1-2次,避免死循环。
第四步,动态调节。在程序里加监控:成功率低于95%时自动降低并发,恢复到99%以上再逐步回升。让程序自己适应目标网站的状态,比人工盯着手动调靠谱得多。
下面是一段Python示例,演示如何用线程池控制并发,并内置超时、随机间隔和换IP重试:
import requests
import random
import time
from concurrent.futures import ThreadPoolExecutor

def fetch(url, proxies, max_retry=2):
    for _ in range(max_retry + 1):
        proxy = random.choice(proxies)
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=(3, 10)  # 连接超时3秒,读取超时10秒
            )
            if resp.status_code == 200:
                time.sleep(random.uniform(0.5, 2))  # 随机间隔
                return resp.text
        except Exception:
            time.sleep(random.uniform(0.5, 2))  # 失败后随机等待,换IP重试
    return None

def main():
    # 代理列表通过天启HTTP的API提取接口批量获取
    proxies = ["http://ip1:port", "http://ip2:port"]  # 示例,替换为实际提取结果
    urls = [f"https://target-site.com/list/{i}" for i in range(1000)]

    # 总并发由线程池控制:100个IP × 单IP约5并发 ≈ 总并发500
    # 实际先从较小的max_workers起步试压,再逐步上调
    with ThreadPoolExecutor(max_workers=50) as pool:
        for text in pool.map(lambda u: fetch(u, proxies), urls):
            if text:
                pass  # 在这里处理采集结果:解析、入库
实战避坑:三个最常见的翻车点
翻车点一:线程开太多,越调越慢。有人觉得并发卡就把线程从100加到1000,结果内存占用暴涨、超时请求堆积,速度反而更慢。并发的瓶颈往往不在线程数,而在IP质量和目标网站的响应速度,先排查这两个,再动线程数。
翻车点二:重试不换IP。这是最隐蔽的坑。失败后用同一个IP立刻重试,等于告诉目标网站"我就是要高频访问你",风控印象分越扣越多。务必把换IP绑定进重试逻辑。
翻车点三:没有监控埋点。很多任务半夜被封了还在空跑,第二天一看什么都没采到。在程序里记录每个时间段的成功率和响应时间,异常时自动报警或降速,是长期稳定采集的基本功。
代理IP怎么选,才能撑得起高并发
并发配置调得再精细,底层的代理IP不给力也是白搭。高并发采集对代理服务的要求集中在三点:IP池要大,池子小了,高频换IP很快就无IP可换;提取要方便,最好支持API批量提取,直接对接程序里的IP调度模块;可用率要稳,拿到手十个IP三个连不上,有效并发直接打七折。
如果你的采集目标在国内,可以优先看看天启HTTP。它是国内IP代理服务商,自建机房,IP池规模大、可用率稳定,支持API批量提取,覆盖HTTP/HTTPS/SOCKS5多种协议,高匿名接入,配合上面讲的"失败换IP+动态调节"策略,能明显减少并发采集过程中的失败和风控拦截。需要提醒的是,天启HTTP只提供国内IP,如果你的采集目标在国内站点,用起来会非常顺手。
常见问题
Q: 并发数是不是越高越好?
不是。并发超过IP数量和目标网站承受能力后,超时和失败会激增,成功率反而下降,整体速度可能更慢。正确做法是从小并发试压起步,每次提升20%-30%,用实测数据找到速度和成功率的平衡点。
Q: 单IP并发设置多少比较安全?
一般3-10个比较稳妥,新站或风控严格的站点建议从3开始。同时配合0.5-2秒的随机请求间隔,比固定间隔更不容易触发风控。如果发现某个IP频繁超时,优先降低它的并发或直接剔除。
Q: 请求失败后重试要注意什么?
两个要点:一是重试必须换一个IP再发,同一个IP立刻重试大概率还是失败;二是重试次数控制在1-2次,超过次数就进失败队列稍后再处理,避免死循环拖垮整个任务。
Q: 天启HTTP适合做数据采集吗?
适合国内站点的采集场景。天启HTTP是国内IP代理服务商,自建机房,IP池规模大、可用率稳定,支持API批量提取和HTTP/HTTPS/SOCKS5协议,高匿名接入,方便对接并发调度和失败换IP策略。注意它只覆盖国内IP,如果你的采集目标是国内网站,可以放心使用。