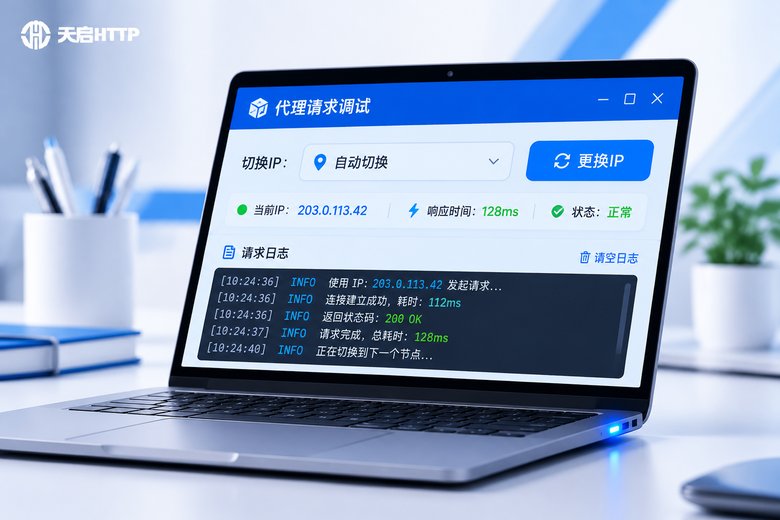
代理HTTP请求的本质:把请求交给中转站
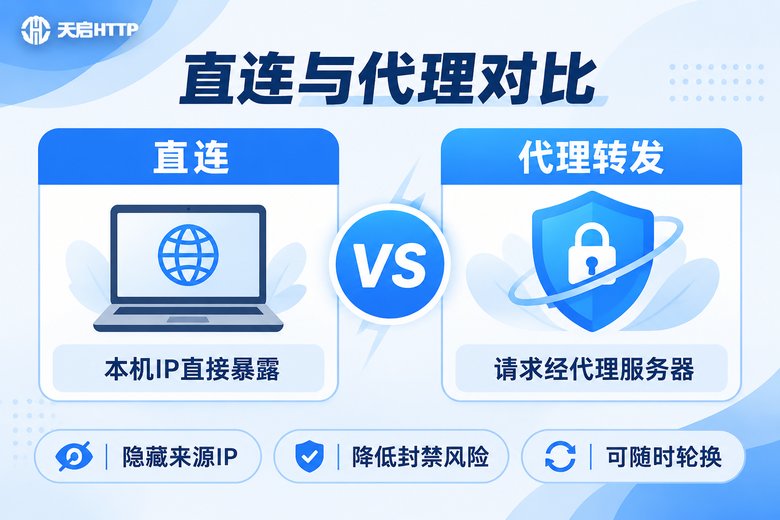
普通请求是"你的程序 → 目标网站",代理请求是"你的程序 → 代理服务器 → 目标网站",目标网站看到的是代理服务器的IP,而不是你本机的IP。
所以在代码层面,发一个代理请求要做的事情只有三件:告诉请求库代理地址在哪、带不带上认证信息、设置好等待多久算超时。剩下的问题都出在这三件事上。
常见的代理地址格式是 http://用户名:密码@代理服务器地址:端口。HTTP 请求走明文转发,HTTPS 请求则通过 CONNECT 隧道穿过去,因此同一个代理配置通常可以同时填给 http 和 https 两个键。
脚本调用:三种常见写法的完整示例
不管你用哪种语言,核心参数都一样。下面给出最常用的三种写法,把占位符换成天启HTTP提供的地址、端口、账号密码即可直接运行。
Python + requests
import requests

PROXY = "http://用户名:密码@代理服务器地址:端口"

proxies = {
    "http":  PROXY,
    "https": PROXY,
}

# timeout 建议写成元组:(连接超时, 读取超时)
resp = requests.get(
    "http://目标网站地址/api/list",
    proxies=proxies,
    timeout=(5, 15),
    headers={"User-Agent": "Mozilla/5.0"},
)
print(resp.status_code, len(resp.text))
需要注意,requests 的 timeout 默认是 None,也就是无限等待。如果你的脚本偶尔"卡死不动",多半就是忘了写这个参数。
curl 命令行
curl -x http://代理服务器地址:端口 \
     -U 用户名:密码 \
     --connect-timeout 5 \
     --max-time 20 \
     -o result.html \
     http://目标网站地址/
--connect-timeout 控制握手阶段,--max-time 控制整次请求的总耗时,两个都写才不会因为某个环节慢而无限挂起。
Node.js + axios
const axios = require("axios");
const { HttpsProxyAgent } = require("https-proxy-agent");

const agent = new HttpsProxyAgent("http://用户名:密码@代理服务器地址:端口");

axios.get("http://目标网站地址/api/list", {
  httpAgent: agent,
  httpsAgent: agent,
  timeout: 15000,
}).then(r => console.log(r.status)).catch(e => console.error(e.message));
Node 里 timeout 一般作用于整体请求,业务上如果还想区分"连不上代理"和"目标响应慢",可以在 catch 中根据 error.code 分流处理。
超时设置:连接超时和读取超时不是一回事
超时要拆成两段看,混在一起设置往往会踩坑:
连接超时:从你的程序发起,到和代理服务器建立 TCP 连接的这段时间。代理不可用、端口填错、网络不通,基本都在这一步暴露。读取超时:连接建立之后,等待目标网站返回第一段数据的这段时间。目标网站慢、代理链路拥塞,问题出在这里。
把两者分开设置,好处是你能从异常类型上直接判断问题出在哪一层:连接超时就是代理侧的问题,读取超时就要先怀疑目标站点或者链路质量。
| 参数 | 建议值 | 作用说明 |
|---|---|---|
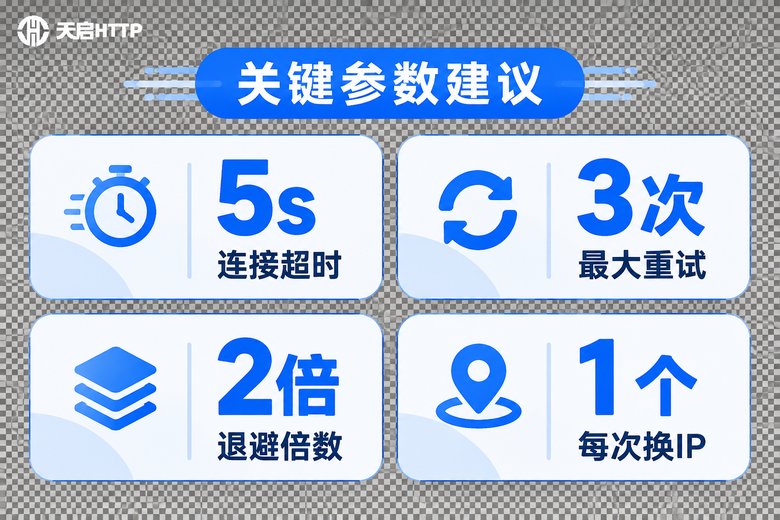
| 连接超时 | 3 ~ 5 秒 | 建立与代理服务器的连接,超过即判定代理不可用 |
| 读取超时 | 10 ~ 20 秒 | 等待目标返回数据,按目标站点的实际响应速度调整 |
| 最大重试次数 | 2 ~ 3 次 | 不含首次请求,超过就应当换IP或放弃 |
| 重试间隔 | 1s → 2s → 4s | 指数退避,避免瞬间把压力打回同一节点 |
| 单任务总时长 | 不超过 60 秒 | 兜底保护,防止整个任务被一个请求拖死 |
还有一个小细节:读取超时不是总耗时上限。如果服务端一点点往外吐数据,每次间隔都不超时,整次请求仍可能拖很久。做批量任务时,最好在循环层面再加一个总耗时判断。
重试写法:不是所有失败都值得再试一次
很多脚本一失败就无脑重试,结果请求量翻几倍,问题却没解决。重试前先分清异常类型:
值得重试的:连接超时、连接被重置、代理返回 5xx、目标返回 502/503/504、以及限流类状态码(这类要拉长间隔再试)。不值得重试的:401/403(认证或权限问题)、404(地址写错)、407(代理认证失败,重试一百次也一样)。
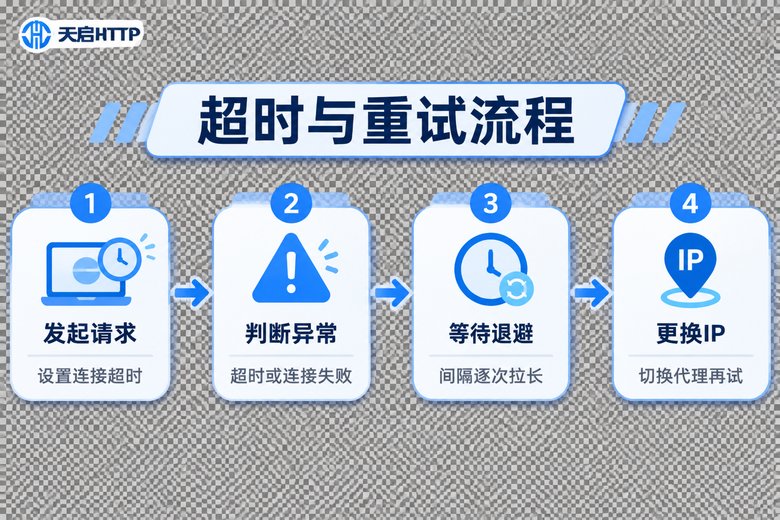
一个能直接套用的重试骨架,逻辑就是"退避 + 换IP + 计数上限":
import time, requests

RETRYABLE = ("ConnectTimeout", "ReadTimeout", "ConnectionError")

def fetch(url, proxy, retries=3):
    for i in range(retries):
        try:
            r = requests.get(url, proxies={"http": proxy, "https": proxy},
                             timeout=(5, 15))
            if r.status_code in (429, 500, 502, 503, 504):
                raise requests.RequestException(f"status {r.status_code}")
            return r
        except requests.RequestException as e:
            if i == retries - 1:
                raise
            time.sleep(2 ** i)      # 1s、2s、4s 指数退避
            proxy = get_new_proxy()  # 关键: 换一个IP再试
用 requests 生态里现成的方案也可以,urllib3.util.retry.Retry 支持指定重试次数、退避因子和需要重试的状态码列表,挂到 Session 上即可全局生效。
换IP比重试次数更重要。同一个IP连续失败,说明这个出口已经被目标盯上了,再怎么等也只是重复挨打。所以重试逻辑里一定要留出更换代理的入口。
代理IP服务怎么选:稳定性决定重试次数
代码写得再周全,代理本身三天两头连不上,重试也就是在给失败续命。选代理服务时,重点盯这几个可验证的指标:
一是可用率,能不能稳定建立连接,直接决定你的连接超时会不会频繁触发;二是响应速度,链路慢会让读取超时被迫拉长,任务整体吞吐跟着下来;三是接入方式,是否有清晰的API接口方便脚本按需取用,是否能提供隧道代理这类免维护的接入形式,省去频繁换IP的代码;四是并发能力,多线程或多进程跑任务时,能不能扛住同时发起的连接数。
天启HTTP 是国内的HTTP代理IP服务商,提供HTTP/HTTPS代理与隧道代理等接入方式,支持通过API接口提取IP,方便在Python、Node.js或命令行脚本中直接调用。对于只在境内做数据采集、接口调试、多账号管理的场景比较合适。需要提醒的是,天启HTTP 提供的是国内代理IP资源,如果你的业务需要访问境外站点,这套方案并不适用。
一套可直接落地的写法组合
把前面的要点串起来,一个稳当的代理请求脚本大概长这样:连接超时 5 秒、读取超时 15 秒,只对超时和 5xx 做重试,重试不超过 3 次,间隔按 1s、2s、4s 递增,每次重试前换一个新IP,单任务总耗时超过 60 秒就整体放弃并记录日志。日志里至少要记下"第几次尝试、用的哪个IP、失败原因",否则出问题时根本无从排查。
另外,能用会话复用就尽量复用,同一个Session发多个请求比每次新建连接更省时间,但如果目标是分散IP,就按请求粒度换代理,别在会话里死绑一个IP。
常见问题
Q:明明设置了 timeout,脚本还是会卡住很久?
常见原因是只给了一个数字而非元组,或者异常被吞掉后进入下一轮循环却没有退避。另外DNS解析阶段也可能耗时不短,可以改用IP直连目标或提前解析好域名。
Q:代理返回 407 是什么问题?
这是代理认证失败。检查用户名密码是否写对、是否做了URL编码(密码里有特殊字符时必须编码),以及服务商是否要求先绑定本机IP白名单。
Q:重试次数是不是越多越好?
不是。重试会成倍放大请求量,对代理和目标站点都是压力。经验值是2到3次,超过还失败基本说明IP或目标本身有问题,应该换IP而不是继续等。
Q:HTTP代理能发HTTPS请求吗?
可以。客户端会先向代理发送CONNECT请求建立隧道,再在隧道里做TLS握手。所以配置时 http 和 https 两个键都填同一个代理地址即可。
Q:为什么每个请求都要换IP?
同一个IP在短时间内高频访问,很容易触发目标的频控甚至封禁。批量任务里按请求换IP,能把访问分散开,显著降低被封的概率。
Q:脚本并发上去了就大量超时怎么办?
先降低并发数观察,再确认代理套餐允许的并发是否够用。盲目加线程只会让超时更多,通常把并发控制在代理承载能力之内、配合重试退避,反而总耗时更短。