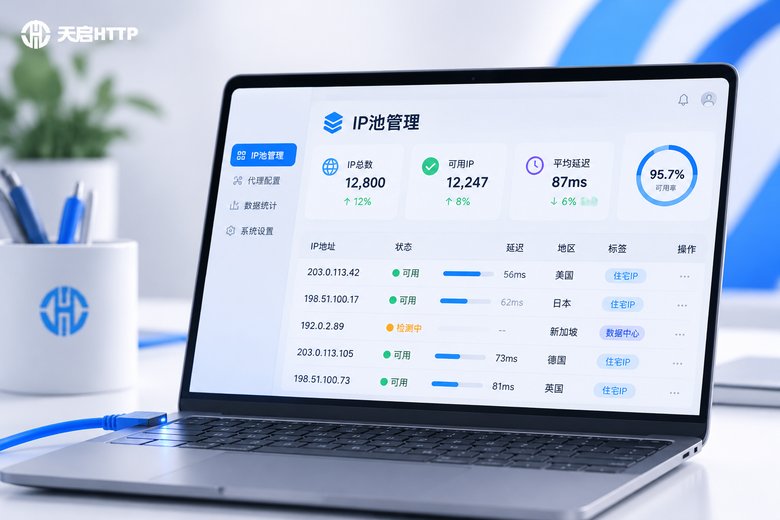
手里有一批代理IP,和把这一批IP管好,完全是两回事。很多人刚上手时都是"买一堆、随便取一个用",跑小任务没问题,一旦并发上来、任务周期拉长,问题就全冒出来了:任务成功率忽高忽低、昨天还能用的IP今天全废、某几个IP被目标站限得死死的、出了故障却不知道是哪一段出了问题。
其实多IP管理并不玄乎,它就是把三件事做扎实:池化(把零散IP变成可调度的活水池)、分组(给IP贴上用途标签)、权重(决定每次请求到底派谁去)。下面按全流程一步步拆开讲。
一、先想清楚:多IP管理到底在管什么
把"管理代理IP"这句话拆开,其实是三个层面的问题,缺一层都会出乱子。
| 层面 | 要解决的问题 | 对应动作 |
|---|---|---|
| 资源层 | 哪些IP现在是活的、能用的 | 池化:登记、探活、打分、清洗 |
| 组织层 | 哪条业务该用哪一批IP | 分组:按业务、站点、地区、用途贴标签 |
| 调度层 | 这一次请求派哪个IP去 | 权重:加权轮询、失败降权、熔断冷却 |
只做池化不做分组,就会出现"采集业务和登录业务抢同一批IP",互相拖累;只做分组不做权重,就只能平均分配,好IP没被充分利用,坏IP却还在接活。三层做完,才叫"管理"。
二、第一步 池化:把零散IP变成活水池
池化的核心目标是任何时刻,你伸手去要IP,拿到的都是经过检验的可用资源,而不是一堆不知道死活的地址。一个合格的池子通常包含四个动作。
1)入池登记。每条IP进池时统一记录:地址与端口、协议、归属地区、类型(独享还是共享)、到期时间、当前状态。格式不统一是后面所有麻烦的根源,务必在入口处就规范化。
2)定时探活。不要只用 ping 判断死活,那只能说明机器在线,说明不了它能不能访问你的目标站点。正确做法是拿目标站点的轻量页面做探测,同时记录成功率、平均耗时、返回状态。
3)健康打分。给每条IP一个可比较的分数,后面的权重分配才有依据。一个实用的简单公式是:成功率占六成、速度占两成半、连续稳定时长占一成半,具体比例可以按业务调。
4)清洗与补池。健康分低于阈值的IP不要直接扔,先放进"冷却区"观察;确认连续不可用的再剔除。同时给池子设一条水位线,低于水位就自动补充,避免任务跑到一半没IP可用。
# 池化探活的极简思路(伪代码)
score = success_rate * 0.6 + speed_score * 0.25 + stability * 0.15

if score < 30:
    ip.status = "cooldown"      # 进冷却区,先不停用
elif score < 60:
    ip.status = "backup"        # 降为备用池
else:
    ip.status = "active"        # 主力池

if active_count < water_line:   # 低于水位线
    pool.refill()               # 从接口补充新IP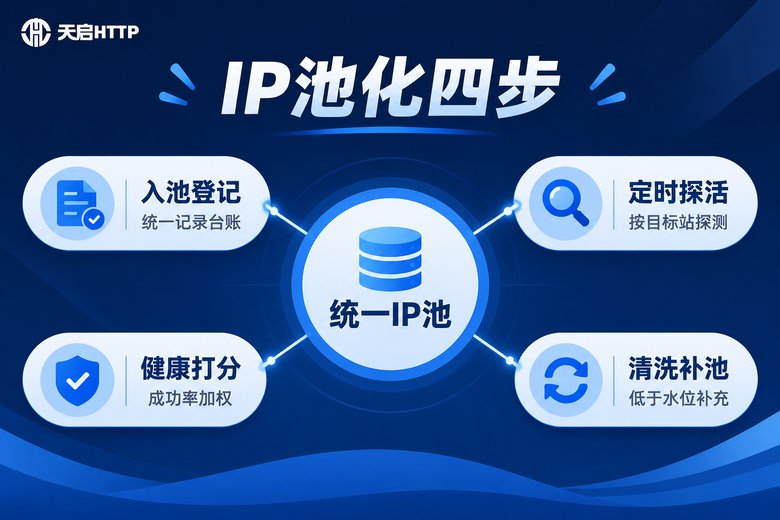
三、第二步 分组:给IP贴上"用途标签"
池子建好以后,最大的误区是"一个池子通吃所有业务"。不同业务对IP的要求差别很大:采集类要的是数量和高并发,登录类要的是稳定和低变更,本地化测试要的是地区精准。混在一起用,结果一定是两边都不好用。
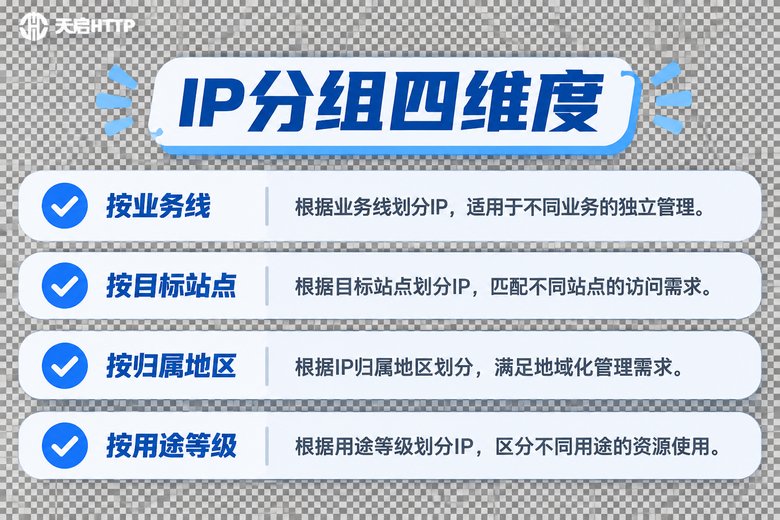
分组其实就是在IP身上打几个维度的标签,常用的有四个维度:
| 分组维度 | 典型分法 | 带来的好处 |
|---|---|---|
| 按业务线 | 采集组、登录组、测试组、监控组 | 业务之间互不干扰,出问题能快速定位 |
| 按目标站点 | 站点A专用组、站点B专用组 | 避免同一个IP到处跑,降低被限概率 |
| 按归属地区 | 按城市或省份切分 | 本地化任务、地区验证类业务更精准 |
| 按用途等级 | 主力组、备用组、应急组 | 核心任务优先吃到好IP |
分组时有三个细节值得注意:一是同组同质,一组里的IP在类型、时效、地区上尽量接近,调度逻辑才简单;二是每组留冗余,组内可用IP数量建议是日常需求量的三到五倍,留出故障和封禁的缓冲;三是命名要规范,比如"采集-华东-主力"这种一眼能看懂的名字,比"group1、group2"省下后面无数排查时间。
四、第三步 权重:让好IP多干活,坏IP少惹事
分完组,最后一环是决定"这一次派谁"。最简单是轮询,但它默认所有IP一样好,现实显然不是。真正好用的做法是给每条IP算一个权重,再按权重分配流量。
权重可以从这几个来源定:健康分(最直接)、业务重要程度(核心任务优先给高分IP)、IP稀缺度(独享或特定地区的IP给更高权重以防浪费)、剩余可用时长(快到期的多派活)。
调度策略上,常见的几种各有适用场景:
| 调度方式 | 适用场景 | 注意点 |
|---|---|---|
| 简单轮询 | IP质量高度一致、任务量小 | 无法避开坏IP,容易踩雷 |
| 加权随机 | 大多数常规业务 | 权重需要随健康分动态更新 |
| 最少使用优先 | 要严格控制单IP请求量 | 要维护每条IP的使用计数 |
| 失败降权 + 熔断 | 目标站反爬较严、封禁频繁 | 必须配合冷却期,不能立刻复用 |
其中失败降权和熔断冷却这两条是低成本高收益的规则:一条IP连续失败三次权重减半,连续失败五次直接移出可用池进入冷却区;冷却时间建议从几分钟起步,恢复时先给一半权重试跑,稳定后再恢复满分。整组成功率跌破阈值时,可以暂停该组整体调度,先人工看一眼,避免用一个坏组拖垮整条业务。
# 加权随机取一条IP(伪代码)
total = sum(ip.weight for ip in group.active)
pick = random.uniform(0, total)
cursor = 0
for ip in group.active:
    cursor += ip.weight
    if cursor >= pick:
        return ip
# 使用后不论成败都要回写结果,权重才会动起来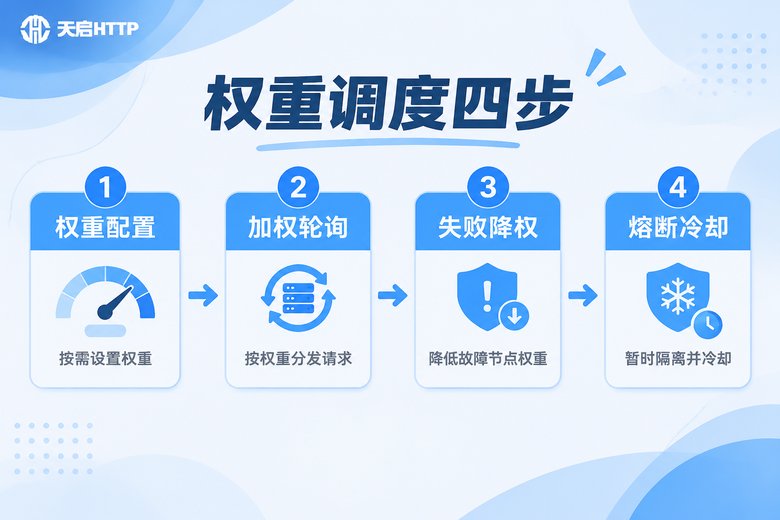
五、把三步串成一条流水线
池化、分组、权重不是三个独立动作,而是一圈闭合的循环:定时探活 → 更新健康分 → 重算权重 → 分配到业务 → 回收使用结果 → 失败上报 → 降权或冷却 → 剔除与补池 → 再探活。循环转起来,池子才会自己"新陈代谢"。
这条流水线上,建议至少盯住五个指标:池内可用率、平均响应时间、请求成功率、单IP日均请求量、异常或封禁比例。前两个看资源质量,中间两个看调度是否均衡,最后一个看外部压力。任何一项明显跑偏,都要回头检查分组是不是划得太粗、权重是不是写死了。
六、几个最容易踩的坑
坑一:只买不管。池子建完就再没跑过探活,实际可用率可能只剩一半,任务成功率自然上不去。
坑二:一个IP跑所有业务。采集、登录、测试共用一个组,任何一个业务把IP用脏,其他业务跟着遭殃。
坑三:权重写死。配置好一次就不再变,等于放弃了健康分带来的动态调整能力。
坑四:没有冷却期。失败的IP立刻被重新派出去,等于反复撞同一堵墙,还容易加速被封。
坑五:没有监控。全靠人肉发现"今天怎么这么慢",等察觉时往往已经跑废了一批任务。
七、自己搭调度层,IP来源怎么选
上面这套池化、分组、权重的逻辑,本质上是调度层的事,自己写脚本就能实现,不需要多复杂。真正影响成败的,是底下那层IP资源稳不稳定——调度写得再漂亮,源头供给不行也白搭。
天启HTTP 是国内代理IP服务商,提供 API 提取、隧道代理等接入方式,IP 资源为国内节点,后台可以查看提取数量和使用情况,返回格式统一,比较适合直接接进上面这套池化脚本里,做定时补充和健康检测。需要说明的是,天启HTTP 面向的是国内业务场景,比如国内电商运营、数据采集、本地化测试等,不适用于需要海外IP的场景。
选型时建议按业务特点来:对时效要求高、需要频繁更换的采集类任务,可以用 API 提取方式自行入池管理;对稳定性要求高、不想频繁换IP的业务,用隧道代理接入,省掉自己维护池子的部分工作量。独享类IP更适合核心业务,避免和其他人共用带来的不确定性。
常见问题
Q:池子里的IP是不是越多越好?
不是。关键在可用率和分组是否合理。一堆不探活、不清洗的IP只是账面数字,反而让调度逻辑变复杂。按日常需求量的三到五倍留冗余通常就够了。
Q:权重一定要人工配置吗?
不需要。权重最好由健康分自动算出来,人工只配置规则,比如"成功率占六成、速度占两成半",剩下的交给探活结果去更新。
Q:同一条IP可以同时给两个业务用吗?
技术上可以,但不建议。一条IP被某个业务用脏之后,另一个业务的成功率也会跟着掉。宁可多分几组,也不要交叉复用。
Q:共享IP和独享IP该怎么选?
看业务敏感度。常规采集、批量访问用共享成本更低;登录、核心链路、对稳定性要求高的场景,优先用独享,减少外部干扰。
Q:探活频率多高比较合适?
常规业务五到十分钟一次就够,时效很短的IP可以适当加密。注意探活本身也会消耗请求量,不要为了探活把IP用得过频。
Q:天启HTTP 的IP能接进自己的调度系统吗?
可以。通过 API 提取方式拿到的IP可以自行入池,走自己的探活、分组和权重逻辑;如果不想自己维护池子,也可以直接用隧道代理接入。具体接入方式和可用类型以官网说明为准。
Q:这套流程适合多大规模的业务?
从几十条IP的小任务到成百上千条的批量任务都适用,规模小时可以先用表格加脚本实现,跑顺了再逐步补齐监控和告警。