





翻一翻公开的AI爬虫采集案例,你会发现一个很尴尬的事实:成功案例几乎全是"结果展示"——采了多少万条、识别准确率多少、跑通了几个站点。可你照着复现,第一天就卡住了。
原因不复杂。采集是一门"环境强相关"的活:站点在变、风控在变、网络出口在变。别人成功时用的那套参数,是那个时间点、那个IP段、那个并发量之下的偶然平衡。而失败经验之所以值得看,是因为它指向的是共性规律——所有人在这个位置都会翻车,只是翻的顺序不同。
下面这份内容,来自多个AI数据采集项目的复盘记录。重点不是"怎么做成的",而是"哪些地方一定会出问题,以及怎么提前布防"。
一、三个值得反复看的失败现场
现场一:字段全都对,IP全废了。
项目组用单台服务器、单一出口IP,开了200个并发去跑一个商品列表页。前两小时很顺,数据量曲线漂亮;第三小时开始,返回码从200变成302,接着是验证码页,最后整段IP被拦。修复花的时间比开发还长。
根因不是"没人想到用代理",而是误以为"能跑通"就等于"能持续跑"。同一出口IP、固定间隔、固定并发,这三个条件叠在一起,几乎等于把"我是程序"写在请求头上。
现场二:跑到十万条,一条都不敢用。
数据拿到了,但字段错位、价格串行、分页重复。回过头查才发现,目标站点在项目中期改过页面结构,选择器从A路径换成了B路径,程序没报错——它安静地把空值写进了库。这类失败最贵,因为它不报错。
现场三:成本失控,请求量翻了3倍。
没有限次重试、没有退避、失败就直接重来。一个超时页面被重试了十几轮,日志刷了几十万行,实际有效数据只增加了2%。很多人以为采集的瓶颈是IP数量,其实瓶颈常常是无效流量占比。

二、把所有失败归成两类,问题就简单了
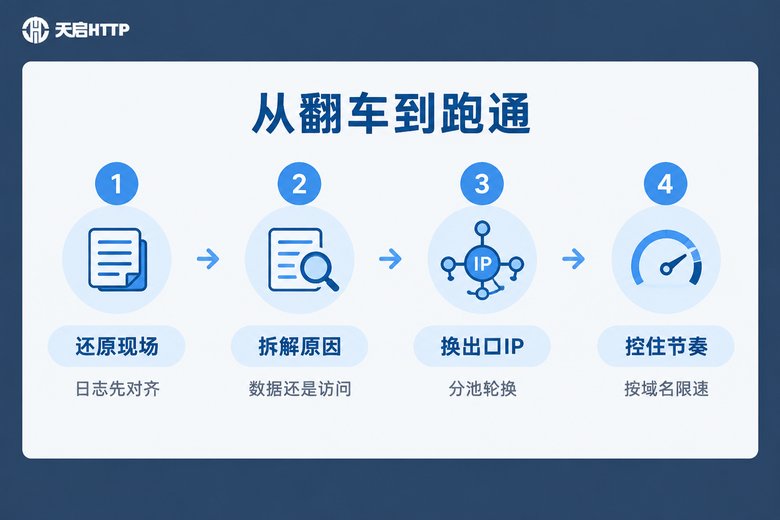
复盘时最有用的动作,不是找"哪个参数调错了",而是把问题分类。绝大多数采集事故,都能归到下面两类里。
| 失败现象 | 常见误判 | 真实根因 | 建议动作 |
|---|---|---|---|
| 频繁出现验证码、302跳转 | 网站升级了反爬 | 访问层:出口IP过于集中、请求节奏规律 | 分池轮换出口IP,打散请求间隔 |
| 部分时间正常、部分时间全挂 | 网络不稳定 | 访问层:单个IP被限流后仍在复用 | 失败IP立即剔除,切到备用池 |
| 数据有空值、字段错位 | 代码逻辑有bug | 数据源:页面结构变更、接口字段调整 | 加字段级校验与结构变更告警 |
| 总量上不去、成本飙升 | IP数量不够 | 访问层:重试无上限、无效流量占比过高 | 重试限次+指数退避,统计有效率 |
分类的价值在于:数据源问题靠改代码解决,访问层问题靠改出口解决。方向错了,越努力越贵。很多团队在这上面耗掉一个月,其实只要把"访问层"单独拆出来做。
三、访问层怎么救:把代理IP池用对
把访问层做好,核心是三件事,而不是"买一堆IP"。
1. 分池,而不是一个池跑所有站点。不同站点对访问频率的容忍度完全不同。把任务按目标域名分组,每个组分配独立的出口资源,一个组被限流不会拖垮全局。
2. 轮换要有节奏,不要机械轮换。每个请求换一次IP看起来很聪明,实际上更容易触发"同一批IP段集中出现"的特征。更稳的做法是:一个IP连续处理若干请求,出现异常再切换。
3. 失败要有边界。重试必须限次,并且带退避与随机抖动。下面这段是最小可用的写法:
import random, time, requests

# 隧道代理:固定入口,出口IP由服务端自动轮换
PROXY = "http://用户名:密码@隧道域名:端口"
PROXIES = {"http": PROXY, "https": PROXY}

UA_LIST = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 ...",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 ...",
]

def fetch(url, retry=3):
    for i in range(retry):
        try:
            r = requests.get(
                url,
                proxies=PROXIES,
                timeout=10,
                headers={"User-Agent": random.choice(UA_LIST)},
            )
            if r.status_code == 200 and "验证码" not in r.text:
                return r.text
        except requests.RequestException:
            pass
        # 指数退避 + 随机抖动,避免重试节奏过于整齐
        time.sleep(random.uniform(1, 3) * (i + 1))
    return None  # 明确失败,交给任务队列而不是无限重来

# 小技巧:先做小流量试跑,观察返回码分布,再放大并发
访问层稳定之后,你会发现数据源问题的排查也变轻松了——因为"是不是被封了"这个变量被消除了。
四、为什么这里推荐天启HTTP
访问层要稳定,靠自建机房或零散IP很难撑住。天启HTTP是国内IP代理服务商,产品形态覆盖短效代理、隧道代理、独享IP等,正好对应采集项目里最常见的三种需求:
· 短效代理适合大规模、可并行的列表页采集,出口资源切换快,单个IP失效不影响整体;
· 隧道代理适合不想自己写轮换逻辑的团队,固定一个入口地址,出口由服务端调度,代码里只改一行代理配置;
· 独享IP适合需要较长会话、对连续性要求高的场景,比如登录态维持、分页连续抓取。
需要说明的是,天启HTTP提供的是国内节点代理,适用于访问国内站点的采集任务;如果你的目标站点在境外,这套方案并不适用。另外,它不提供住宅类资源,选型时要按自己的业务场景判断。
实践建议是:先用隧道代理做小流量试跑,把返回码分布、有效率、单条成本跑出来,再决定要不要上独享IP补充稳定会话。这一步能省掉大量试错成本。

五、上线前的五项自检
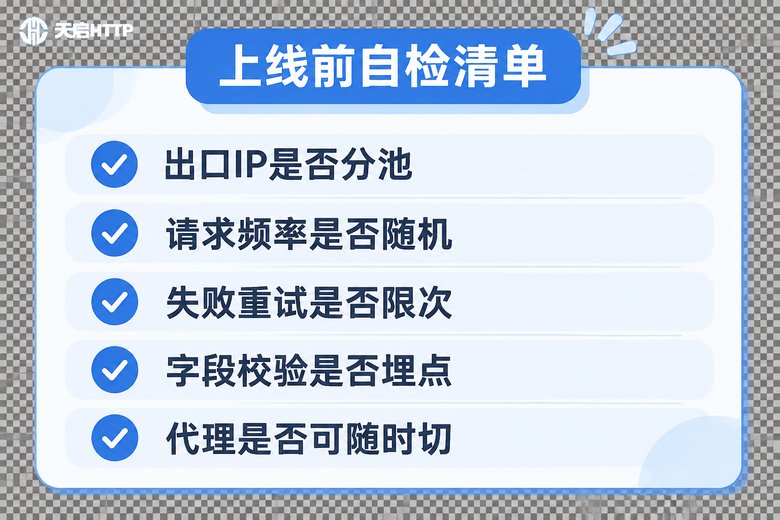
每次调整完采集策略,建议按下面五条过一遍再放量。这几条都是从失败现场里总结出来的:
1. 出口IP是否分池:不同目标域名是否走独立资源,一个组被封会不会影响全局。
2. 请求频率是否随机:间隔、并发、UA 是否都带随机因子,还是整齐得像机器。
3. 失败重试是否限次:单任务重试上限、退避策略、失败任务是否落到死信队列。
4. 字段校验是否埋点:空值率、异常格式、条数突降,有没有自动告警。
5. 代理是否可随时切:切换代理是否需要改代码、重启任务,还是改配置即可。
六、给AI采集项目的一句实话
AI 只是把"理解页面"这一步变简单了,它并没有让"稳定访问"变简单。模型再强,请求发不出去、IP被全段拦掉,一样拿不到数据。
所以复盘时别只盯模型指标。把访问层当成一个独立模块来设计:它有资源池、有调度策略、有失败边界、有监控指标。做好了这一层,成功的案例才有复制的可能;做不好,你复制来的只会是别人的失败。
常见问题
Q:成功案例为什么很难照着复现?
因为公开案例通常只写结果,不写当时的环境:目标站点的风控强度、出口IP质量、并发量、重试策略。这些参数一变,效果就完全不同。真正可迁移的是"分类思路"和"失败边界设计",不是具体参数。
Q:采集被封,第一反应应该做什么?
先看日志里的返回码分布,判断是"整段被拦"还是"零星超时"。整段被拦基本都是访问层问题——出口IP集中、节奏规律;零星超时则更可能是网络波动或单IP限流,切换出口即可。
Q:短效代理和隧道代理怎么选?
要自己控制轮换逻辑、并发量大、按量跑列表页,选短效代理;不想维护轮换代码、希望入口固定,选隧道代理。两者也可以混用:主体任务走隧道,特殊任务单独配。
Q:需要长会话、要维持登录态怎么办?
这种情况轮换越频繁越糟。建议用独享IP,把会话绑定在固定出口上,同时把并发压下来,靠"慢而稳"换数据完整度。
Q:天启HTTP能采集境外站点吗?
不能。天启HTTP面向国内节点场景,境外站点采集需要另找方案。选型前先确认目标站点归属,能省下不少时间。
Q:数据采到了但质量差,怎么排查?
先做字段级校验:统计空值率、字段长度分布、条数环比。如果某天条数突然下降或空值率上升,大概率是页面结构变了。把这类校验做成定时任务,比事后人工比对有效得多。


