为什么抓北京本地平台,绕不开北京本地代理IP
很多北京本地的平台——本地生活服务、区域电商、政务公开信息、招聘与房产站点——在服务端都做了地域判断。你从一台外地服务器发请求过去,对方的网关第一眼看的就是你的 IP 归属地。归属地不是北京的请求,轻则被降速、返回空数据,重则直接被风控拦下,返回一个验证页或者干脆 403。
所以做这类采集,代理 IP 的归属地本身就是成功率的一部分。用北京本地的 HTTP 代理去访问北京本地的平台,请求在链路里"看起来"就是一个普通北京用户发起的,平台侧的地域校验这一关才算过了第一道。
但同样是北京 IP,"城区机房"和"郊区机房、外地机房"之间的成功率差别,往往比很多人想象的要大。本文就把这件事拆开讲清楚,并给出可落地的测试和优化方法。
城区机房和外地机房,到底差在哪
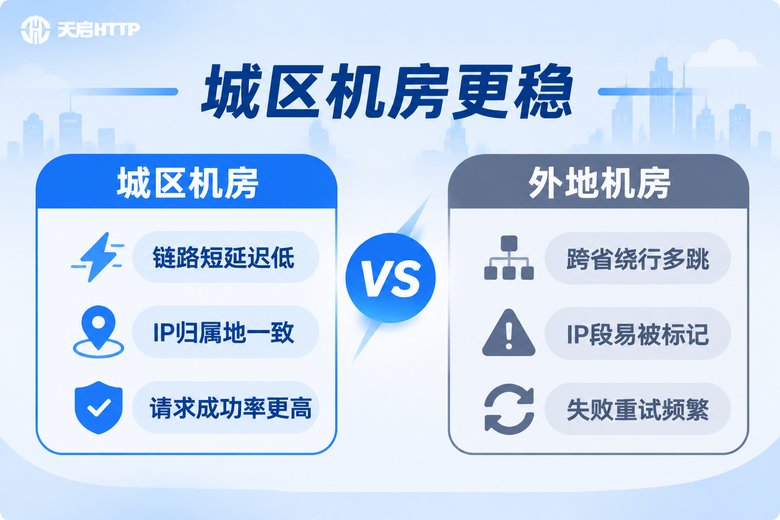
先说结论:差异主要来自三件事——链路长度、IP 段的"本地浓度"、以及平台侧的风控画像。
第一是链路。城区的机房通常接入在城域网核心节点附近,到本地平台服务器的往返路径短、跳数少。你在北京城区机房的出口 IP 上发请求,可能两三个网络节点就到了目标服务器;而外地机房要跨省绕行,中间多出好几跳,延迟从二三十毫秒涨到七八十毫秒甚至更高。延迟本身不会直接导致失败,但超时阈值是硬约束,延迟一高,原本 8 秒能拿到的页面变成 12 秒,脚本里的 timeout 一砍,就算失败了。
第二是 IP 段的本地浓度。平台风控在长期运营中,会把明显来自机房、且归属地频繁跳变的 IP 段打上标签。城区机房的 IP 段往往更贴近本地运营商的常规网段,被集中标记的概率相对低一些;外地机房一旦被批量用于某个本地平台,很容易整段"连坐"。
第三是风控画像。本地平台的风控通常会组合判断:IP 归属地、ASN 类型、请求频率、UA 与 Cookie 一致性、访问时间分布。城区机房的出口 IP 在归属地和时延特征上更"像本地人",前两项就容易过关,后面的行为特征只要控制得当,成功率自然高。
| 对比维度 | 北京城区机房 | 郊区 / 外地机房 |
|---|---|---|
| 典型往返延迟 | 20~40 ms | 60~120 ms |
| 路由跳数 | 少,多在本地城域网内闭环 | 多,需跨省绕行 |
| IP 归属地一致性 | 与目标平台同城,校验易通过 | 异地,容易被地域规则拦截 |
| 被风控标记概率 | 相对较低 | 较高,整段易被"连坐" |
| 抓取成功率(同类任务实测) | 明显更高、更稳定 | 波动大,需要频繁重试 |
影响成功率的四个关键点
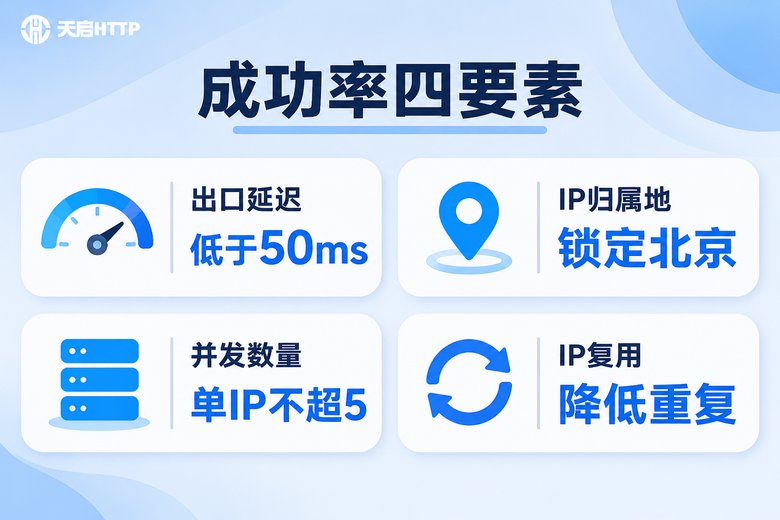
拿到北京城区的代理 IP 只是起点。真正决定成败的,是下面这四个变量,建议在任务开始前逐项确认:
出口延迟。把超时阈值设置在合理区间,比如 8~10 秒,同时在选 IP 时先筛掉延迟高于 200 ms 的节点,别让慢节点拖垮整批任务。
IP 归属地。抓北京本地平台就用北京的出口 IP,不要图省事混用其他城市。很多平台的地域校验是按请求 IP 的归属地判断的,混用等于自己给自己降成功率。
并发数量。同一个 IP 上同时跑十几个请求,是触发风控最快的方式。单 IP 并发建议控制在 5 个以内,批量任务靠"多 IP 轮换 + 低并发"来堆吞吐,而不是"单 IP 高并发"。
IP 复用率。同一个 IP 反复访问同一批页面,间隔越短越容易被识别。合理的方式是给每个 IP 设定访问配额,用完就换,让单个 IP 的访问曲线更接近真实用户。
实测:用一段脚本验证你的代理成功率
不要凭感觉判断"这个代理能不能用"。写一段简单的脚本,跑 50~100 次请求,把成功率、平均延迟、失败原因统计出来,一目了然。下面是一个可以直接改造成自己业务的示例:
import requests, time, random

# 从代理服务商的提取接口拿到一批北京出口 IP
PROXY_LIST = [
    "http://用户名:密码@代理地址:端口",
]

TARGET = "https://目标本地平台地址/"
HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
}

def try_once(proxy):
    s = requests.Session()
    s.proxies = {"http": proxy, "https": proxy}
    t0 = time.time()
    try:
        r = s.get(TARGET, headers=HEADERS, timeout=10)
        cost = round((time.time() - t0) * 1000)
        return r.status_code == 200, cost
    except Exception:
        return False, -1

def run(times=50):
    ok, cost_list = 0, []
    for i in range(times):
        proxy = random.choice(PROXY_LIST)
        success, cost = try_once(proxy)
        if success:
            ok += 1
            cost_list.append(cost)
        time.sleep(random.uniform(0.8, 2.0))   # 随机间隔,别打匀速
    rate = ok / times * 100
    avg = round(sum(cost_list) / len(cost_list)) if cost_list else 0
    print(f"成功率: {rate:.1f}%  平均延迟: {avg} ms  成功次数: {ok}/{times}")

if __name__ == "__main__":
    run(50)
同一批任务,分别用北京城区机房和外地机房各跑一轮,把两个成功率数字放在一起对比,你会非常直观地看到差距在哪里。这也是判断一个代理服务商是否适合本地平台采集的最快办法。
实战清单:把成功率再往上提一档
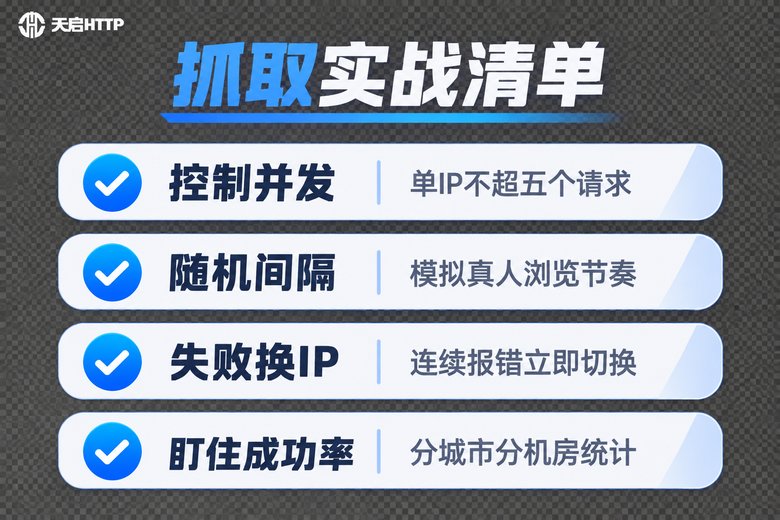
代理选对了,脚本策略也要跟上。下面几条是可以立刻落地的操作:
控制并发。单 IP 并发不超过 5 个请求,宁可多申请几个 IP,也不要把压力堆在一个出口上。
随机间隔。请求间隔加一点随机抖动,模拟真人浏览的节奏,别用固定 1 秒的匀速打点。
失败立刻换 IP。连续出现 403、验证页、返回空数据时,不要原地重试,直接切换下一个 IP,同时把该 IP 标记为不可用。
盯住成功率。按城市、按机房、按时段分别统计成功率,发现某个时段掉得厉害,多半是并发或者 IP 池质量出了变化,要及时调整。
选天启HTTP做北京本地平台采集的几个理由
天启HTTP 是国内 IP 代理服务商,提供 HTTP / HTTPS / SOCKS5 代理,支持按城市筛选出口 IP,做北京本地平台采集时可以把出口稳定落在北京。几个对采集任务比较实在的点:
城市可选。可以按城市指定出口 IP,抓本地平台时避免了大范围随机分配带来的地域不匹配问题。
高匿稳定。代理请求不携带真实来源信息,请求头干净,配合合理的频率控制,被识别的概率更低。
API 提取。提供接口直接拉取 IP 列表,方便接入上面的脚本做自动轮换和批量调度,不用手工维护。
响应快。实际使用中延迟表现稳定,适合对超时比较敏感的采集任务。
需要说清楚的是,天启HTTP 提供的是国内范围的代理 IP 资源,不适用于需要国外 IP 的业务场景;同时也不提供住宅类 IP,如果业务必须依赖住宅网络特征,那不在它的覆盖范围内。做北京本地平台采集这类需求,它是比较对口的。
常见问题
Q:用了北京代理 IP,成功率就能到 100% 吗?
不能。代理 IP 解决的是"归属地不被地域规则拦截"这一层问题,平台还会看请求频率、UA 一致性、行为特征。代理选对了,再配合低并发和随机间隔,成功率才会明显上去。
Q:同样是北京 IP,为什么城区机房成功率更高?
主要是链路短、延迟低、路由跳数少,请求不容易超时;再加上城区机房 IP 段的本地属性更自然,被风控批量标记的概率相对低一些。
Q:天启HTTP 能指定出口在北京吗?
支持按城市筛选出口 IP,做本地平台采集时可以指定北京。具体可选城市和提取方式,以官网的服务说明为准。
Q:一个代理 IP 能扛多少并发?
建议单 IP 并发控制在 5 个以内。要提升整体吞吐,正确做法是增加 IP 数量、减少单 IP 压力,而不是把一个 IP 用到底。
Q:采集本地平台需要注意什么?
遵守目标站点的使用规则和相关法律法规,控制请求频率,不要对平台造成压力,仅采集公开信息、不碰用户隐私数据。稳妥的做法是先小批量测试,确认成功率稳定后再逐步放量。