




先想清楚:外贸数据采集,采的到底是什么
很多南通的外贸公司、货代、跨境电商团队,嘴上说的是"外贸数据采集",实际动手采的往往是国内就能正常打开的那一批站点:B2B 外贸平台上的商品与供应商列表、行业门户的报价行情、展会与商会公开名录、港口与物流公告、竞品官网的产品参数页。这些内容的共同点是——它们都在国内网络环境下可以访问,只是需要你高频、持续、稳定地去抓。
这里必须先说清楚一件事:天启HTTP 提供的是国内各地城市的代理 IP 资源,适合采集国内可正常访问的站点。如果你的业务场景是访问境外站点,这套方案并不适用,需要另外评估。本文讲的"南通 IP 代理做外贸数据采集",指的是用南通及周边城市的节点 IP,去采集国内可访问的外贸相关公开数据。
把这个前提摆正,后面的两个关键词才有意义:地区和稳定。
为什么"地区"这件事,在采集里比你想的重要
采集任务跑不顺,很多人第一反应是"IP 被封了",其实有一半是地区没选对。原因不复杂:
第一,不同地区的网络出口到目标站点的路径不一样。同样一个外贸平台,南通本地出口访问和西部某城市出口访问,往返延迟可能差一倍以上。采集任务动辄几万条 URL,单次多出 200 毫秒,累计就是几个小时。
第二,目标站点的内容本身可能带地域差异。本地仓库存、区域报价、地区专享的商品列表、按城市展示的供应商排序,这些都会让"你在哪"影响"你看到什么"。做南通本地外贸行情采集,如果全用外地节点,抓回来的数据可能跟你在本地浏览器里看到的并不一致。
第三,风控策略往往按地区聚类。短时间内大量请求集中从同一批陌生地区的出口涌入,比从本地及邻近城市分散进入更容易被判定为异常。地区分布做得好,本身就是一种"低调"。
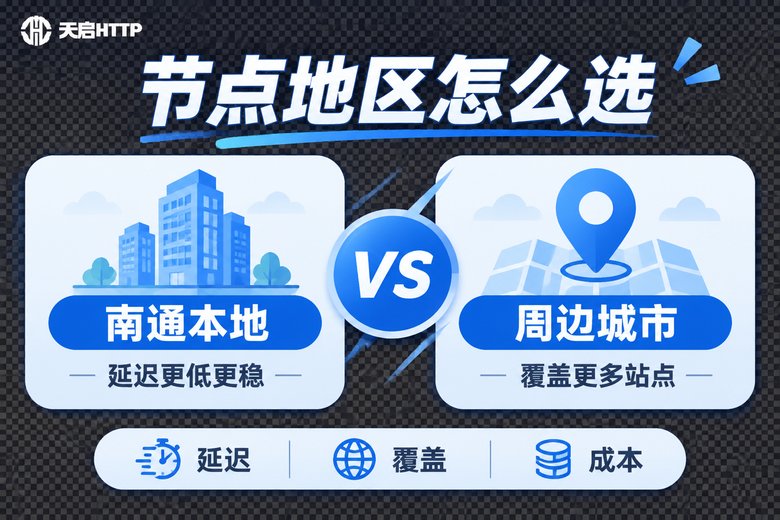
南通本地节点和外地节点,各自该管什么
别把两者对立起来,正确的做法是分工。
| 对比维度 | 南通本地节点 | 外地城市节点 |
|---|---|---|
| 访问延迟 | 低,抖动小 | 中等,视城市而定 |
| 数据视角 | 与本地人工浏览一致 | 可看到其他区域的展示差异 |
| 适合的任务 | 本地行情、核心站点主力采集 | 大批量补充采集、分散请求压力 |
| IP 池规模 | 相对集中 | 更充足,便于轮换 |
实用建议:把核心站点、需要"本地视角"的采集任务放在南通本地节点上跑,把页面量大、对地域不敏感的列表页交给外地节点分散去做。这样既保住了数据口径,又不会把本地 IP 池一次性榨干。
在天启HTTP 这边,可以直接按城市筛选节点、通过 API 提取 IP,具体可选的地区范围和套餐形式以官网说明为准,别凭记忆拍脑袋。
稳定性不行,采集任务等于白跑
地区选对了,稳定性跟不上,结果一样难看:任务跑到 60% 断了、数据一半是空的、重跑三遍才补齐。判断一套代理稳不稳,看四个东西就够了。
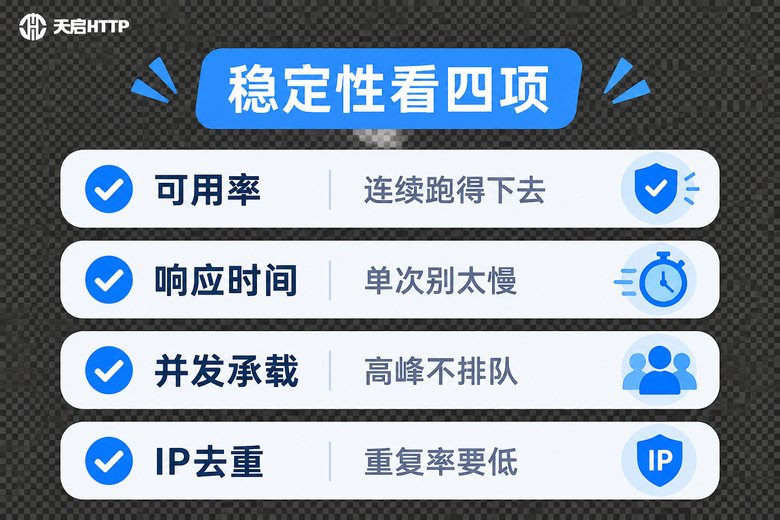
可用率:随手取 100 个 IP 去请求目标站点,能成功返回正常页面的比例。低于 90% 的,跑长任务会很痛苦。
响应时间:不是越快越好,而是波动要小。平均 300 毫秒但时不时飙到 8 秒的池子,比稳定 500 毫秒的更难用,因为你的超时阈值没法设。
并发承载:白天业务高峰时再测一次。很多池子夜里看着挺好,一到工作日十点就开始排队。
IP 去重:同一批提取里重复率高不高。重复率高意味着你在重复消耗同一批出口,风控那关会过得很难看。
一套能落地的南通外贸数据采集流程
把地区和不稳定这两件事放进流程里,大致是四步。
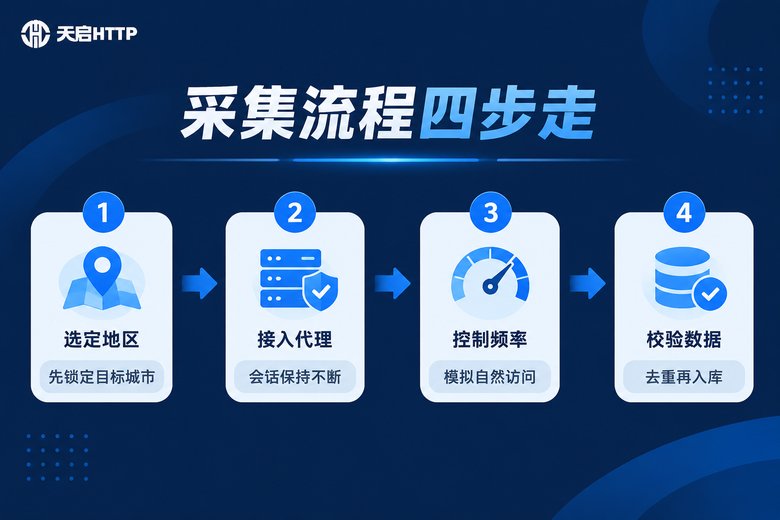
第一步,锁定目标地区。先确定哪些站点必须用南通本地节点,其余标记为可弹性。
第二步,接入代理并保持会话。需要登录态或连续翻页的任务,用一个 IP 跑完一段流程再换,别每请求一次就换一个出口,那样反而更像机器。
第三步,控制请求频率。再加代理也不能把目标站点打疼,间隔、并发都要克制。
第四步,校验后再入库。状态码 200 不代表拿到了有效内容,标题为空、列表为 0 条、出现验证页,都要单独标记并重试。
import requests, time, random

# 天启HTTP 提取到的代理,格式:用户名:密码@IP:端口
PROXIES = [
    "http://user:pass@1.2.3.4:8080",   # 南通本地节点
    "http://user:pass@5.6.7.8:8080",   # 周边城市节点
]

def fetch(url, proxy):
    r = requests.get(
        url,
        proxies={"http": proxy, "https": proxy},
        timeout=10,
        headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
    )
    r.raise_for_status()
    return r.text

urls = ["https://example.com/list?page=1", "https://example.com/list?page=2"]

for u in urls:
    proxy = random.choice(PROXIES)
    try:
        html = fetch(u, proxy)
        print(proxy.split("@")[1], len(html))
    except Exception as e:
        print("失败,换一个 IP 重试:", e)
    time.sleep(random.uniform(2, 5))   # 频率控制,别抓太狠
这段代码只是骨架,真实项目里还要加上失败重试、IP 淘汰、去重比对,但思路就是这个:地区先分层,IP 再轮换,频率要克制,结果必校验。
几个容易踩的坑
坑一:只盯着 IP 数量。一万个高重复、高延迟的 IP,不如三百个稳定的。数量是虚的,可用率才是实的。
坑二:全程只用一个地区。连跑三天同一个城市出口,目标站点不封你封谁。地区要分层,也要有节奏。
坑三:把代理当成万能解药。目标站点限的是账号、Cookie、行为频率,光换 IP 不控制行为,一样过不去。
坑四:拿到数据直接用。采集到的价格、单位、地区字段没清洗就进报表,最后错的是业务流程,不是采集脚本。
常见问题
Q:天启HTTP 有南通本地的 IP 吗?能做境外站点的采集吗?
天启HTTP 是国内代理 IP 服务商,按城市提供国内节点,具体覆盖哪些城市、当前可选地区有哪些,以官网说明为准。它不提供境外 IP,所以如果要访问境外站点,这套方案并不适用。
Q:外贸数据采集一定要用南通本地 IP 吗?
不一定,但建议核心站点用。本地节点延迟低、数据视角和你人工浏览一致,适合做主力采集;大批量、对地域不敏感的页面可以用其他城市节点分散。
Q:动态 IP 和长效静态 IP 怎么选?
翻页、列表类的短任务适合动态 IP,轮换方便;需要保持登录状态、连续操作同一站点的长任务,用能维持一段时间的静态 IP 更省心。混合用也是常见做法。
Q:采集频率控制在多少比较安全?
没有统一标准,取决于目标站点的承受能力和风控强度。保守做法是从每个 IP 每分钟个位数请求起步,观察成功率,再逐步调整。
Q:代理 IP 用了之后成功率还是不高,先查哪里?
按这个顺序查:地区是否选错、IP 重复率是否过高、请求头是否缺失、是否触发了验证页、超时阈值是否太紧。多数问题不在代理本身。
Q:小团队有必要做地区分层吗?
有必要,但可以简单做。哪怕只分成"南通本地"和"其他城市"两组,效果也明显好过一锅乱炖。


