
一、为什么数据采集离不开动态IP和高并发
做数据采集的朋友都知道,采集效率的天花板往往不是代码写得好不好,而是IP够不够用、并发开得对不对。目标网站通常会对同一个IP的访问频率做限制,一旦请求过快,轻则弹验证码,重则直接封IP。这时候,动态IP代理就成了标配:每次请求换一个IP,把访问压力分散到整个IP池上,采集任务自然跑得更稳、更快。
但光有IP还不够。如果只用一个线程、一个IP慢慢请求,一天可能采不到几万条数据。想要提效,就必须上并发——让多个请求同时跑,每个请求绑定不同的代理IP。并发和动态IP是天生一对:IP越多,可开的并发就越高;并发越高,IP的消耗和轮换也越快。
二、配置并发前,先弄清楚三件事
很多人一上来就把线程开到几百,结果不是被目标站封禁,就是把自己机器跑崩了。在动手配置之前,建议先评估这三个前提:
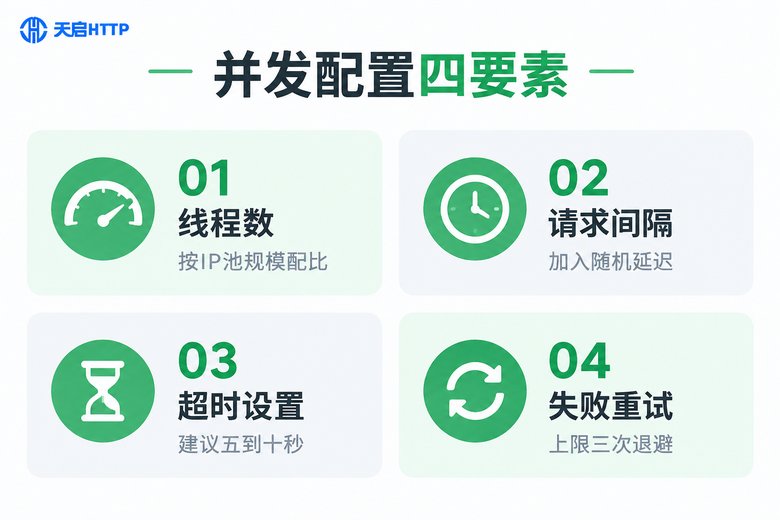
1. 你的IP池有多大?并发数要和IP池规模匹配。一般来说,最好让每个并发任务独占一个IP,或者按"一个IP同时只跑1~2个并发"来分配。IP池不大还硬开高并发,等于让少数IP扛下所有流量,很快就会被目标站识别。
2. 目标网站能承受多少?不同站点的抗压能力差别很大。有些站点每秒几个请求就触发风控,有些则宽松得多。前期建议用小并发试探,观察返回状态码和响应速度,再逐步上调。
3. 你的业务时效要求是什么?如果数据不着急,低并发加慢速采集是最安全的;如果有时效要求(比如实时比价、监控类业务),就需要高并发配合大IP池,同时做好失败重试和降级策略。
三、核心参数怎么配?一张表看懂
并发配置说复杂也复杂,说简单也简单,核心就是下面这几个参数。给大家整理了一份参考表:
| 参数 | 推荐范围 | 配置要点 |
|---|---|---|
| 并发线程数 | 10~50 起步 | 与IP池规模匹配,逐步上调 |
| 请求间隔 | 0.5~3 秒 | 加入随机延迟,避免规律性访问 |
| 超时时间 | 5~10 秒 | 超时及时释放线程,别让任务卡死 |
| 失败重试 | 最多 3 次 | 重试时更换IP,采用退避策略 |
| IP更换频率 | 按业务定 | 短效动态IP按生命周期及时轮换 |
这里重点说两个容易踩坑的地方:一是请求间隔一定要加随机值,比如在1~3秒之间随机取,固定间隔的访问模式很容易被风控识别;二是失败重试一定要换IP,用同一个IP反复重试,只会让封禁来得更快。
四、实战:一套能直接跑的并发采集代码
下面用 Python 写一个最简单实用的并发采集示例,思路是:先从代理服务商的API批量提取IP,然后用线程池并发请求,每个任务绑定一个代理IP。
import requests
from concurrent.futures import ThreadPoolExecutor

# 第一步:从天启HTTP后台复制API提取链接,批量拉取代理IP
def fetch_proxies():
    api_url = "你的天启HTTP-API提取链接"
    resp = requests.get(api_url, timeout=10)
    # 返回格式一般为每行一个 ip:port
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

# 第二步:单个采集任务,绑定一个代理IP
def crawl(proxy):
    try:
        resp = requests.get(
            "https://www.example.com/data/1",
            proxies={"http": f"http://{proxy}", "https": f"http://{proxy}"},
            timeout=8,
            headers={"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
        )
        if resp.status_code == 200:
            return resp.text
    except Exception:
        return None
    return None

# 第三步:线程池控制并发,先从10开始,稳定后再逐步上调
if __name__ == "__main__":
    proxies = fetch_proxies()
    with ThreadPoolExecutor(max_workers=10) as pool:
        results = list(pool.map(crawl, proxies))
    print(f"采集完成,成功 {sum(1 for r in results if r)} 条")
这段代码有三个关键点:max_workers 控制并发数,建议从10开始,观察成功率和响应速度后再往上加;timeout 设置超时,避免个别慢请求拖住整个线程池;每个任务绑定独立IP,互不干扰,一个IP失效不影响其他任务。
五、进阶优化方案:让并发跑得更稳更快
基础版跑通之后,想要规模化采集,还需要在这几个方向上做优化:
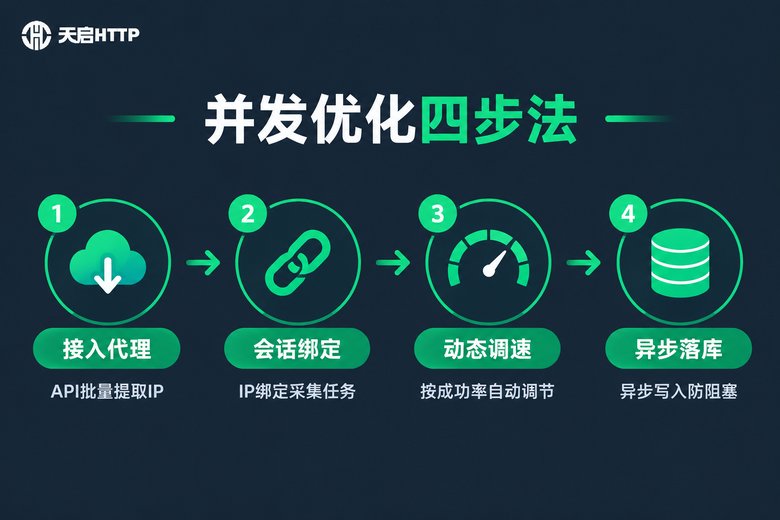
1. IP调度与绑定。建立一个"IP池管理器",记录每个IP的使用次数、最近使用时间和失败次数。优先分配"新鲜"的IP,失败次数超标的IP直接剔除,避免把请求浪费在坏IP上。
2. 动态调速。实时监控成功率:成功率高于95%,说明当前并发安全,可以小幅上调;成功率跌到80%以下,立即降并发、拉长间隔,等风控放松再恢复。让程序自己"踩油门、踩刹车",比固定参数灵活得多。
3. 异步IO替代多线程。采集属于典型的IO密集型任务,用 asyncio 加 aiohttp 的异步方案,单机轻松支撑几百上千的并发,资源占用远低于多线程。配合代理IP使用时,注意为每个请求独立设置代理即可。
4. 结果异步落库。采到数据后不要在请求线程里直接写数据库,先扔进队列,由专门的写入线程批量入库,避免数据库慢查询拖垮采集主流程。
六、选对代理服务商,并发配置事半功倍
并发方案再好,也需要稳定的IP资源来支撑。选服务商时重点看这几点:IP池规模够不够大、API提取是否方便、IP可用率是否稳定、能否支撑高并发业务场景。
如果你主要采集国内网站的数据,可以了解一下天启HTTP。它是国内IP代理服务商,提供动态代理IP,支持API批量提取,接入方式简单,把提取链接替换到上面代码里就能直接用,比较适合数据采集这类需要频繁更换IP的高并发场景。具体套餐和并发规格,建议以天启HTTP官网信息为准。
常见问题 Q&A
Q: 并发数开得越高,采集速度一定越快吗?
A: 不是。并发超过IP池和目标站承受能力后,封禁率会快速上升,成功请求反而变少,速度不升反降。正确做法是从小并发起步,根据成功率和响应时间逐步上调,找到平衡点。
Q: 跑着跑着出现大量超时,是什么原因?
A: 常见原因有三个:一是代理IP失效了,需要重新提取并更换;二是并发过高触发了目标站风控,响应变慢或被拦截,应降低并发并加长间隔;三是本机带宽或线程资源耗尽,检查一下CPU和内存占用。
Q: 天启HTTP适合高并发的采集任务吗?
A: 天启HTTP是国内IP代理服务商,提供动态代理IP和API批量提取方式,IP池规模较大,接入简单,适合数据采集这类需要频繁更换IP的业务场景。具体并发上限和套餐规格,建议前往天启HTTP官网查看或咨询客服确认。
Q: 被目标网站封了IP怎么办?
A: 首先立即降低并发并暂停该IP的使用;其次检查请求头是否完整(User-Agent、Referer等);最后在重试逻辑中强制更换新IP,并对已失效的IP做标记剔除,避免重复踩坑。