
在信息爆炸的时代,一条负面消息从论坛发酵到全网扩散,可能只需要几个小时。对企业品牌方、政务机构和公关团队来说,搭建一套舆情监控系统,第一时间发现与自己相关的讨论,已经成为刚需。而舆情监控系统的核心是数据采集,采集的瓶颈往往不在技术框架,而在IP资源——单台服务器、单个IP的爬虫,很快就会被目标网站限流甚至封禁。本文就来讲清楚:如何把海量代理IP和分布式爬虫结合起来,搭一套稳定可靠的舆情采集系统。
一、为什么舆情监控系统离不开海量代理IP
舆情监控的本质,是对新闻网站、论坛、社交平台、行业垂直站点等公开信息进行7×24小时不间断抓取。这和普通爬虫最大的区别在于:目标站点多、抓取频率高、持续时间长。
如果只用一台服务器、一个固定IP去采集,很快会遇到几个问题:
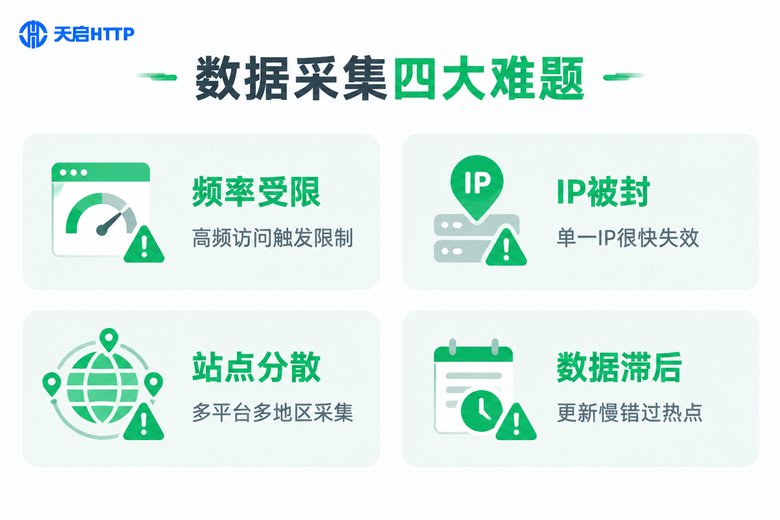
这些问题的根源都是一样的——请求太集中,特征太明显。而海量代理IP正好从两个方向解决它:
第一,分散请求来源。把原本由一个IP发出的成千上万次请求,摊到几百上千个不同IP上,每个IP对目标站点的访问频率降到风控阈值以下,被封的概率大幅下降。
第二,模拟多地区视角。很多内容在不同城市、不同运营商网络下展示结果不一样,通过切换国内不同地区的代理IP,可以更完整地还原真实的舆论环境,避免数据盲区。
二、分布式爬虫的整体架构设计
单机爬虫撑不起舆情监控的体量,架构上必须走分布式。一个典型的舆情采集系统可以拆成五个模块:
| 模块 | 职责 |
|---|---|
| 调度中心 | 生成与分发采集任务,控制整体节奏和优先级 |
| 采集节点 | 多台机器并行抓取,支持随时横向扩容 |
| 代理池服务 | 统一供应IP,自动检测并剔除失效IP |
| 清洗入库 | 去重、正文抽取、格式化,接入情感分析 |
| 预警看板 | 关键词命中即时告警,趋势数据可视化 |
整个链路可以概括为五步:
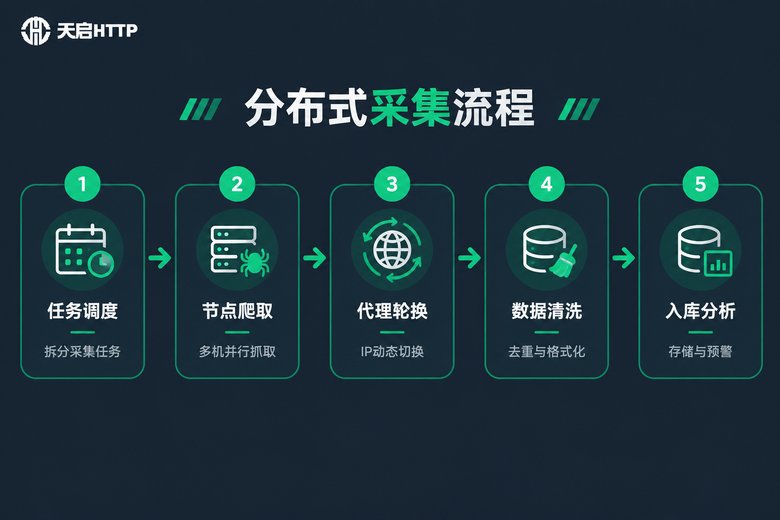
这里的关键设计是采集节点与代理池解耦:节点不直接管理IP,而是统一向代理池服务要IP、报结果。这样做的好处是,IP的检测、评分、剔除逻辑只写一份,所有节点共享同一套优质IP池,避免每个节点各自为战、重复踩坑。
三、海量代理IP如何接入爬虫系统
代理IP的接入方式主要有两种:API提取(定时拉取一批IP到本地代理池)和账密认证(直接连固定入口,由服务端自动分配)。两种方式可以并存,按业务场景灵活选择。
下面是一个带自动换IP重试逻辑的Python示例,演示如何把代理池接入采集函数:
import requests
import random

# 从代理商后台复制API提取链接,定期拉取最新可用IP
API_URL = "你的代理提取API链接"

def refresh_pool():
    """拉取一批新IP,补充进本地代理池"""
    text = requests.get(API_URL, timeout=5).text
    return [line.strip() for line in text.splitlines() if line.strip()]

proxy_pool = refresh_pool()

def crawl(url):
    """带自动换IP重试的采集函数"""
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
    for _ in range(3):  # 最多重试3次
        if not proxy_pool:
            proxy_pool.extend(refresh_pool())
        ip = random.choice(proxy_pool)
        proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
        try:
            resp = requests.get(url, headers=headers,
                                proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp.text
        except Exception:
            proxy_pool.remove(ip)  # 剔除失效IP,换下一个重试
    return None
如果使用账密认证方式,则不需要提前绑定终端IP,写法更简单:
proxies = {
    "http": "http://用户名:密码@代理服务器地址:端口",
    "https": "http://用户名:密码@代理服务器地址:端口"
}除了接入,代理池的日常维护同样决定采集质量:
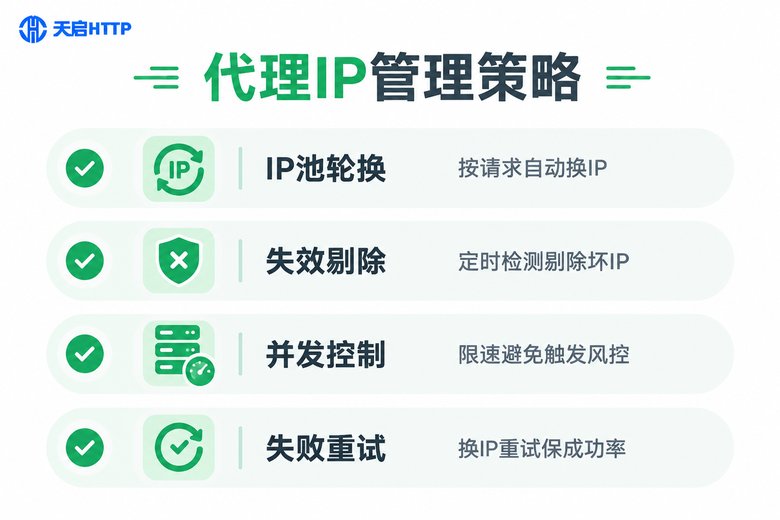
其中失效剔除尤其重要——舆情采集是长跑,IP池里混进几个坏IP,就会拖慢整体成功率。建议在代理池服务里做定时探活,把响应慢、连不上的IP及时踢出去,再从新提取的批次里补位。
四、稳定性与效率优化实战
架构和IP都就位后,真正拉开差距的是细节调优。几个实战经验:
1. 频率控制优先于并发堆叠。对同一个目标站点,先摸清它的风控阈值,把单IP的请求频率压在阈值以下,再靠多IP、多节点把总量堆上去,而不是一味加并发硬冲。
2. 请求特征随机化。User-Agent轮换、请求间隔加随机抖动、合理处理Cookie,这些都能显著降低被识别为爬虫的概率。
3. 失败即换IP。请求失败后不要用原IP重试,直接换一个新IP,同时把原IP标记降权,多次失败的直接剔除。
4. 错峰调度。把非紧急的全量巡检任务安排在夜间低峰期执行,白天高峰期只跑关键词实时监控,资源利用率更高。
做完这些优化后,效果对比非常直观:
| 对比维度 | 单IP爬虫 | 海量代理 + 分布式 |
|---|---|---|
| 采集速度 | 慢,频繁被限流 | 多节点并行,速度快 |
| 稳定性 | IP一封就断流 | 自动换IP,持续采集 |
| 覆盖范围 | 视角单一,有盲区 | 多地区多站点覆盖 |
| 数据完整性 | 缺失严重 | 接近全量抓取 |
五、选对代理IP服务商,事半功倍
舆情监控系统对代理IP的要求可以概括为四个字:多、稳、快、净。IP量要大,可用率要高,响应要快,IP要干净。推荐使用天启HTTP,它是国内代理IP服务商,提供HTTP、HTTPS、SOCKS5等多种协议支持,IP资源池规模大、可用率高,并支持API提取、账密认证等灵活的接入方式,能够很好地匹配分布式爬虫对海量IP轮换的需求。
对于舆情采集这类场景,天启HTTP还支持按城市维度选取IP,方便你从不同地区的网络视角采集内容,让舆情数据更全面、更贴近真实舆论环境。具体的产品套餐和接入文档,可以直接在官网查看和验证。
常见问题
Q: 舆情采集是否合规?
只采集公开可见的数据,遵守目标站点的robots协议和相关服务条款,控制访问频率、不影响目标网站正常运行,并避免涉及个人隐私信息,用于品牌监测等正当用途。具体边界以平台规则和法律法规为准。
Q: 代理IP多久换一次比较合适?
没有统一答案,取决于目标站点的风控强度。反爬严格的站点建议按请求轮换,每次请求都用不同IP;需要保持登录态或会话的页面,可以按会话维持几分钟再换。核心原则是让单个IP对同一站点的访问频率低于其风控阈值。
Q: 搭分布式爬虫需要准备很多台服务器吗?
不需要一步到位。可以从2-3台云服务器起步,配合任务队列随时横向加节点。实际瓶颈往往不在机器数量,而在代理IP的质量和调度策略是否合理。
Q: IP被封了怎么办?
立即把失效IP从代理池中剔除并换新IP重试,同时降低对目标站点的请求频率;再检查请求头、Cookie等特征是否过于规律,做随机化处理。如果用的是天启HTTP这类大IP池服务,直接换IP即可恢复采集,几乎不影响整体进度。
Q: 天启HTTP支持哪些协议和接入方式?
天启HTTP支持HTTP、HTTPS、SOCKS5协议,提供API提取和账密认证等接入方式,覆盖国内多城市IP,具体详情可在官网查询。