
在金融领域,数据就是钱。行情报价、公告快讯、财报数据、舆情动态,晚抓到一秒,价值就可能大打折扣。很多做金融数据采集的团队都遇到过同样的问题:程序明明在跑,数据却总是“慢半拍”,或者跑到一半任务就断了。问题往往不在代码,而在代理IP的质量上。今天我们就聊聊,金融数据实时抓取如何做到稳定,以及低延迟代理IP该怎么筛选和配置。
为什么金融数据抓取对代理IP要求更苛刻
compared to 普通网页采集,金融数据抓取有三个明显的特点:
第一,实时性要求极高。行情类数据以秒为单位更新,采集链路上每多一毫秒延迟,数据的时效价值就打一分折扣。如果代理响应慢,你拿到的可能已经是“过期行情”。
第二,请求频率非常高。为了跟上行情变化,采集程序往往需要对接口高频轮询,单IP很容易触发目标站点的频率限制,轻则限速,重则直接封禁。
第三,反爬机制严格。财经数据是各大平台的核心资产,验证码、访问频率检测、IP行为分析一个不少。没有足够的IP储备和切换能力,任务随时可能中断。
这三点叠加起来,意味着金融采集必须依赖代理IP池,而且不是随便什么代理都行——低延迟和高稳定是硬门槛。下面这组对比很直观:
| 对比项 | 直连采集 | 普通代理 | 优质低延迟代理 |
|---|---|---|---|
| 平均响应延迟 | 低但易被封 | 波动大,数百毫秒起 | 稳定在百毫秒级 |
| 请求成功率 | 高频后骤降 | 时好时坏 | 99%以上 |
| 任务中断风险 | 高 | 中 | 低 |
| 数据时效性 | 前期好后期差 | 滞后明显 | 接近实时 |
低延迟代理IP怎么筛:四个硬指标
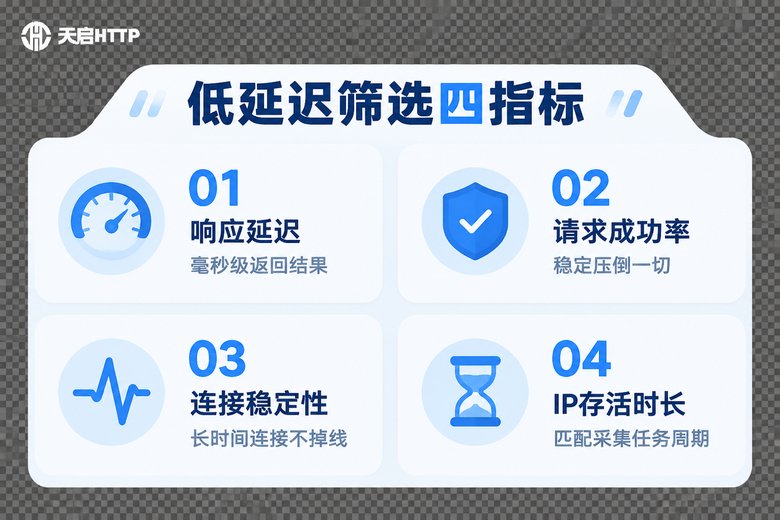
拿到一批代理IP,不能直接全扔进程序里用,先按这四个指标过一遍筛子:
1. 响应延迟。这是金融采集的第一指标。从发出请求到收到响应的往返时间(RTT),建议控制在200毫秒以内,行情轮询类任务越低越好。延迟不仅取决于代理服务器本身的性能,还和代理节点到目标站点的链路距离有关,选国内节点覆盖广的服务商,更容易命中低延迟线路。
2. 请求成功率。连续发起多次请求,统计成功比例。成功率低于95%的IP会持续拖垮任务节奏,金融采集建议把门槛设在99%以上。
3. 连接稳定性。延迟低还不够,还要稳。观察一段时间内延迟的波动情况(方差),忽快忽慢的IP说明链路质量差,高峰期大概率掉链子。
4. IP存活时长。IP从可用到失效的时间要和你的采集周期匹配。短周期任务用短效IP没问题,但长跑型任务就要确保失效前能无缝切换到新IP。
筛选实操:给IP池做一次“体检”
筛选的本质就是拉取 → 质检 → 排序入库三步。核心思路是:用真实的目标接口去测,而不是用通用测试地址,这样测出来的延迟才有参考价值。下面是一段可直接改造使用的Python示例:
import requests
import time
from concurrent.futures import ThreadPoolExecutor

# 1. 通过API提取接口拉取代理IP列表
def fetch_proxies(api_url):
    resp = requests.get(api_url, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

# 2. 单个IP质检:测延迟、验可用性
def check_proxy(proxy):
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        resp = requests.get("https://你的目标数据接口",
                            proxies=proxies, timeout=3)
        latency = int((time.time() - start) * 1000)
        if resp.status_code == 200 and latency <= 200:
            return {"proxy": proxy, "latency": latency}
    except requests.RequestException:
        return None

# 3. 并发质检,按延迟从低到高排序入库
def build_ip_pool(api_url):
    proxy_list = fetch_proxies(api_url)
    with ThreadPoolExecutor(max_workers=20) as pool:
        results = list(pool.map(check_proxy, proxy_list))
    usable = [r for r in results if r]
    usable.sort(key=lambda x: x["latency"])
return usable几个实操细节值得注意:质检请求要带超时时间,避免被慢IP拖住整个流程;并发质检能大幅缩短筛选耗时;通过筛选的IP按延迟排序,优先使用最快的IP,慢的作为备用。建议每隔几分钟重新质检一轮,及时淘汰质量下降的IP。
配置实践:让代理在程序里稳定跑
筛出好IP只是第一步,配置不当照样会翻车。金融采集场景下,重点做好三件事:
一是失败自动切换。任何IP都可能随时失效,程序必须做到:请求失败立即换下一个IP重试,而不是傻等或报错退出。
二是连接复用。对同一目标站点的连续请求,尽量复用连接(keep-alive),减少反复握手带来的额外延迟,这对高频轮询场景提升明显。
三是合理的请求节奏。即使手里有一池好IP,也别对单个IP无节制地压请求,设置随机化的请求间隔和并发上限,让IP池的消耗速度和补充速度保持平衡。
一个带自动轮换和重试的请求封装示例:
import itertools
import requests

class ProxyRotator:
    """按延迟顺序轮换代理,失败自动切换下一个"""
    def __init__(self, ip_pool):
        self.pool = itertools.cycle(ip_pool)

    def get(self, url, max_retry=3):
        for _ in range(max_retry):
            proxy = next(self.pool)
            try:
                resp = requests.get(
                    url,
                    proxies={"http": f"http://{proxy}",
                             "https": f"http://{proxy}"},
                    timeout=3
                )
                if resp.status_code == 200:
                    return resp
            except requests.RequestException:
                continue  # 当前IP异常,立即切换
        raise RuntimeError("IP池可用代理耗尽,请补充新IP")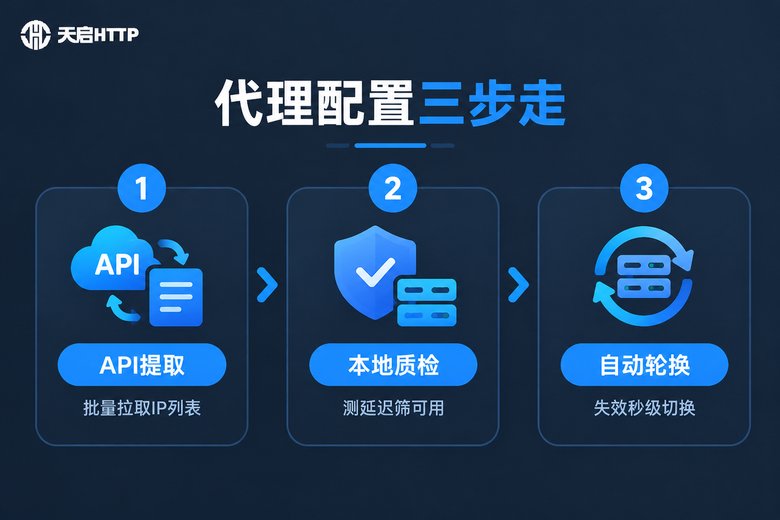
选对服务商,筛选工作事半功倍
自己搭质检流程解决的是“筛”的问题,而IP的“底子”好不好,取决于服务商。底子差的IP池,筛到最后可能所剩无几。
以天启HTTP为例,它是专注国内场景的IP代理服务商,IP资源覆盖国内多个城市,抓取国内行情站点、财经资讯平台等数据源时,链路距离近,天然更容易拿到低延迟线路。接入方式上,天启HTTP支持HTTP/HTTPS/SOCKS5等常用协议,既可以通过API批量提取IP配合上文的自建质检流程,也提供隧道代理这类免维护的接入方式——由服务端自动处理IP轮换,省去自己管理IP池的精力。使用中遇到问题,还有7×24小时技术支持响应。
建议大家先小规模提取一批IP,用上面的质检脚本实测延迟和成功率,用数据说话,再决定接入方式。
常见问题
Q: 金融数据抓取延迟多少算合格?
一般请求往返控制在200毫秒以内比较理想,行情轮询类任务建议更低。延迟不仅取决于代理本身的质量,还与代理节点到目标站点的距离有关,选国内节点覆盖广的服务商更容易命中低延迟线路。
Q: 免费代理能用来抓金融数据吗?
不建议。免费代理延迟高、成功率低、随时可能失效,而金融采集对时效和稳定性要求苛刻,用免费代理往往导致数据滞后、任务反复中断,排查问题花的时间比省下的成本多得多。
Q: IP池多久需要更换一次?
不要依赖固定周期,建议让程序内置自动质检和轮换逻辑:IP失效或延迟超标就自动切换并补充新IP,池子里始终保持一批经过验证的可用代理。
Q: 天启HTTP支持哪些接入方式?
天启HTTP支持HTTP/HTTPS/SOCKS5等常用协议,可通过API批量提取IP自行管理,也提供隧道代理等免维护接入方式,具体可在官网了解并实际测试。
Q: 请求频率怎么控制比较稳妥?
即使使用代理IP池,也要对单个IP设置合理的请求间隔,配合随机化间隔和并发上限,避免把优质IP的请求配额快速耗尽,让IP的消耗与补充保持动态平衡。