
写爬虫的人迟早都会遇到两件事:目标网站把你的IP限流甚至封禁,以及单线程抓取慢得让人着急。解决办法其实是同一套组合拳——SOCKS5代理负责换出口,并发优化负责提速度。这篇文章从最基础的配置写起,一路讲到异步并发和代理池调度,看完就能直接用到自己的项目里。
一、为什么Python爬虫更适合SOCKS5代理
常见的代理协议有两种:HTTP代理和SOCKS5代理。HTTP代理工作在应用层,它"看得懂"你的HTTP请求,也因此可能改写请求头;SOCKS5工作在更底层的会话层,只负责把数据包原样转发出去,不关心内容是什么。对爬虫来说,这个区别带来三个实际好处:
1. 兼容性更广。HTTP、HTTPS流量都能走,一些非HTTP协议的请求也能代理,采集链路里不管是调接口还是拉文件都不用换方案。
2. 特征更少。SOCKS5不改写请求内容,目标服务器很难从请求头里发现代理的痕迹,配合合理的采集频率,不容易被针对。
3. 高并发更轻量。协议开销小,成百上千个并发连接同时跑的时候,SOCKS5的转发效率优势会体现出来。
| 对比项 | SOCKS5代理 | HTTP代理 |
|---|---|---|
| 协议层级 | 会话层,转发TCP/UDP | 应用层,仅HTTP/HTTPS |
| 请求内容 | 原样透传,不改动 | 可能改写请求头 |
| 流量特征 | 更难被识别 | 特征相对明显 |
| 典型场景 | 爬虫采集、高并发任务 | 普通网页访问 |
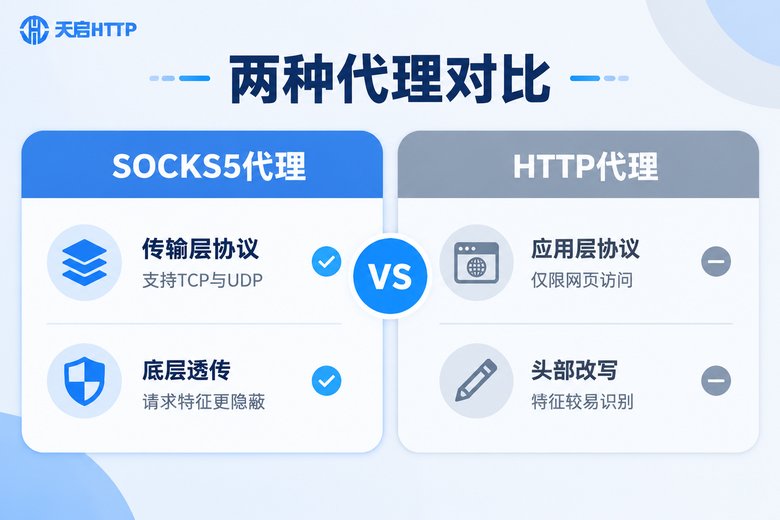
一句话总结:短平快的小脚本用HTTP代理没问题,长期跑、大批量的采集任务,SOCKS5是更稳妥的选择。
二、requests配置SOCKS5代理:三步接入
requests默认不支持SOCKS5,先装一个依赖包:
pip install requests "requests[socks]"然后在请求里传入proxies参数:
import requests

proxies = {
    "http": "socks5://用户名:密码@代理IP:端口",
    "https": "socks5://用户名:密码@代理IP:端口",
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json())  # 返回的origin应该是代理IP,说明配置生效
三个新手最容易踩的坑:
坑一:socks5和socks5h选错。socks5表示在本地解析域名,socks5h表示把域名解析也交给代理服务器完成。做爬虫建议统一用socks5h,避免本地DNS解析结果和出口IP不匹配带来的问题:
proxies = {
    "http": "socks5h://用户名:密码@代理IP:端口",
    "https": "socks5h://用户名:密码@代理IP:端口",
}坑二:不设timeout。走代理的链路比直连更长,遇到失效IP时,没有超时的请求会一直挂着,并发场景下一个卡死的请求就能拖垮整个任务。所有走代理的请求都必须带timeout。
坑三:跳过验证直接上量。正式采集前,先用httpbin.org/ip这类回显服务确认出口IP确实变成了代理IP,再放量。多花一分钟验证,能省掉后面几小时的排查。
三、并发实战:aiohttp + SOCKS5代理池
requests是同步库,一秒只能发有限的请求,想提速就得上异步。Python里做高并发采集的主流组合是aiohttp,配合aiohttp-socks让所有请求走SOCKS5:
pip install aiohttp aiohttp-socks下面是一个完整可跑的示例:3个代理IP,每个代理分到一批URL,各自独立并发跑:
import asyncio
import aiohttp
from aiohttp_socks import ProxyConnector

PROXY_LIST = [
    "socks5://用户名:密码@IP1:端口",
    "socks5://用户名:密码@IP2:端口",
    "socks5://用户名:密码@IP3:端口",
]

async def fetch(session, url):
    try:
        timeout = aiohttp.ClientTimeout(total=10)
        async with session.get(url, timeout=timeout) as resp:
            if resp.status == 200:
                return await resp.text()
    except Exception:
        return None
    return None

async def run_batch(proxy_url, urls):
    # limit 是这条代理通道的连接池上限
    connector = ProxyConnector.from_url(proxy_url, limit=30)
    async with aiohttp.ClientSession(connector=connector) as session:
        results = await asyncio.gather(*[fetch(session, u) for u in urls])
        return [r for r in results if r]

async def main():
    urls = [f"https://example.com/page/{i}" for i in range(300)]
    # 把URL平均切给每个代理,并行执行
    step = len(urls) // len(PROXY_LIST) + 1
    chunks = [urls[i:i + step] for i in range(0, len(urls), step)]
    tasks = [run_batch(p, c) for p, c in zip(PROXY_LIST, chunks)]
    done = await asyncio.gather(*tasks)
    print(f"成功 {sum(len(r) for r in done)} / {len(urls)}")

asyncio.run(main())
这种"按代理分组"的架构有两个好处:一是每个代理的连接池互相独立,单个IP出问题不会殃及全局;二是负载天然均衡,方便统计每个IP的成功率,及时淘汰表现差的节点。
如果不想分组,也可以在请求层面轮换——每次请求前随机挑一个代理,配合requests同样适用:
import random

def get_proxy():
    return random.choice(PROXY_LIST)

resp = requests.get(
    url,
    proxies={"http": get_proxy(), "https": get_proxy()},
    timeout=10,
)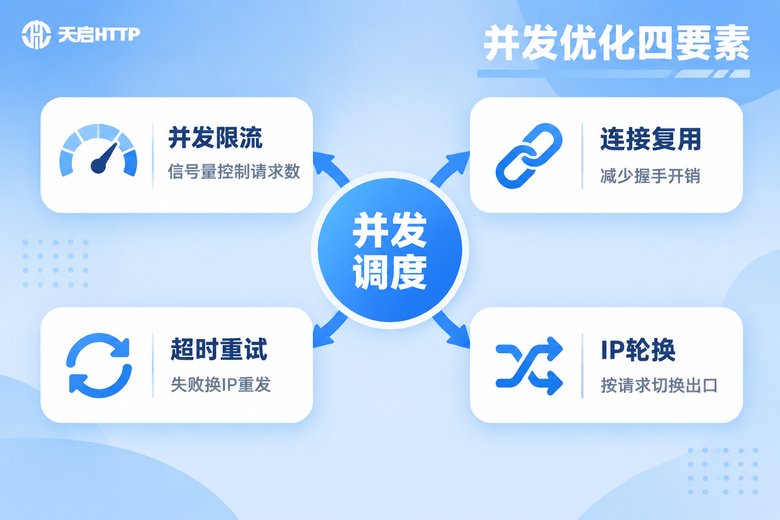
四、并发调优的五个关键细节
并发不是把数字调大就完事,调猛了轻则超时重试堆积,重则整批IP一起被封。下面五点决定了你的爬虫是"高效采集"还是"高效被封"。
1. 用信号量给并发上闸。asyncio.Semaphore是最简单的限流手段,全局最多允许N个请求同时在飞:
sem = asyncio.Semaphore(20)  # 最多同时20个请求

async def fetch_limited(session, url):
    async with sem:
        return await fetch(session, url)
2. 复用Session和连接池。每个请求都新建连接要多一次握手开销。把所有请求放进同一个ClientSession(requests里对应Session对象),配合connector的limit参数控制连接池大小,平均延迟能明显下降。
3. 超时、重试、换IP三件套。失败请求不要原地硬重试,正确姿势是:超时设10秒左右 → 失败后随机换一个代理IP重发 → 重试2次仍失败就记入死信队列,任务结束后统一补采:
import time

def fetch_with_retry(url, max_retry=3):
    for _ in range(max_retry):
        proxy = random.choice(PROXY_LIST)
        try:
            resp = requests.get(
                url,
                proxies={"http": proxy, "https": proxy},
                timeout=10,
            )
            if resp.status_code == 200:
                return resp.text
        except Exception:
            time.sleep(1)  # 稍作退避,换IP再试
    return None
4. IP轮换频率要匹配风控强度。风控松的站点,一个IP跑几百个请求没问题;风控严的站点,可能每个请求都得换出口。天启HTTP提供API批量提取接口,可以按需把新鲜IP灌进代理池,轮换逻辑直接读池子就行。
5. 不同规模用不同参数。别拍脑袋定并发数,参考下面这张表起步,再根据实际成功率微调:
| 采集规模 | 建议并发数 | 连接池limit | 超时 | IP轮换频率 |
|---|---|---|---|---|
| 小规模(日采1万页以内) | 10–20 | 20–30 | 10秒 | 每100请求一换 |
| 中规模(1–10万页) | 30–50 | 50–100 | 10–15秒 | 每20–50请求一换 |
| 大规模(10万页以上) | 50–100 | 100–200 | 15秒 | 尽量每请求一换 |
五、稳定好用的SOCKS5代理从哪来
网上扫免费代理再逐个验证?能跑,但可用率低、速度飘忽,维护成本比写爬虫本身还高。正经做采集,建议直接用付费代理服务,把精力留给业务逻辑。
这里推荐天启HTTP。它是国内的IP代理服务商,同时支持HTTP、HTTPS、SOCKS5协议,本文所有的配置代码拿过来就能用。对爬虫场景比较友好的几点:
多城市节点可选:IP资源覆盖国内多个城市,可以按业务需要指定出口地区;
API批量提取:提供提取链接,拉下来的IP列表直接灌进你的代理池,配合上面的轮换逻辑即插即用;
两种授权方式:支持账密认证和IP白名单,用白名单的话连密码都不用写进代码,安全性更好;
面向国内业务:节点都在国内,采集国内站点的延迟和稳定性表现更好。如果你的目标站点在海外,需要另行选择对应的方案。
接入流程也简单:注册账号 → 选择合适的套餐 → 在后台拿到API提取链接和账密 → 按本文第二节的写法填进代码。顺利的话,十分钟内就能跑通第一个带代理的请求。
常见问题
Q:socks5和socks5h到底怎么选?
A:爬虫场景优先socks5h,域名解析交给代理服务器完成,本地不接触解析过程,能避免DNS污染和解析结果与出口IP不匹配的问题。只有在确实需要本地控制解析结果时才用socks5。
Q:配置了代理,目标网站为什么还是能识别我?
A:常见原因有三个:一是请求头里带了暴露真实信息的字段,检查一下自定义headers;二是这批IP本身已被目标站限制,换一批IP对比测试;三是并发太高触发频控,先把并发降到10以内,稳定后再逐步上调。
Q:并发数是不是越高越好?
A:不是。并发上限取决于目标网站的承受能力、代理IP质量和你的业务容忍度。经验做法是从10并发起步,观察成功率和响应时间,每次上调20%左右,一旦失败率明显上升就回调。盲目拉高并发只会换来整批IP被封。
Q:aiohttp-socks连接失败怎么排查?
A:分三步:先用curl --sock5 代理IP:端口 httpbin.org/ip 在命令行验证代理本身通不通;再检查账密里的特殊字符是否需要URL编码;最后确认并发连接数没有超过服务商的单IP连接限制。
Q:天启HTTP支持SOCKS5吗?怎么接入?
A:支持。天启HTTP同时提供HTTP、HTTPS和SOCKS5协议,在后台获取代理地址和账密后,按本文第二节、第三节的代码填入即可。注意它是国内IP服务商,适合采集国内站点,海外业务场景需要另选方案。