
长效代理IP买回来,最怕的就是"用着用着就掉线":任务跑到一半连接中断、脚本频繁报错重跑、账号登录状态反复失效。掉线不仅浪费时间,还可能直接影响业务成果。这篇文章就把话说透:长效IP为什么会掉线,以及购买之后如何通过一套可落地的优化方案,把稳定性牢牢握在自己手里。
掉线不可怕,可怕的是不知道为什么掉
不少朋友一遇到掉线,第一反应就是"IP质量不行",急着找服务商理论。但实际排查下来,掉线的原因往往不止一个,既有服务商侧的因素,也有自己使用方式的问题。先看下面这张图,对照自查一下:
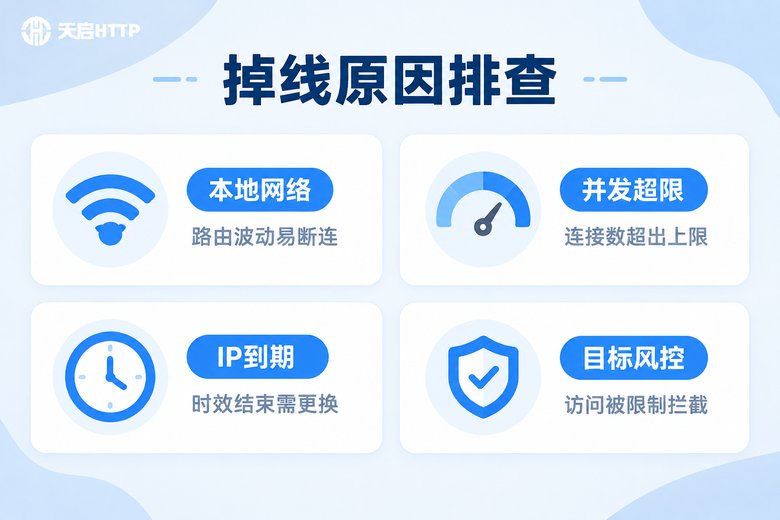
逐条展开说明:
1. 本地网络波动。家庭宽带、办公室Wi-Fi本身不稳定,再优质的IP也救不了。跑长期任务时,尽量选择有线网络环境,并避开路由器重启、带宽被占满等时段。
2. 并发超限。一个IP同时挂几百个连接,任何服务商都扛不住,掉线是必然结果。并发要和IP的承载能力匹配,而不是硬怼。
3. IP时效到期。长效IP也有生命周期,短则数小时、长则数天,到期不更换,连接自然中断。这属于正常现象,关键是到期前要有应对机制。
4. 目标网站风控。访问频率过高、行为特征太机械,被目标方判定为异常流量并限制访问,表现出来的也是"掉线"。这种情况换IP也没用,要改的是访问方式。
优化方案一:把客户端配置调好,稳定性提升一大半
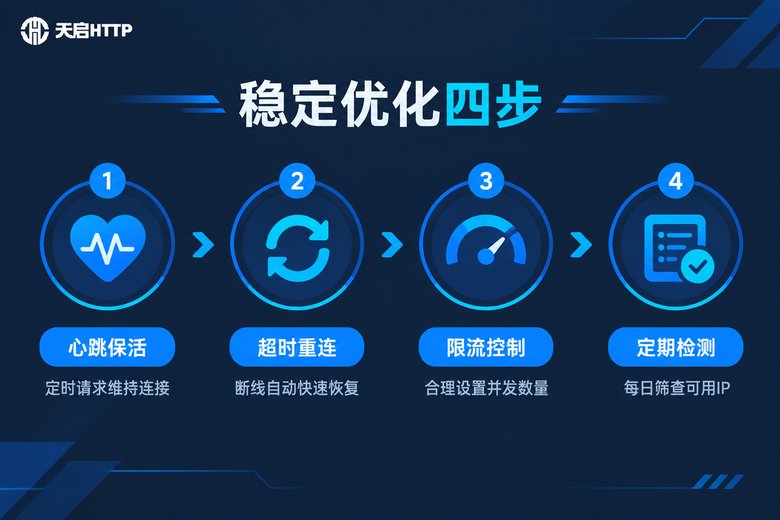
很多掉线问题,根源在客户端配置太粗糙。以下三个设置,建议每个跑长期任务的人都逐一检查。
第一,开启心跳保活。长连接如果长时间没有数据传输,中间的链路设备可能主动掐断连接。解决办法很简单:定时发一个轻量请求,让连接始终保持"活着"的状态。比如每30秒请求一次目标站点的轻量接口,就能大幅减少莫名的断连。
第二,配置超时重连与失败重试。网络抖动不可避免,关键是断了之后能不能快速恢复。建议把连接超时设置在3~5秒、读取超时10~15秒,并配合指数退避的重试策略,避免重试请求把链路打崩。一个简单的示例:
import requests
import time

PROXY = {
    "http": "http://用户名:密码@代理IP:端口",
    "https": "http://用户名:密码@代理IP:端口"
}

def fetch_with_retry(url, max_retries=3):
    """带超时控制与指数退避重试的请求示例"""
    for i in range(max_retries):
        try:
            resp = requests.get(url, proxies=PROXY, timeout=(3, 10))
            if resp.status_code == 200:
                return resp.text
        except Exception:
            time.sleep(2 ** i)  # 依次等待1秒、2秒、4秒
return None第三,合理设置并发数。长效IP的价值在于"稳定长会话",而不是"暴力并发"。单IP并发建议控制在个位数到十几位;确有大批量需求时,应该向服务商申请提升配额,或者用多条IP分流任务,而不是把压力全部压在一个IP上。
优化方案二:建立IP健康检测与自动轮换机制
想做到"基本不掉线",光靠被动重连还不够,要主动出击,把问题消灭在发生之前。
定期可用性检测:写一个简单的定时任务,每隔几分钟对IP池里的IP做一次轻量探测,响应超时或返回异常的IP标记为"待观察",连续多次失败的直接剔除。这样业务主流程永远只拿到健康的IP,从源头减少报错。
自动轮换补位:被剔除的IP要能自动从服务商的API重新提取补充,保证池子里可用数量恒定。像天启HTTP这类支持API批量提取的服务商,配合几十行脚本就能实现"检测—剔除—补充"的全自动闭环,全程无需人工盯守。
会话保持:长效IP最大的优势是长时间维持同一出口IP,这对需要保持登录态的业务(比如账号运营、店铺管理)非常关键。日常要避免频繁手动切换IP,否则登录状态反复失效,比掉线还麻烦。确需更换时,尽量安排在业务空闲时段操作。
优化方案三:控制访问节奏,别让风控盯上你
还有一种"掉线",本质是目标网站把你限制了。IP本身没问题,但访问行为太猛,被对方判定为异常并封禁。规避思路有三条:
1. 请求频率人性化。在请求之间加入随机间隔,比如1~3秒的随机延迟,模拟真人操作节奏,不要用固定间隔"哒哒哒"地扫射。
2. 请求头信息完整且一致。带上常规的User-Agent、Referer等字段,并保持同一IP下的请求特征统一——频繁变换指纹反而更容易暴露。
3. 分时段错峰执行。把大批量任务拆分到不同时段执行,避开目标站点的高峰期,既降低触发风控的概率,整体成功率也更稳定。
优化方案四:选对服务商,稳定性事半功倍
前面说的都是"自己能做的事",但有一点必须承认:IP的底层质量,决定了稳定性的上限。再精细的客户端优化,也弥补不了IP资源本身的硬伤。挑选长效IP服务商时,重点看下面这几个维度:
| 考察维度 | 合格标准 | 对稳定性的意义 |
|---|---|---|
| 机房资源 | 自建机房,非二手转租 | 链路可控,故障响应快 |
| 节点覆盖 | 覆盖国内主要城市 | 就近接入,延迟更低 |
| IP可用率 | 99%以上并支持复检 | 从源头减少无效IP |
| 协议支持 | HTTP/HTTPS/SOCKS5 | 适配各类业务工具 |
| 售后服务 | 7×24小时技术支持 | 出问题有人管、管得快 |
以天启HTTP为例,它采用自建机房池,节点覆盖国内200多个城市,IP可用率保持在99%以上,支持HTTP/HTTPS/SOCKS5三种协议,并提供API批量提取和7×24小时技术支持。对长效IP这种高稳定性要求的业务来说,遇到问题能第一时间找到技术响应,体验上的差别是非常明显的。
另外提醒一句:长效IP属于国内业务场景的解决方案,如果你的业务目标在海外,选购前一定要先和客服确认清楚适用范围,避免买完才发现用不上。
写在最后
长效代理IP的稳定性,从来不是单点问题,而是"IP质量 + 客户端配置 + 使用策略 + 服务保障"四件事共同作用的结果。把心跳保活、超时重连、并发控制、定期检测这几项基础工作做扎实,再叠加一家靠谱的服务商,掉线问题基本可以压缩到可以忽略的水平。稳定不是运气,而是一套可以复制的工程化方案。
常见问题
Q: 长效IP一般能维持多久不断线?
长效IP的有效时长由服务商的IP生命周期决定,短则数小时,长可达数天。但"有效"不等于"全程不断连",中间仍可能因网络抖动、目标风控等原因出现短暂中断,需要靠重连机制和健康检测来兜底。
Q: 掉线后应该立刻换IP吗?
不建议。先判断掉线原因:如果是本地网络抖动或瞬时超时,重连即可恢复;只有确认IP已失效或被目标方限制时,才需要更换。频繁换IP反而会丢失会话状态,得不偿失。
Q: 一个长效IP挂多少并发比较安全?
没有绝对标准,但经验值是单IP并发控制在5~15之间比较稳妥。具体上限受IP带宽和目标站点承受能力影响,建议从小并发开始逐步加压测试,找到稳定临界点后再放量。
Q: 为什么凌晨时段掉线反而更多?
很多业务习惯把大批量任务安排在凌晨集中跑,单IP压力骤增;同时凌晨也是链路维护、网络调整的高发时段。建议错峰分配任务,并适当加强凌晨时段的心跳检测频率。
Q: 选购长效IP前需要确认哪些信息?
重点确认三件事:IP类型是否匹配自己的业务场景、并发和提取规则是否符合使用量、是否有技术支持兜底。可以直接通过天启HTTP官网咨询客服,其7×24小时技术支持能在选购前帮你确认方案是否合适,避免买完再踩坑。