
做数据采集的朋友大概都遇到过这种场景:脚本前半夜还跑得好好的,后半夜突然全是超时和403,一查才发现——IP被目标网站封了。更麻烦的是,现在很多网站的封禁策略是"来一次封一段",整个IP段都可能被拉黑。今天这篇文章就把IP被封的原因、高匿代理的作用、代理池轮换策略和实操技巧一次讲透,帮你把采集任务跑得又稳又久。
为什么你的采集IP总是被封?
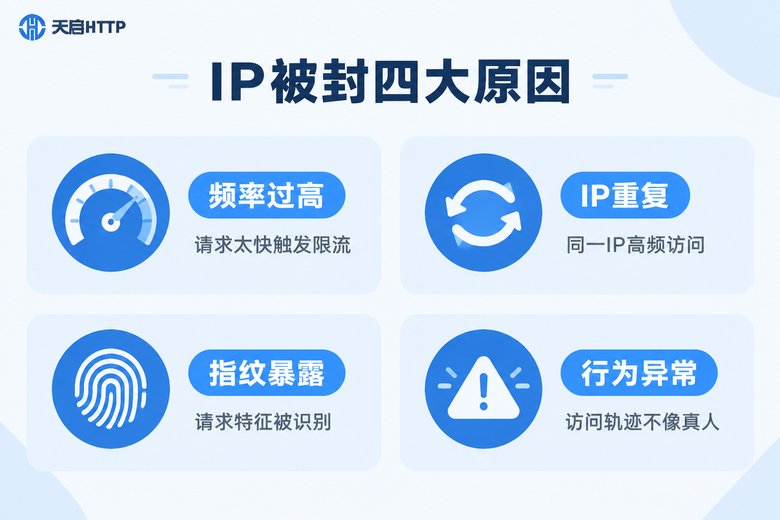
想解决问题,先搞懂对手的封禁逻辑。目标网站判断"你是不是爬虫",主要看四件事:
1. 请求频率过高。正常人不可能一秒钟翻几十页。当同一个IP在短时间内发出海量请求,触发限流几乎是必然的——先弹验证码,再不行就直接封IP。
2. IP重复访问。单个IP累计采集几千上万次,在对方访问日志里就是一条"异常突出"的记录,风控系统不盯你盯谁?
3. 请求特征暴露。很多脚本默认的User-Agent是python-requests,请求头里还带着各种可疑字段,等于明牌告诉对方"我是脚本"。
4. 行为轨迹机械。访问间隔精确到毫秒级一致、从不翻页、从不停留、不带Cookie,这种"机器人式"的行为模式很容易被识别。
高匿代理:数据采集的标配
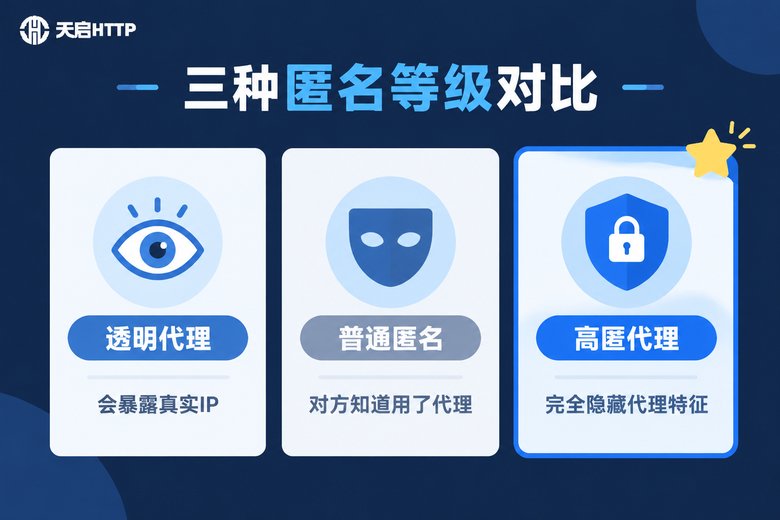
解决IP被封最直接的办法,就是别用真实IP去采集——这时候就需要代理IP。但代理也分三六九等,匿名等级直接决定你"藏得好不好":
| 代理类型 | 对方看到的IP | 能否识别出代理 | 采集适用度 |
|---|---|---|---|
| 透明代理 | 你的真实IP | 完全能看到 | 基本没用 |
| 普通匿名 | 代理IP | 知道你用了代理 | 勉强能用 |
| 高匿代理 | 代理IP | 完全看不出来 | 首选 |
高匿代理的核心优势在于:它不会在请求头里添加暴露代理身份的字段,目标网站看到的就是一个再普通不过的访问者。再配合代理池不断更换IP,对方既不知道你的真实IP,也无法通过"同一个IP反复访问"来封你。
这里要提醒一句:免费代理慎用。免费IP存活时间短、速度慢、可用率低,还可能被很多人同时使用,拿来做正式业务得不偿失。正经的采集项目,建议直接上付费高匿代理池。
代理池轮换的四种主流策略
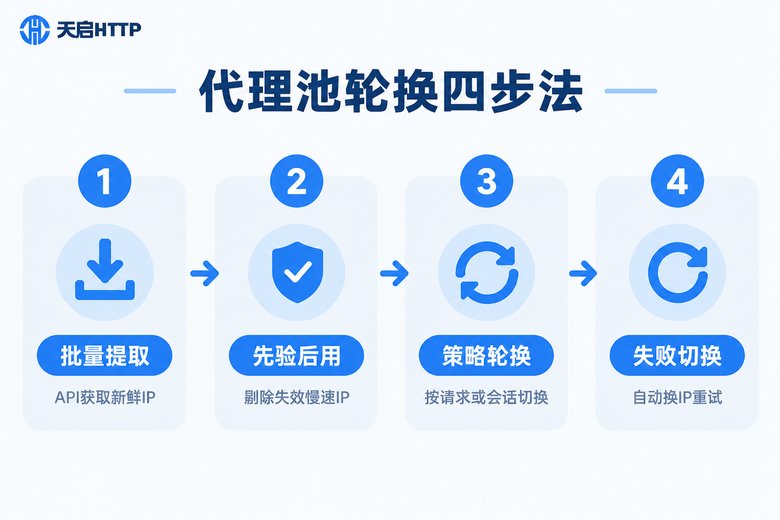
有了代理池,怎么"轮"是门学问。轮换策略选对了,被封概率能直接降一个量级。常用的有四种:
1. 按请求轮换。每发一个请求就换一个IP,池子里的IP被均匀消耗,单个IP的压力最小。适合列表页、详情页这类无状态的抓取任务。
2. 按会话保持。同一个任务在一段时间内固定使用同一个IP,等这轮任务跑完再换。适合需要维持登录态或Cookie连续性的场景,注意要在IP的存活期内把会话跑完。
3. 定时轮换。每隔固定时间(比如5分钟)统一更换一批IP,节奏可控,便于和目标网站的限流周期"错峰"。
4. 失败自动切换。请求失败、返回异常状态码或触发验证码时,立刻丢弃当前IP、换新IP重试。这是代理池的"保底机制",无论用哪种策略都建议配上。
实战中往往是组合拳:平时按请求轮换,遇到需要会话的任务切到会话保持,再叠加失败自动切换兜底,稳定性最好。
实战代码:Python接入代理池
下面用一个简单的Python示例,演示"按请求轮换 + 失败自动切换"怎么写。以天启HTTP为例,在后台获取API提取链接后,几十行代码就能跑起来:
import requests
import random
import time

def get_proxies():
    """从API提取链接拉取一批代理IP,每行一个 ip:port"""
    api_url = "你的天启HTTP API提取链接"
    resp = requests.get(api_url, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

proxy_pool = get_proxies()

def crawl(url, max_retry=3):
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
    for _ in range(max_retry):
        ip = random.choice(proxy_pool)   # 按请求轮换:随机取一个IP
        proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
        try:
            r = requests.get(url, proxies=proxies,
                             headers=headers, timeout=10)
            if r.status_code == 200:
                return r.text
        except Exception:
            time.sleep(1)                # 失败自动切换:换IP重试
return None这段代码的关键点有两处:random.choice实现了最简单的按请求轮换;max_retry循环实现了失败换IP重试。实际项目中,还可以把失效IP从池子里剔除、定期重新拉取新IP,让代理池始终保持"新鲜血液"。
降低被封概率的六个细节
代理池解决的是"IP层面"的问题,但风控看的不只是IP。想让采集任务跑得长久,这些细节也要做到位:
| 细节 | 解决什么问题 | 建议做法 |
|---|---|---|
| 随机延时 | 频率过高 | 请求间隔1~5秒随机 |
| UA轮换 | 请求头单一 | 准备一组常见浏览器UA随机使用 |
| 并发控制 | 压力过大 | 单IP并发控制在1~3个 |
| Cookie管理 | 行为不像真人 | 合理携带和更新Cookie |
| 轨迹模拟 | 访问路径机械 | 随机翻页、随机停留 |
| 失败降速 | 被限流后硬冲 | 触发限制先降频,再逐步恢复 |
记住一个原则:采集的本质是"伪装成很多个正常用户"。IP靠代理池轮换,行为靠上面的细节打磨,两头都做到位,被封的概率自然就下来了。
选对服务商:天启HTTP
策略再好,也需要一个给力的代理池。做国内数据采集,可以了解一下天启HTTP。
天启HTTP是国内IP代理服务商,提供的代理IP默认高匿名,采集时目标网站看不到你的真实IP;支持通过API批量提取代理IP,方便像上面的示例那样接入自己的代理池做自动轮换;IP池规模大、可用率高,无论是按请求轮换还是会话保持,都能找到合适的用法。
需要特别说明的是:天启HTTP只适用于需要国内IP的业务场景,比如国内网站的数据采集、SEO监测、舆情分析等;如果你的目标网站在海外、需要海外IP,那它并不适用。具体套餐和最新价格,建议直接到天启HTTP官网查看,以官网信息为准。

常见问题
Q: 用了高匿代理就一定不会被封吗?
不是绝对的。高匿代理解决的是"身份暴露"问题,如果请求频率过高、行为特征太机械,照样会被封。高匿代理要配合轮换策略和频率控制一起用,才能把被封概率降到最低。
Q: 代理IP多久换一次比较合适?
取决于目标网站的风控强度。一般建议按请求轮换或按任务轮换;如果目标网站限流严格,可以用短效动态IP,存活期短、天然高频轮换。先小流量测试,观察多久开始出现验证码,再确定轮换周期。
Q: 免费代理IP能用于数据采集吗?
练手可以,正式业务不建议。免费IP可用率低、速度慢、存活时间短,还常常被很多人共用,采集效率低且不稳定,出问题后的排查成本反而更高。
Q: IP已经被封了怎么办?
先暂停采集,避免"火上浇油";然后检查请求头和行为特征是否暴露;等封禁解除或直接换一批新IP,降低频率后小流量恢复,确认稳定再逐步提速。
Q: 天启HTTP适合哪些场景?
适合需要国内IP的业务,比如国内网页数据采集、爬虫、SEO监测、舆情分析等。需要海外IP的场景不适用,选购前先确认好自己的业务需求。