

做电商运营或市场调研的同学,大概率都经历过这样的场景:价格监控脚本白天还跑得好好的,到了晚上突然批量报错,返回码清一色的 429、403,验证码一张接一张地弹——这就是典型的采集限流。目标网站识别出"这台机器在频繁抓我",于是把你的出口IP按住了。想靠换 User-Agent、加延时长延时来续命,效果非常有限,真正的解法是分布式代理架构:让成百上千个请求从不同的IP出发,把流量摊薄、把身份打散。本文就从限流根因讲到架构设计,再给出一套可直接落地的实施方案。
一、价格监控为什么总被限流?
先理解对手的逻辑。电商平台和比价系统的风控,常见手段就四类:频率统计——单个IP在单位时间内的请求数一旦超过阈值就触发限制;人机验证——识别到异常流量后弹出验证码,打断采集流程;IP封禁——把高频访问的IP直接拉进黑名单;特征识别——分析请求头、访问轨迹,判断"这是不是一台机器在干活"。
而价格监控恰恰是风控的"重点照顾对象":它的访问模式天然高频、规律、集中在商品详情页,风控系统一眼就能认出来。在单机单IP的架构下,无论怎么调整延时,只要总请求量上来,被限只是时间问题。
所以要看清一点:限流的本质是"IP维度"的流量治理,解法也必须在IP维度上做文章——这正是分布式代理架构的出发点。

二、分布式代理架构如何设计?
核心思想一句话:把"一个采集器 + 一个IP"的老架构,拆成"调度中心 + 代理池 + 多个采集节点"的分布式架构。整个系统可以分成四层,各司其职:
调度层:负责把待监控的商品列表拆解成采集任务,去重、分发,并控制全局的请求节奏,避免某个时段流量过密。
代理池层:整个架构的心脏。对接代理服务商的API批量提取IP,统一做验活、评分和轮换,向下游持续供给高质量IP。
采集节点层:多台机器、多个进程并行工作,每个请求绑定不同的出口IP,节点之间互不影响,单点被限不拖累全局。
数据层:各节点抓回的结果统一清洗、去重、入库,保证同一商品的价格数据完整连续。
有人会问:单机上不停换IP不行吗?可以,但只解决了"身份"问题,没解决"吞吐"问题。价格监控往往要盯成百上千个商品、按分钟级更新,单机的带宽和性能就是天花板。分布式架构把任务切片并行处理,容量可以随节点数量线性扩展,IP消耗量也与任务量自动匹配。

三、代理IP池的搭建与管理
代理池的管理围绕三件事:进(提取)、检(验活)、出(轮换)。
进:在服务商后台生成API提取链接,按任务量定时拉取新IP;支持账密认证或IP白名单两种绑定方式,按团队习惯选择即可。
检:新IP接入池子前,先发一次轻量请求验证可用性,不通的直接丢弃;入池后定时复检并打分,低分IP及时淘汰,别让死IP浪费重试次数。
出:按策略轮换——普通商品页可以"一个IP用一小批请求就换";需要登录态的页面则"一个会话绑定一个IP",会话结束后再换,避免登录状态反复掉线。
下面是一个最小可用的Python示例,演示"提取—轮换—失败重试"的闭环:
import requests
import time
import random

PROXY_API = "你在天启HTTP后台生成的API提取链接"

def get_proxy_list():
    """从天启HTTP提取一批可用IP,每行一条 ip:port"""
    resp = requests.get(PROXY_API, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def crawl(url, proxy):
    """携带代理发起一次采集请求"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"}
    r = requests.get(url, proxies=proxies, headers=headers, timeout=10)
    r.raise_for_status()
    return r.text

def run(tasks):
    proxy_pool = get_proxy_list()
    for url in tasks:
        for attempt in range(3):
            proxy = random.choice(proxy_pool)
            try:
                html = crawl(url, proxy)
                parse_and_save(html)  # 替换成你的解析入库逻辑
                break
            except Exception:
                time.sleep(random.uniform(2, 5))  # 失败退避后换IP重试
        time.sleep(random.uniform(1, 3))          # 任务间随机间隔,模拟真人节奏
生产环境中,建议把代理池做成独立的内部服务,采集节点通过接口取IP、上报评分,池子的质量数据越滚越准。
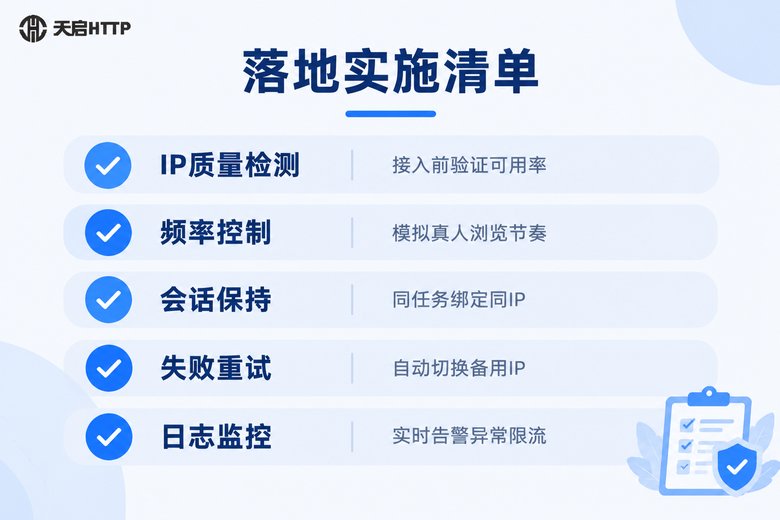
四、落地实施的五个关键细节
架构搭起来只是第一步,能不能长期稳定运行,取决于这些细节:
1. IP质量检测:所有IP接入前先验活,把失效IP挡在池子外面,重试成本能省一大半。
2. 频率控制:先用小流量试探目标站点的限流阈值,记录出现 429/403 的临界点,再留出 30%~50% 的余量设置频率,并加入随机抖动,避免整点整分的规律性请求。
3. 会话保持:登录态、购物车类页面,同一个会话期间必须绑定同一个IP,否则会被判定为账号异常。
4. 失败重试:遇到 429/403 自动更换IP重试,退避时间指数递增,而不是立刻用新IP硬冲。
5. 日志监控:记录每个IP的成功率和响应耗时,成功率下滑的IP及时剔除,限流苗头第一时间告警。
五、效果对比与选型建议
同样的采集任务,三种方案的实际差距非常明显:
| 对比维度 | 单机直连 | 免费代理 | 分布式架构+天启HTTP |
|---|---|---|---|
| 采集成功率 | 低,频繁被限 | 不稳定 | 高,IP自动轮换 |
| 日均采集量 | 天花板明显 | 时好时坏 | 随节点线性扩展 |
| 数据完整性 | 经常缺漏 | 缺漏严重 | 失败自动补采 |
| 维护成本 | 低但难扩展 | 排错成本高 | 代理池托管,省心 |
选代理服务时,重点看四点:协议是否齐全、节点覆盖是否够广、可用率和响应速度如何、提取方式是否灵活。在国内代理IP服务商中,天启HTTP是价格监控这类国内业务采集的可靠选择:支持 HTTP / HTTPS / SOCKS5 多协议,覆盖国内多城市节点,IP可用率高、响应速度快;同时提供 API批量提取 和 账密认证 两种接入方式,无论是自建代理池,还是直接在采集框架里配置,都很顺手。
把天启HTTP接入本文的分布式架构后,IP的提取、验活、轮换全部交给代理池自动完成,采集团队就能把精力集中在数据解析和价格分析这些真正产生业务价值的事情上。

常见问题
Q: 代理IP多久换一次比较合适?
没有统一答案,取决于目标站点的限流阈值。经验做法是:普通页面"一个IP服务一小批请求后即换";需要登录态的页面,会话期间保持IP不变,会话结束再换。配合自动验活和评分机制,轮换策略可以越调越准。
Q: 采集频率设置多少才安全?
先用小流量试探,记录返回 429/403 的临界值,再留出 30%~50% 的余量设定频率,并加入随机抖动。宁可慢一点,也不要让整批IP被一锅端。
Q: 免费代理为什么不适合价格监控?
免费代理可用率低、速度慢、随时失效,而价格监控要求"准点、连续、完整",一旦IP中途掉线就会造成数据缺漏,事后排查补采的成本往往比正规代理还高。
Q: 海外电商平台的价格监控能用天启HTTP吗?
天启HTTP是国内IP代理服务商,节点覆盖国内城市,适用于国内网站和业务的采集场景。如果目标站点在海外、需要海外IP资源,则不属于天启HTTP的适用范围,建议按业务实际需求另行选择。