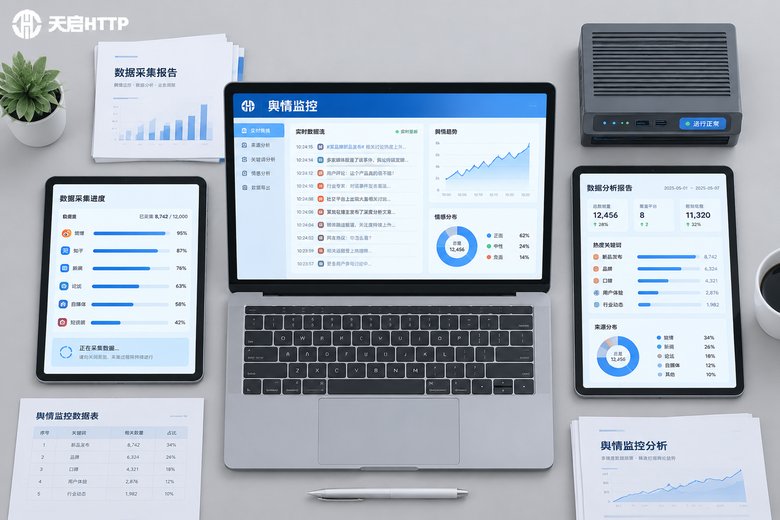
舆情监控系统到底在监控什么?
简单来说,舆情监控系统就是一台"全网雷达":它持续盯着新闻网站、社交平台、论坛贴吧、公众号这些信息源,把和品牌、产品、行业相关的讨论全部抓取下来,经过清洗和分析之后,一旦出现负面信息或突发事件,立刻报警通知相关负责人。
听起来不复杂,但真正落地时你会发现一个绕不开的坎——数据采集量太大了。一个中等规模的舆情项目,每天要抓取的页面动辄几十万甚至上百万,而目标平台为了保护自己,普遍设置了反爬机制:同一个IP短时间内高频访问,轻则弹出验证码,重则直接封禁。这时候,海量代理IP就成了整个系统的"氧气",没有它,再好的爬虫程序也跑不起来。
整体架构:分布式爬虫与代理IP池如何配合
一套能扛住海量采集任务的舆情监控系统,通常分成五层:
1. 任务调度层:把监控关键词、目标站点拆解成一个个具体的采集任务,分发给下游的爬虫节点。
2. 分布式爬虫层:多台服务器同时干活,每台节点只负责一部分站点或关键词,并行抓取,互不干扰。
3. 代理IP池层:所有爬虫节点的出网请求都走代理IP,每次请求或每个任务周期自动换IP,让目标平台看到的永远是"不同的访客"。
4. 数据处理层:抓回来的原始页面经过去重、正文提取、情感分析,变成结构化的舆情数据入库。
5. 预警展示层:根据敏感词命中、情感倾向、传播量等规则触发告警,推送到企业微信、短信或监控大屏。
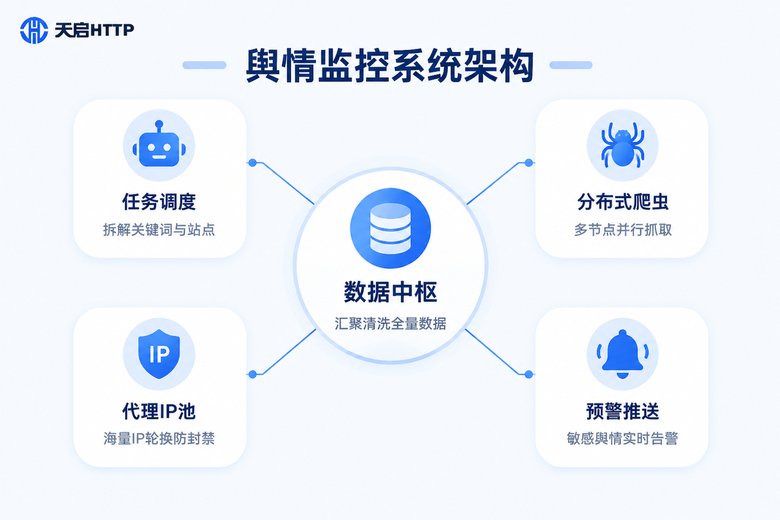
这五层里,代理IP池是串联一切的隐形基础设施。它不直接产生数据,却决定了爬虫层能不能持续、稳定地产出数据。
为什么舆情采集必须用海量代理IP?
很多刚入行的朋友会问:我一台服务器、一个IP,慢慢抓不行吗?小规模试水可以,但舆情监控有三个天然特点,决定了单一IP走不远:
第一,请求量巨大。舆情讲究时效性,热点事件几分钟内就可能刷屏,系统必须高频轮询各大平台,单IP的访问频率上限远远不够用。
第二,反爬规则严格。社交和资讯平台普遍按IP维度做频率限制和封禁,一个IP被标记,整条采集链路就断了。用海量IP轮换,等于把风险摊薄到成千上万个"身份"上,单个IP的压力小很多。
第三,需要多地区视角。有些内容展示带有地域属性,不同城市的访问者看到的信息并不一样。舆情监控要还原真实的传播全貌,就需要覆盖多城市的IP资源。
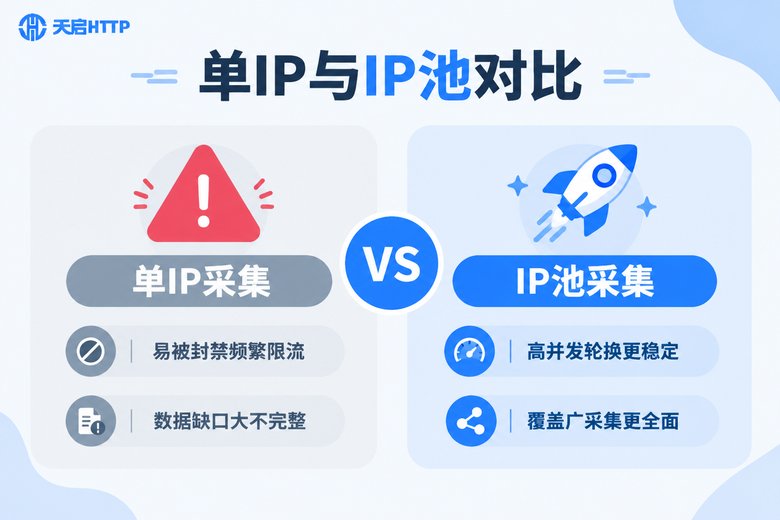
一句话总结:单一IP采集是"独木桥",海量IP池采集才是"高速公路"。两者在稳定性和数据完整度上的差距,会随着监控规模扩大越拉越大。
搭建步骤:五步跑通全流程
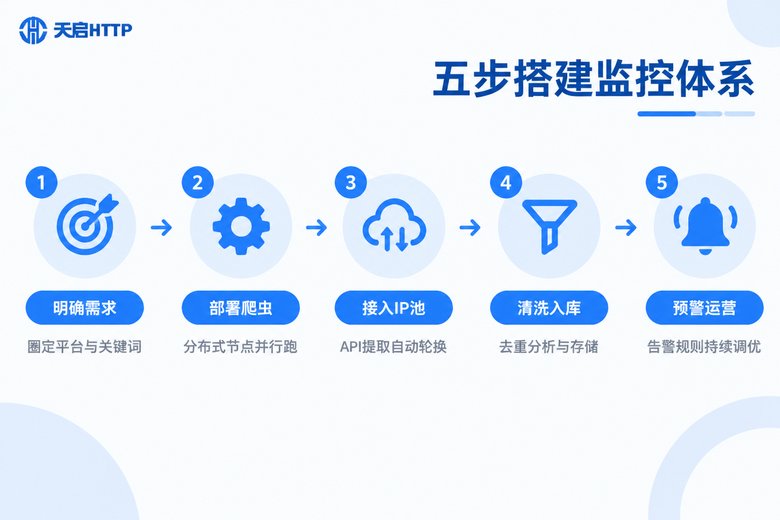
第一步,明确监控范围。先圈定要盯的平台(新闻站、社交平台、贴吧、行业论坛等)和关键词清单,这一步决定了后续所有资源投入的方向。
第二步,部署分布式爬虫框架。常用方案是 Scrapy + Redis 组成分布式任务队列,多台爬虫节点从同一个任务池领任务,天然支持横向扩容。
第三步,接入代理IP池。通过代理服务商的API接口批量提取IP,在爬虫的下载中间件里做自动轮换;失效IP及时剔除,新IP自动补充,保持池子"活水常流"。一个最简化的Python轮换示例如下:
import requests
import random

# 从代理服务商后台API提取的可用IP列表
proxy_pool = [
    "http://用户名:密码@183.xx.xx.1:端口",
    "http://用户名:密码@183.xx.xx.2:端口",
    "http://用户名:密码@183.xx.xx.3:端口",
]

def fetch(url):
    proxy = random.choice(proxy_pool)
    try:
        resp = requests.get(
            url,
            proxies={"http": proxy, "https": proxy},
            timeout=10,
        )
        return resp.text
    except Exception:
        # 请求失败说明该IP可能已失效,移出代理池
        proxy_pool.remove(proxy)
        return fetch(url)
生产环境中还要加上IP可用性预检、失败重试、并发数控制等逻辑,这里为了演示做了简化。
第四步,数据清洗与入库。用正文抽取算法去掉广告和模板内容,做去重和情感分析,存入 Elasticsearch 这类搜索引擎,方便后续按时间、平台、情感维度快速检索。
第五步,配置预警规则并持续运营。设置敏感词命中、负面占比升高、传播量激增等告警条件,并且每周复盘误报漏报情况,不断调优规则。
代理IP怎么选:舆情监控场景的四个硬指标
代理IP是舆情系统的"耗材",选型直接决定系统的稳定性和成本,重点看这四点:
1. IP池体量与可用率。池子越大,单个IP被复用的间隔越长,被封的概率越低;可用率越高,爬虫有效工作时间的占比越大。
2. 协议支持是否齐全。HTTP、HTTPS、SOCKS5最好都要支持,因为不同目标站点的采集方式不一样,协议不全就得中途换方案。
3. 提取与接入方式。支持API批量提取、账密认证,才能无缝嵌进爬虫中间件,实现全自动轮换。
4. 覆盖城市数量。城市覆盖越广,越能还原舆情传播的地域全貌。
| 采集环节 | 请求特点 | IP使用建议 |
|---|---|---|
| 新闻资讯抓取 | 量大、频率高 | 短效动态IP,高并发轮换 |
| 社交平台评论 | 反爬严格 | 高匿名IP,控制单IP频率 |
| 论坛贴吧监测 | 页面结构杂 | 可用率高的IP池稳定供给 |
| 数据复核校验 | 量小、要求准 | 少量IP固定使用,便于追踪 |
在国内做舆情监控,天启HTTP是比较对口的选择:它专注国内代理IP服务,自建机房,IP池规模大、可用率高,覆盖国内200多个城市,完整支持HTTP/HTTPS/SOCKS5三种协议,通过API即可批量提取,账密认证接入也简单,与Scrapy等主流爬虫框架的对接成本很低。需要提醒的是,天启HTTP只适用于国内业务场景,如果你的监控目标包含境外平台,需要另行评估方案。
实际落地时还有几个小经验:一是不要把并发一次性拉满,先小流量试跑,观察目标平台的容忍度再逐步加压;二是对重点站点单独配置IP策略,反爬越严的站点用越"新鲜"的IP;三是持续监控代理IP的响应时间,把慢IP降权处理,整体采集速度会明显提升。
常见问题
Q: 舆情监控系统一定要用付费代理IP吗?免费的不行吗?
免费IP可用率低、速度慢、随时失效,用来跑需要持续稳定运行的舆情采集,故障排查的时间成本远超省下的费用。舆情监控是长期工程,建议直接用正规付费服务商,把精力放在业务逻辑上。
Q: 多少IP量才算"海量"?中小团队需要多少?
没有绝对数字,关键看目标平台的封禁策略和你的采集频率。经验上,日采集量在几十万页面级别的项目,通常每天需要轮换数千到上万个IP。建议先按业务量估算,选择支持弹性提取的服务商,随用随取,避免浪费。
Q: 分布式爬虫节点越多越好吗?
不是。节点数量要和代理IP池的供给能力、目标平台的容忍度相匹配。节点多但IP跟不上,等于一群人挤独木桥,反而加速封禁。合理做法是IP池先行扩容,爬虫节点跟着加。
Q: 被目标平台封了IP怎么办?
先确认是临时限流还是永久封禁:临时限流就降低该IP的请求频率等待恢复;永久封禁则把IP移出代理池,从服务商处提取新IP补充。预防上,控制单IP并发、模拟正常访问节奏、使用高匿名代理,能大幅降低被封概率。
Q: 天启HTTP可以用来抓取境外网站吗?
天启HTTP是国内IP代理服务商,资源覆盖国内200多个城市,适用于国内平台和业务的采集场景。如果监控对象包含境外站点,它并不适用,需要另行选择对应方案。