做数据采集的朋友都遇到过同一个问题:任务列表几千条,单线程一个个请求地发,跑一整晚都采不完。于是大家开始提并发——可一旦把并发开满,又会遇到请求失败、IP被封、超时堆积。说白了,并发配置的本质,是在采集效率、请求成功率和IP消耗三者之间找平衡,而代理IP正是维持这个平衡的支点:并发越高,同时对外发请求的出口IP就越多、切换越频繁,IP池的容量和质量必须跟得上,否则参数调得再精细,也会被“连接失败”拖垮。
先搞懂:并发配置到底在调什么
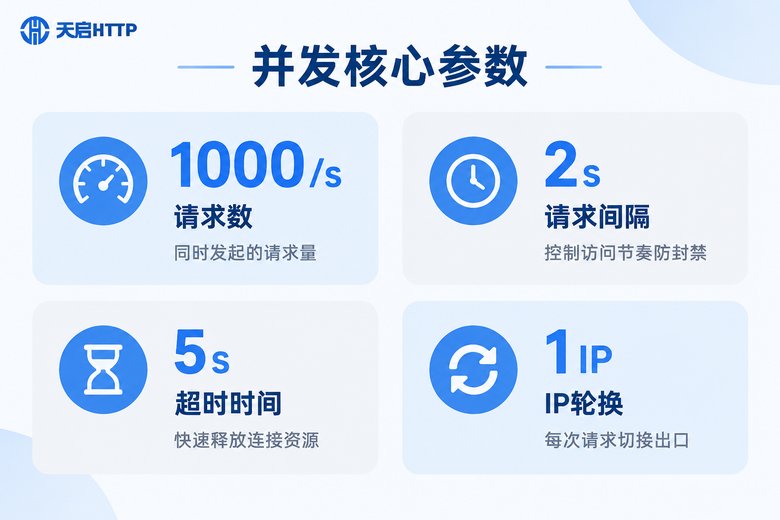
很多人以为并发配置就是填一个“线程数”,其实真正决定采集效果的,是四个参数的组合:
1. 并发数:同一时刻最多有多少个请求在跑,是效率的天花板;
2. 请求间隔:请求之间的停顿节奏,间隔太密容易触发目标网站的频率限制;
3. 超时时间:一个请求多久没响应就放弃,太短会误杀慢请求,太长会拖慢整体任务;
4. 重试机制:失败后是否换IP重发、重试几次,直接决定最终成功率。
这四个参数互相牵制:并发开大,单个IP在单位时间内的请求密度就会上升,必须配合更快的IP轮换;间隔拉长,总耗时增加,就要靠并发数把效率补回来。所以调优不是找某个“最优数值”,而是找一套互相匹配的参数组合。
不同采集场景的并发参考方案
不同目标网站的抗压能力差别很大,下面这张表是几类常见场景的经验参考值,实际执行时务必先小规模压测再放量:
| 采集场景 | 建议并发数 | 请求间隔 | IP轮换策略 |
|---|---|---|---|
| 电商价格监控 | 20~50 | 1~2秒 | 每次请求换IP |
| 搜索引擎采集 | 5~15 | 3~5秒 | 低频轮换+高匿名 |
| 企业信息采集 | 30~80 | 0.5~1秒 | 短效IP按任务分配 |
| 资讯聚合采集 | 15~40 | 1~3秒 | 定时自动轮换 |
两个规律值得记住:目标网站越“敏感”(比如搜索引擎类),并发要越保守、间隔要越长;而页面结构简单、反爬宽松的站点,可以放心用短效IP加高并发的组合,用完即换,效率最高。
并发调优五步法:从压测到稳定跑量
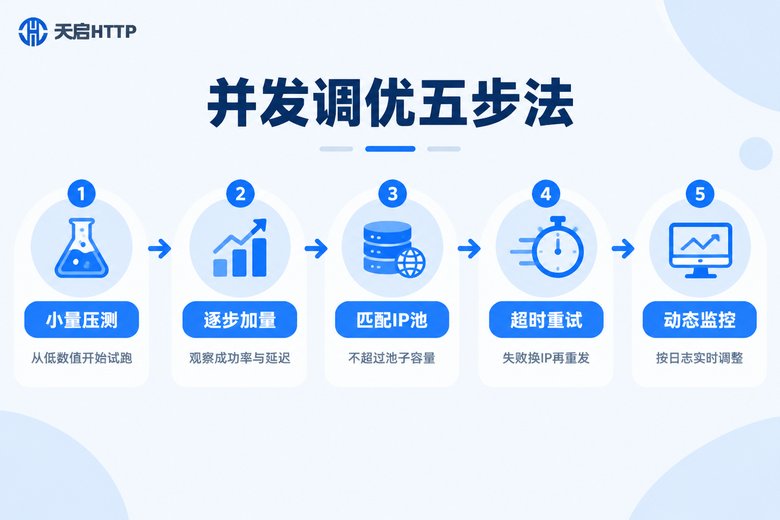
第一步,小并发起步。先用并发5~10跑一批样本任务,确认代理链路、解析逻辑都正常,别一上来就满负荷。
第二步,逐步加量。每次把并发提升50%左右,观察成功率和平均响应时间,哪个指标先恶化,临界点就在附近。
第三步,匹配IP池容量。并发数不能超过IP池的承载能力:短效IP要按存活时间估算“单IP最大请求量”,再反推并发上限,避免大量请求挤在少数几个IP上。
第四步,设好超时与重试。超时一般设5~15秒;失败后换一个IP重试,而不是用原IP死磕,重试2~3次即可,次数太多只会白白浪费时间。
第五步,持续监控动态调整。给任务加一个简单的统计:成功率低于90%自动降速,恢复后再逐步提回来,让程序自己找到舒服的节奏。
下面是一段Python示例,展示如何用信号量控制并发上限、失败自动换IP重试:
import asyncio
import random
import aiohttp

# 从代理服务商API提取可用IP列表
PROXY_POOL = get_proxies_from_api()

CONCURRENCY = 30   # 初始并发数,压测后逐步上调
TIMEOUT = 10       # 单请求超时(秒)
RETRY = 3          # 失败换IP重试次数

async def fetch(session, url, sem):
    async with sem:                     # 信号量控制并发上限
        for _ in range(RETRY):
            proxy = random.choice(PROXY_POOL)
            try:
                async with session.get(
                    url, proxy=proxy,
                    timeout=aiohttp.ClientTimeout(total=TIMEOUT)
                ) as resp:
                    if resp.status == 200:
                        return await resp.text()
            except Exception:
                await asyncio.sleep(1)  # 失败稍等,换IP重试
        return None

async def main(urls):
    sem = asyncio.Semaphore(CONCURRENCY)
    async with aiohttp.ClientSession() as session:
        results = await asyncio.gather(
            *(fetch(session, u, sem) for u in urls)
        )
    ok = sum(1 for r in results if r)
    print(f"成功率:{ok}/{len(urls)}")

asyncio.run(main(url_list))
并发过高时的四个典型症状与排查思路
症状一:成功率骤降。多半是并发超过了IP池承载能力,或触发了目标站的限流,先降并发、拉长间隔,再观察恢复情况。
症状二:超时堆积。请求越积越多、队列越排越长,检查本地带宽和线程开销,同时把超时收紧到10秒以内,快速释放无效连接。
症状三:IP失效特别快。说明单个IP的请求密度太高,加大轮换频率或扩充IP池,把压力摊薄到更多IP上。
症状四:数据重复或遗漏。重试和并发叠加容易造成重复采集,给任务加唯一键去重,失败任务单独入队补采。
让并发跑得更稳的实战细节
除了核心参数,这些细节往往决定任务能不能长时间稳定运行:
· 用信号量或连接池限流,而不是无限制开线程,避免把本机资源打满;
· 请求头多样化,User-Agent定期轮换,别让所有请求长得一模一样;
· 错峰采集,避开目标网站的业务高峰,凌晨时段通常更宽容;
· 动态调速,把并发做成可调参数,配合成功率监控自动升降;
· 日志留痕,记录每个请求使用的IP、耗时和状态码,排查问题全靠它。
IP资源是并发配置的底气:选对服务商事半功倍
参数调优是软件层面的功夫,真正决定并发上限的是IP资源本身。池子不够大、质量不稳定,并发一高就“无IP可用”。选择服务商时重点看三件事:IP池容量与更新频率、可用率与响应速度、协议与高并发场景的支持能力。
以天启HTTP为例,作为国内IP代理服务商,它采用自建机房纯净网络,IP池容量大且每日更新,可用率高达99%,响应速度毫秒级,全面支持HTTP、HTTPS、SOCKS5三种协议,节点覆盖全国200多个城市,能够稳定支撑数据采集的高并发场景。建议接入后先小批量压测,确认成功率达标后,再放量跑正式任务。
常见问题
Q: 并发数是不是越高越好?
不是。并发超过IP池承载能力或目标网站的容忍阈值后,成功率会断崖式下跌,IP消耗也会成倍增加。实际效率等于并发乘以成功率,成功率掉了,并发再高也白搭。
Q: 有没有万能的并发数值?
没有。不同目标网站的抗压能力差别很大,稳妥的做法是从低并发压测起步,按“每次提升50%、观察成功率”的方式,逐步找到临界点。
Q: 并发一高就大量超时,问题出在哪?
常见原因有三个:一是IP池太小或IP质量差,请求挤在少数几个IP上;二是超时设置过短,高并发下响应变慢被误判为失败;三是本地带宽或线程瓶颈。建议先检查IP可用率,再把超时调到10~15秒,最后排查本地资源占用。
Q: 并发和IP轮换怎么配合?
原则是“IP在存活期内别被薅太狠”。短效IP存活时间短,就要按存活时间估算单IP最大请求量,再反推并发上限;IP池越大,可承受的并发越高。像天启HTTP这种IP池每日更新、可用率高的服务商,配合合理的轮换策略,高并发采集会稳很多。
Q: 被目标网站封禁后该怎么办?
立即暂停任务,降低并发并拉长请求间隔,更换一批新IP后从小并发恢复,同时检查请求头和访问轨迹是否过于规律,必要时给任务加上随机化处理。