被封的不是脚本,是你的"请求特征"
很多人写采集脚本的体验是这样的:刚上线一切正常,跑了几分钟开始返回403、429,或者干脆拿到一堆验证码页面。重启、换账号、换台电脑,都只能顶一阵子。其实目标网站封的从来不是你的代码,而是你的请求特征——当同一个出口IP、同一套默认请求头、同一种机械节奏反复出现时,风控系统一眼就能认出"这不是正常用户"。
想稳定抓取API接口数据,核心就两件事:代理轮换让每个请求换个出口IP,请求头伪装让每个请求看起来像真浏览器发出的。下面从原理到代码一次讲清楚。
先搞清楚:API接口凭什么封你?
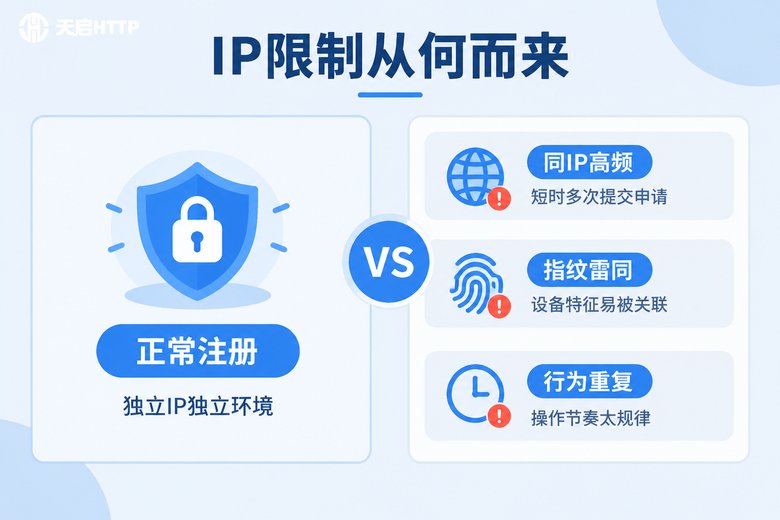
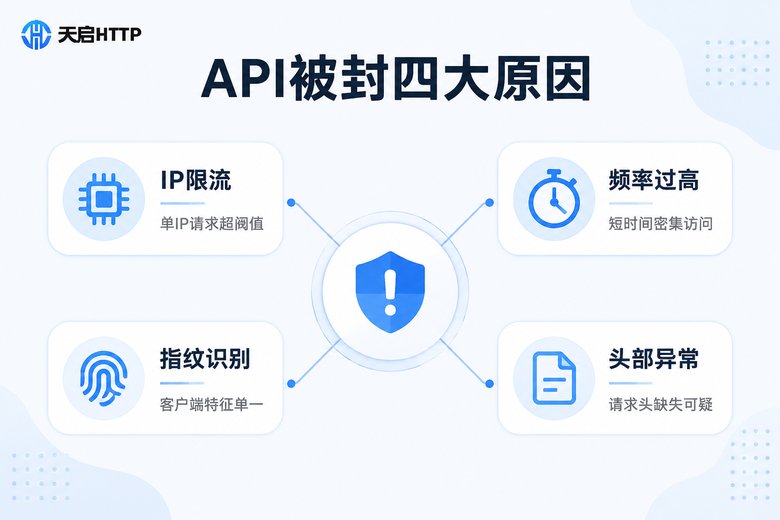
服务端风控的本质,是给每个请求"打分",分数低了就限流或拉黑。最常见的四类判定依据:
1. IP频率限制:最基础的一道闸。同一个IP每分钟打几十上百次请求,远超正常用户的操作强度,直接触发限流,累计多次就进黑名单。
2. 请求头特征异常:用requests默认配置发请求,User-Agent是"python-requests/2.x",等于自报家门"我是脚本";再缺个Referer、缺个Accept-Language,每一项都会被风控记一笔。
3. 行为模式太机械:请求间隔精确到毫秒、只访问API从不访问页面、24小时匀速运行——这些和真人使用习惯的差异,都是明显的爬虫信号。
4. 签名与凭证校验:部分接口还会校验token、时间戳签名等加密参数,这类属于进阶对抗,需要单独逆向分析。
代理轮换:让每个请求都"换张脸"
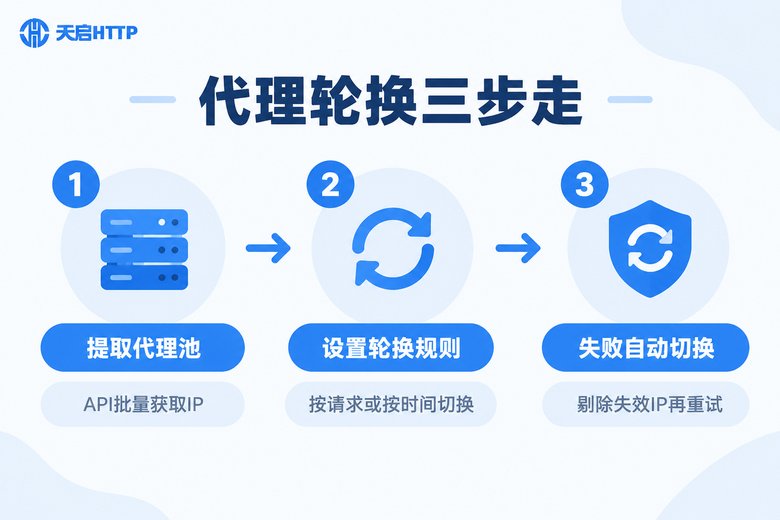
既然封禁大多针对IP,最直接的解法就是不让任何一个IP的请求量触到阈值。准备一个代理IP池,按规则轮换使用,风控看到的就是成百上千个"普通用户",而不是一个疯狂的脚本。
常用的三种轮换策略:
| 轮换策略 | 切换方式 | 适用场景 |
|---|---|---|
| 每请求轮换 | 每次请求都换一个IP | 大批量、无状态的接口 |
| 定时轮换 | 每隔N秒/分钟换一次IP | 需要维持登录态或会话的接口 |
| 失败切换 | 请求失败才换IP重试 | 风控较松、追求稳定的场景 |
最小可用的轮换逻辑,几行就能实现:
import requests
import random

# 代理池:通过服务商的API提取链接批量获取
proxy_pool = [
    "http://183.x.x.1:8080",
    "http://183.x.x.2:8080",
    "http://183.x.x.3:8080",
]

for page in range(1, 101):
    proxy = random.choice(proxy_pool)  # 每次请求随机取一个IP
    resp = requests.get(
        "https://目标站点/api/list?page=%d" % page,
        proxies={"http": proxy, "https": proxy},
        timeout=10,
    )
print(resp.status_code)要注意的是,轮换的效果上限取决于代理池的质量。如果池子里全是被用烂、早已被目标站拉黑的IP,换得再勤也没用。所以尽量选择支持24小时去重、高可用率的服务商,比如天启HTTP,通过API提取的IP都是经过验证的可用资源。
请求头伪装:别让User-Agent出卖你
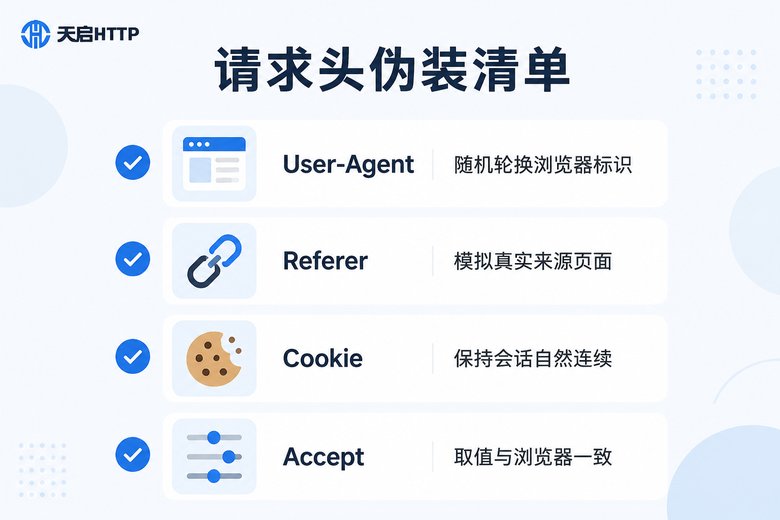
解决了IP问题,第二步是把请求"包装"得像浏览器。服务器判断访问者身份,请求头是最直观的依据:
User-Agent:绝对不要用默认值。准备一个真实浏览器UA池,每次请求随机取一个,Windows、Mac、不同浏览器版本混着来。
Referer:正常用户都是从页面里触发API请求的,带上来源页地址,风控一看来源合理,分数自然高。
Accept 与 Accept-Language:照着浏览器开发者工具里看到的值抄,保持一致,别自己发明。
Cookie:有些接口校验会话,可以先请求一次页面拿到Cookie,再带着Cookie去调API,模拟完整的访问链路。
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                  "AppleWebKit/537.36 (KHTML, like Gecko) "
                  "Chrome/124.0.0.0 Safari/537.36",
    "Referer": "https://www.target-site.com/list",
    "Accept": "application/json, text/plain, */*",
    "Accept-Language": "zh-CN,zh;q=0.9",
    "Connection": "keep-alive",
}一个实用技巧:打开浏览器F12的网络面板,找到目标API那条请求,把它的请求头原样抄下来做模板,比凭感觉拼装靠谱得多。
组合实战:轮换+伪装完整示例
把两招合在一起,再补上随机间隔和失败重试,就是一个能长时间稳定跑的采集骨架:
import requests
import random
import time

EXTRACT_URL = "你的天启HTTP提取链接"  # 后台复制API提取链接

def refresh_proxies():
    """重新拉取一批可用IP"""
    data = requests.get(EXTRACT_URL, timeout=10).json()
    # 字段名按实际返回结构调整
    return ["http://%s:%s" % (i["ip"], i["port"]) for i in data["data"]]

PROXIES = refresh_proxies()

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 "
    "(KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/605.1.15 "
    "(KHTML, like Gecko) Version/17.4 Safari/605.1.15",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:125.0) Gecko/20100101 Firefox/125.0",
]

def fetch_api(api_url, referer):
    global PROXIES
    for _ in range(3):                          # 最多重试3次
        proxy = random.choice(PROXIES)          # 每次请求随机换IP
        headers = {
            "User-Agent": random.choice(USER_AGENTS),
            "Referer": referer,
            "Accept": "application/json, text/plain, */*",
            "Accept-Language": "zh-CN,zh;q=0.9",
            "Connection": "keep-alive",
        }
        try:
            resp = requests.get(api_url, headers=headers,
                                proxies={"http": proxy, "https": proxy},
                                timeout=10)
            resp.raise_for_status()
            time.sleep(random.uniform(1, 3))    # 随机间隔,别太规律
            return resp.json()
        except Exception:
            PROXIES.remove(proxy)               # 剔除失效IP
            if not PROXIES:
                PROXIES = refresh_proxies()     # 池子空了重新提取
    return None
优化前后的差别非常直观:
| 对比项 | 默认直连请求 | 代理轮换+请求头伪装 |
|---|---|---|
| 出口IP | 单一固定IP | 池内随机轮换 |
| User-Agent | python-requests默认值 | 真实浏览器UA随机切换 |
| Referer | 缺失 | 模拟真实来源页 |
| 请求节奏 | 固定间隔 | 随机间隔 |
| 稳定性 | 跑几分钟就被封 | 可长时间持续采集 |
代理池质量决定上限:选对服务商少走弯路
代码骨架搭好之后,真正拉开差距的是代理IP本身的质量。挑选服务商时重点看几点:IP是否每天去重更新、可用率是否够高、提取是否方便、带宽是否充足。
以天启HTTP为例,它是专注国内业务的IP代理服务商,支持HTTP、HTTPS、SOCKS5三种协议,自建机房大带宽,IP可用率99%以上,每日24小时去重保证池子新鲜,覆盖全国多城市节点,通过API提取链接即可批量接入上面示例中的代理池。像电商比价、内容聚合、价格监控这类国内数据采集场景都能直接套用。
最后提醒一句:代理轮换和请求头伪装解决的是"被识别"的问题,控制好并发和频率、尊重目标站点的robots规则,采集才能做得长久。
常见问题
Q:已经用了代理IP,为什么还是被封?
大概率是另外两项没做好:请求头还是默认值,或者请求频率太高。IP、请求头、频率三条线要同时达标,只换IP是不够的;另外也要确认代理本身没被目标站拉黑,低质量IP换了等于白换。
Q:代理IP多久换一次比较合适?
没有统一答案,目标站风控越严,轮换越频繁。建议从"每个请求换一次"开始测试;如果接口需要登录态,就改用定时轮换,让同一个IP跑完整个会话再切换。
Q:免费代理能用来抓API吗?
练手可以,跑业务不建议。免费代理可用率低、速度慢,而且被大量人用过,很多早已被目标站拉黑。正式项目选天启HTTP这类支持API批量提取、24小时去重的服务商,能省去大量筛选成本。
Q:请求头是不是加得越多越好?
不是。关键是"像真的"而不是"堆得多"。带上User-Agent、Referer、Accept、Accept-Language这些常用头,取值和真实浏览器保持一致即可;多出一些奇怪的头部反而容易成为新的特征点。
Q:天启HTTP支持哪些协议和场景?
支持HTTP、HTTPS、SOCKS5三种协议,覆盖常见采集框架和工具的接入需求,适合电商、资讯、价格监控等国内业务的数据采集场景,通过API提取链接即可批量获取代理IP。