做爬虫采集的朋友大多遇到过这种场景:程序跑着跑着突然满屏报错,一查才发现是IP被目标网站封了。这时候很多人的第一反应是——去网上找免费代理IP来用。那么问题来了:代理IP从哪里抓?用什么工具抓?辛辛苦苦抓下来一堆IP,又怎么知道哪些能用?这篇文章就把"抓代理IP"这条完整链路讲清楚:代理源、抓取工具、验证方法,一个都不漏。
一、代理IP的常见来源有哪些?
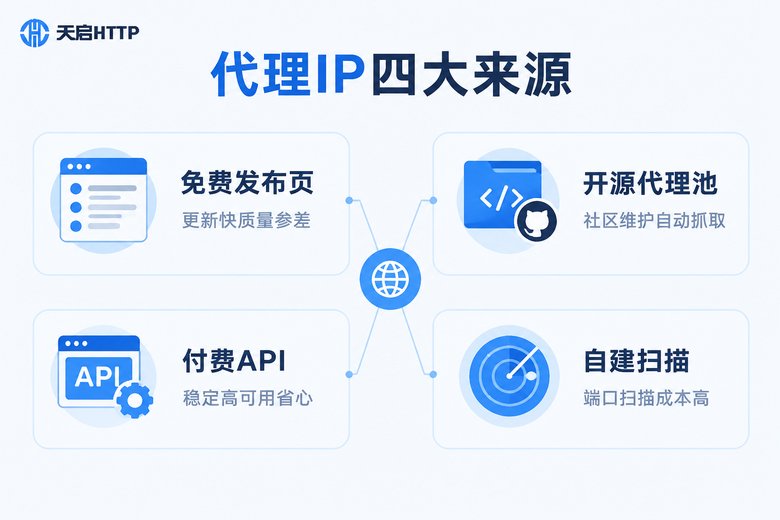
想抓代理IP,先得知道去哪里抓。目前主流的代理源主要有四类:
1. 免费代理发布页:一些网站会定时公布免费代理IP列表,通常以表格形式展示IP、端口、协议和匿名等级。这类来源更新快、零成本,但质量参差不齐,可用率往往只有一两成。
2. 开源代理池项目:在 GitHub 等代码托管平台上,有不少维护活跃的开源代理池项目,内置了多个免费代理源,自动完成"抓取—验证—入库—对外提供IP"的闭环,部署后可以直接调用,是个人开发者入门的常见选择。
3. 技术社区分享:一些技术论坛、交流群、贴吧里,会有人不定期分享自己验证过的代理IP。数量不多,但经过人工筛选,短期可用性相对好一些。
4. 付费服务商的API提取接口:像天启HTTP这样的国内代理IP服务商,会提供API提取链接,按需拉取已经验证过的可用IP。这是效率最高的方式,抓取和验证环节都由服务商完成,业务侧接入就能直接用。
二、抓代理IP的常用工具有哪些?
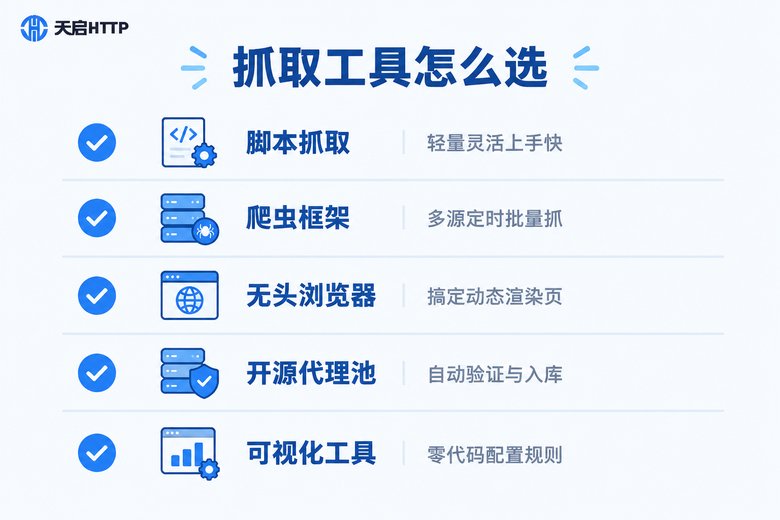
确定了来源,接下来就是"怎么抓"。按照技术水平和使用场景,常用工具可以分成六类:
1. Python + requests / httpx:最基础的方案。代理发布页本质就是一个网页,用 requests 请求页面内容,几行代码就能把列表页扒下来。
2. 解析库 BeautifulSoup / lxml / parsel:负责把抓到的 HTML 解析成结构化数据。lxml 速度快,BeautifulSoup 上手简单,和 requests 搭配是最经典的组合。
3. Scrapy 等爬虫框架:如果需要同时监控多个代理源、定时抓取、自动去重,用框架更省心。Scrapy 自带调度器和管道,适合把"抓代理"做成一个长期运行的定时任务。
4. Selenium / Playwright 等无头浏览器:有些代理发布页的内容由 JavaScript 动态渲染,普通请求拿不到完整列表,这时就需要无头浏览器模拟真实浏览器行为。
5. 开源代理池:严格来说它不是单纯的抓取工具,而是把抓取、验证、存储、API服务打包在一起的整套方案,不想自己写调度逻辑的话,部署一个代理池性价比很高。
6. 可视化采集工具:完全不会写代码的用户,可以用低代码采集工具,通过点选页面元素配置规则,直接导出表格或JSON格式的代理列表。
下面是一个最简抓取示例,用 requests 加 BeautifulSoup 把发布页表格里的IP和端口提取出来:
import requests
from bs4 import BeautifulSoup

headers = {"User-Agent": "Mozilla/5.0"}

# URL替换为实际的代理列表页地址
resp = requests.get("https://example.com/proxy-list",
                    headers=headers, timeout=10)
soup = BeautifulSoup(resp.text, "lxml")

# 提取表格每一行的IP和端口
proxy_list = []
for tr in soup.select("table tr")[1:]:
    tds = tr.find_all("td")
    if len(tds) >= 2:
        ip = tds[0].get_text(strip=True)
        port = tds[1].get_text(strip=True)
        proxy_list.append(f"{ip}:{port}")

print(f"共抓取到 {len(proxy_list)} 个候选代理IP")
三、抓下来的代理IP怎么验证?
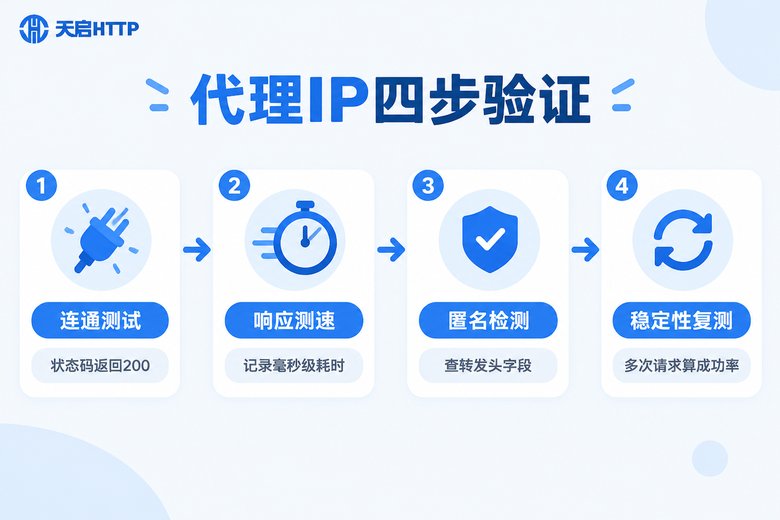
不管是免费发布页还是社区分享,抓到的IP都只是"候选",直接拿来用大概率会翻车。验证环节才是决定代理池质量的关键,一般分四步走:
第一步:连通性测试。用待验证的代理去请求一个稳定的目标地址,能在超时时间内返回状态码200,才算"活着"。
第二步:响应测速。记录每次请求的毫秒级耗时,把超过阈值(比如3秒)的慢代理直接淘汰,慢代理在采集里几乎没有使用价值。
第三步:匿名度检测。通过目标地址回显的请求头,检查是否携带 X-Forwarded-For、Via 等字段,判断代理属于透明、普通匿名还是高匿。
第四步:稳定性复测。间隔一段时间对同一个代理多次请求,统计成功率,只有反复验证都稳定的IP才值得留在池子里。
| 匿名等级 | 判断依据 | 是否暴露真实IP | 适用场景 |
|---|---|---|---|
| 透明代理 | 携带 X-Forwarded-For | 完全暴露 | 对匿名无要求的采集 |
| 普通匿名 | 隐藏真实IP,但暴露用了代理 | 不暴露 | 一般强度的数据抓取 |
| 高匿代理 | 两个头字段都不出现 | 完全不暴露 | 反爬严格的网站 |
下面是一个并发验证脚本,同时检测可用性、响应速度和匿名度:
import requests
import time
from concurrent.futures import ThreadPoolExecutor

def check_proxy(proxy):
    """验证单个代理:可用性、耗时、匿名度"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    try:
        start = time.time()
        resp = requests.get("https://httpbin.org/get",
                            proxies=proxies, timeout=5)
        cost = int((time.time() - start) * 1000)
        if resp.status_code != 200:
            return None
        headers = resp.json().get("headers", {})
        # 同时没有 X-Forwarded-For 和 Via,视为高匿
        is_anonymous = ("X-Forwarded-For" not in headers
                        and "Via" not in headers)
        return {"proxy": proxy, "耗时ms": cost, "高匿": is_anonymous}
    except Exception:
        return None

if __name__ == "__main__":
    candidates = ["123.45.67.89:8080", "98.76.54.32:3128"]  # 抓到的候选IP
    with ThreadPoolExecutor(max_workers=20) as pool:
        results = [r for r in pool.map(check_proxy, candidates) if r]
    # 按响应速度从快到慢输出
    for item in sorted(results, key=lambda x: x["耗时ms"]):
        print(item)
三个实用建议:验证一定要并发执行,串行验证几百个IP会浪费大量时间;超时时间别设太长,5秒足够;验证结果要落库并带上时间戳,方便后续定时剔除失效IP。
四、免费代理够用吗?什么时候该换付费方案?
自己抓免费代理,最大的短板是投入产出比。抓100个免费IP,验证后往往只剩一二十个能用,而且存活时间从几分钟到几小时不等,必须不停地抓、不停地验。此外,公共免费代理还有安全隐患:代理服务器完全能看到你的请求内容,遇到来路不明的代理,采集数据可能被篡改或记录。
这些场景,自己抓免费代理就够了:学习爬虫技术、练手验证流程;小规模、低频率的采集任务;对成功率和稳定性没有硬性要求的临时需求。
这些场景,建议直接上付费代理:业务量大、需要长时间稳定运行;目标网站反爬严格,必须用高匿IP;需要并发采集,对IP数量和响应速度有要求;不想在抓取和验证上耗费维护精力。
如果决定用付费方案,推荐了解天启HTTP。它是国内的代理IP服务商,支持HTTP、HTTPS、SOCKS5等常用协议,提供API批量提取,提取到的IP经过平台验证,高匿名、响应快,覆盖国内多城市节点。爬虫采集业务接入后,"抓IP、验IP、剔失效"这些环节都不用再操心。打个比方:自己抓免费代理像"从沙子里淘金",用天启HTTP这类服务商则是"直接拿到筛好的金子",把精力留给业务本身。
常见问题
Q: 免费代理IP抓下来一般能用多久?
存活时间从几分钟到几小时不等,可用率通常只有10%~30%。所以抓取后必须立即验证,并且要定时重新抓取、剔除失效IP,代理池才是"活"的。
Q: 验证代理时用什么目标地址比较好?
选一个稳定且返回内容里带IP信息的接口,比如 httpbin.org/ip;也可以直接请求你的目标网站,看能否正常返回状态码200,后者更贴近真实业务场景。
Q: 怎么判断一个代理是不是高匿?
看请求经过代理后,目标服务器收到的请求头:如果出现 X-Forwarded-For 或 Via 字段,说明代理暴露了自身或你的真实IP;两个字段都没有,才算高匿。
Q: 代理池多久验证一轮比较合理?
免费源建议5~10分钟跑一轮验证,及时淘汰失效IP;如果用天启HTTP这类服务商的API提取,IP在平台侧已经过验证,按业务频率定时拉取新IP即可。
Q: 自建代理池和直接买代理服务,怎么选?
以学习为目的,自建代理池能完整走一遍抓取、验证、调度的流程,收获很大;生产业务则建议直接接入天启HTTP的API提取,省掉抓取验证的维护成本,稳定性和效率都更有保障。