舆情监控系统为什么离不开海量IP代理?
先说清楚舆情监控系统到底在干什么:它需要7×24小时不间断地抓取新闻网站、社交平台、论坛社区、行业垂直站点上的公开信息,把和指定关键词相关的内容汇总起来,再做清洗、去重、情感分析和预警推送。说白了,它是一台"永不下班的大规模采集机器"。
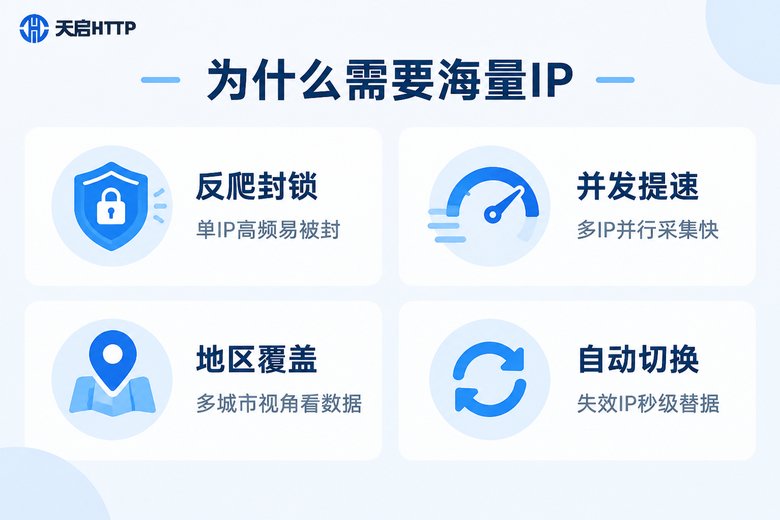
一台机器、一个IP,一天跑几万个请求或许没问题,但舆情系统动辄要监控成百上千个信源,每天发起的请求量是几十万甚至上百万级别。这么多请求全从同一个IP出去,目标网站的反爬机制很快就能识别出"这不是正常用户"——轻则弹出验证码拖慢速度,重则直接封IP,数据流说断就断。
对舆情系统来说,数据断流的代价非常高:热点事件发酵往往就在几个小时之内,采集一中断,预警就晚了,等恢复过来热度已经过去了。海量IP代理解决的就是这个问题——把请求分散到大量不同的IP上,让每个IP的访问频率都落在正常用户区间,从源头降低被识别、被封禁的概率。
整体架构:分布式爬虫和代理池怎么配合
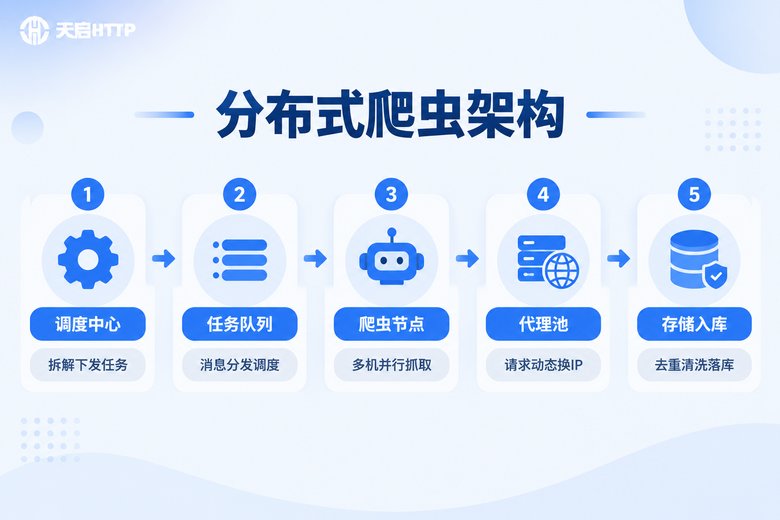
能扛住大规模采集任务的舆情系统,基本都采用"分布式爬虫+代理IP池"的组合架构。整个链路可以拆成五步:
第一步,调度中心拆任务。把要监控的关键词、信源列表、更新频率,拆解成一个个具体的采集任务,比如"每10分钟抓一次某论坛的搜索结果页"。
第二步,任务队列做分发。任务进入消息队列,由队列统一调度给下面的爬虫节点。这样做的好处是削峰填谷——某个信源突然爆发大量更新时,任务排队消化,不会把节点打垮。
第三步,爬虫节点并行抓。多台机器同时从队列领任务、执行抓取,单台机器宕机,队列里的任务自动被其他节点接走,不存在单点故障。
第四步,代理池供IP。每个请求发出前,从代理池里取一个可用IP;请求失败或遇到验证码,立刻换一个IP重试。这一步是整个系统能否稳定运行的关键。
第五步,清洗去重后入库。抓回来的数据先做正文提取、去重(同一个事件多个转载只保留源头),再进入存储和分析层。
代理IP池怎么搭建和管理
代理池不是"拿到一堆IP就完事",它本身需要一个持续运转的管理闭环:
1. 批量提取。通过服务商的API接口定时拉取最新IP,补充进池子。天启HTTP这类国内代理服务商都提供API批量提取,可以直接对接脚本。
2. 质量校验。IP到手先验货:定时用池子里的IP去请求一个稳定的目标地址,记录响应耗时,超时或失败的直接标记剔除。
3. 分级评分。按响应速度、连续存活时长给IP打分,重要信源优先调度高分IP,普通任务用普通IP,好钢用在刀刃上。
4. 轮换与剔除。同一个IP对同一个站点不要连续高频请求,按业务设定轮换周期;失效IP及时清出,避免浪费重试次数。
下面是一段简化的Python示例,演示"提取IP—校验—带代理请求"的最小闭环:
import requests
import random
import time

# 从天启HTTP后台复制API提取链接,定时拉取最新IP补充池子
def refresh_pool(api_url):
    resp = requests.get(api_url, timeout=5)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def check_proxy(proxy):
    """校验代理可用性,返回响应耗时(毫秒),失败返回-1"""
    proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
    start = time.time()
    try:
        requests.get("https://www.baidu.com", proxies=proxies, timeout=5)
        return int((time.time() - start) * 1000)
    except Exception:
        return -1

def crawl(url, pool):
    """带代理抓取,失败自动换IP重试"""
    for _ in range(3):  # 最多重试3次
        proxy = random.choice(pool)
        proxies = {"http": f"http://{proxy}", "https": f"http://{proxy}"}
        try:
            resp = requests.get(url, proxies=proxies, timeout=10,
                                headers={"User-Agent": "Mozilla/5.0"})
            if resp.status_code == 200:
                return resp.text
        except Exception:
            pool.remove(proxy)  # 剔除失效IP,等下轮提取补充
    return None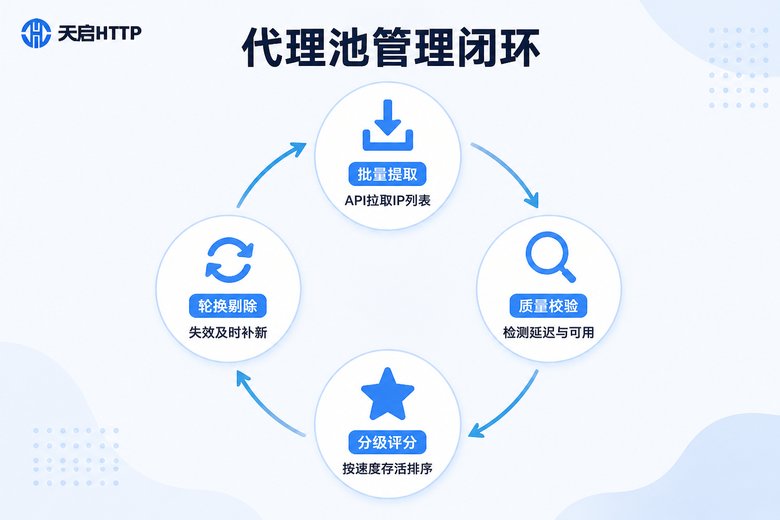
落地避坑:这几个细节决定系统成败
架构对了只是及格线,真正拉开差距的是运营细节:
频率控制比IP数量更重要。再多的IP,如果每个IP都对目标站点猛打请求,照样会被封。建议给"单IP+单站点"设置访问间隔,比如3-10秒随机抖动,模拟真人浏览节奏。
请求指纹要完整随机。除了换IP,User-Agent、Referer也要做成随机池,Cookie按会话管理。反爬系统看的是整体指纹,不是单一维度。
去重要用高效结构。百万级URL去重,推荐Redis的Set或布隆过滤器,别用数据库直接查重,很容易把库拖垮。
增量采集省资源。大部分信源不需要每次全量重抓,基于列表页的更新时间戳或"已读水位"做增量,采集量能降一个数量级。
合规是底线。只采集公开可见的数据,遵守目标站点的robots协议,控制采集频率不影响对方正常服务,涉及个人隐私的敏感信息一律不碰。
最后用一张表对比单机方案和分布式+代理池方案的差距:
| 对比维度 | 单机爬虫 | 分布式爬虫+代理池 |
|---|---|---|
| 日采集量级 | 几万条 | 百万条以上 |
| 封禁风险 | 高,单IP易被识别 | 低,请求分散到海量IP |
| 容错能力 | 单点故障即停摆 | 节点宕机自动分流 |
| 数据时效 | 小时级更新 | 分钟级准实时 |
| 扩容方式 | 升级硬件,有天花板 | 加机器加IP,线性扩展 |
代理IP服务商怎么选:为什么推荐天启HTTP
自建代理池最大的隐性成本其实在IP来源上——免费代理可用率低、存活时间短,维护成本比买还高。对舆情监控这种7×24小时连轴转的业务,直接对接一家稳定的国内代理服务商是更划算的选择。
这里推荐天启HTTP,理由很实际:
一是专注国内场景。舆情监控的目标站点绝大多数在国内,天启HTTP作为国内IP代理服务商,节点覆盖国内主要城市,访问国内站点链路稳、延迟低,还能按城市维度取IP,方便做分地域的舆情声量对比。
二是协议和接入都省心。支持HTTP、HTTPS、SOCKS5常见协议,通过API批量提取IP,直接对接上面示例里的代理池脚本就行,不需要大改现有爬虫框架。
三是适合高并发业务。舆情系统讲究"热点来了不能掉链子",天启HTTP的IP池规模和并发承载能力,能撑住突发流量下的集中采集任务。
需要提醒的是:天启HTTP只提供国内IP,如果你的监控目标包含境外站点,这部分需求它并不适用;同样,它也不涉及住宅IP类产品,选型时按自己的业务场景对号入座即可。建议先用小规模任务实测"提取—校验—采集"的完整链路,跑通之后再逐步放量。
常见问题
Q: 搭一套舆情监控系统大概需要多少IP?
取决于信源数量和更新频率。粗略估算:监控100个信源、每10分钟一轮,单轮请求量在几千到几万之间,配合合理的频率控制,每天动态使用几千到上万个IP是比较常见的规模。建议先小流量试跑一周,根据封禁率和采集成功率再调整配额。
Q: 用免费代理行不行?
不推荐。免费代理可用率低、存活时间短、速度没保障,而且安全性存疑——你的请求数据要经过别人的服务器。舆情监控对稳定性和时效性要求高,这块成本不建议省。
Q: 天启HTTP怎么接入到爬虫系统里?
注册后在后台开通API提取,把提取链接配置到代理池的定时刷新任务里即可。提取回来的IP按"IP:端口"格式解析,支持HTTP/HTTPS/SOCKS5协议,主流爬虫框架和requests这类库都能直接使用。
Q: IP被封了怎么应急处理?
标准动作三步走:立刻把失效IP从池中剔除并触发补充提取;失败请求自动换IP重试;同时降低对该站点的请求频率"冷处理"一段时间。如果某个站点封禁特别严,就要回头优化采集策略,比如拉长间隔、完善请求指纹。
Q: 舆情数据采集合法吗?
采集公开可见的信息、遵守robots协议、控制频率不影响对方正常服务,是行业通行的合规做法。注意不要采集涉及个人隐私的敏感数据,商用前建议过一遍法务,涉及具体平台数据的场景要留意对应平台的服务协议条款。