为什么代理IP池必须"自动清洗"无效节点
很多人以为,把成百上千个代理IP丢进一个"池子"里就万事大吉了。实际上,IP池是一个动态变化的东西:今天还能用的节点,明天可能就因为各种原因变成"脏节点"——有的被目标网站限制了访问频率,有的端口失效彻底连不上,有的因为承载的请求太多变得极慢。如果不做清理,池子会越来越"脏",业务请求的成功率也会一路下滑。
所谓自动清洗无效节点,就是让IP池自己定期"体检":把连不上、响应慢、成功率低的节点识别出来,降权、隔离甚至剔除,同时补充新节点进来,保证池子里随时都是能干活的好节点。而支撑这一切的,就是健康检测机制。下面我们就把它拆开揉碎讲清楚。
健康检测到底在检测什么:四大核心指标
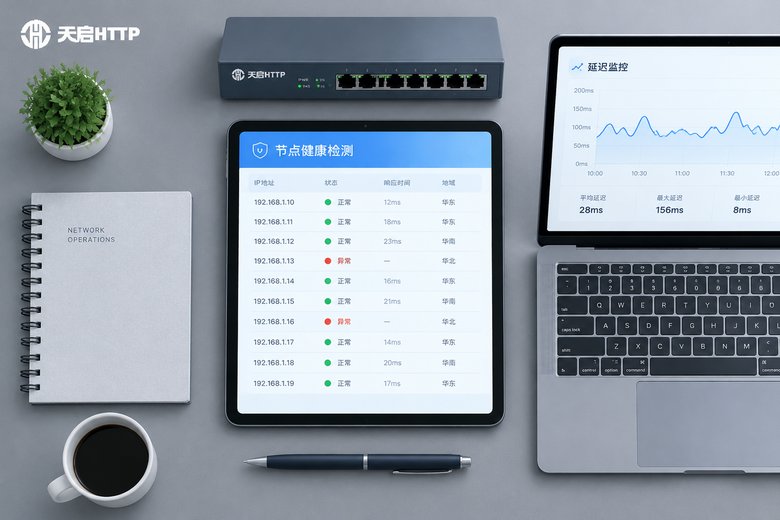
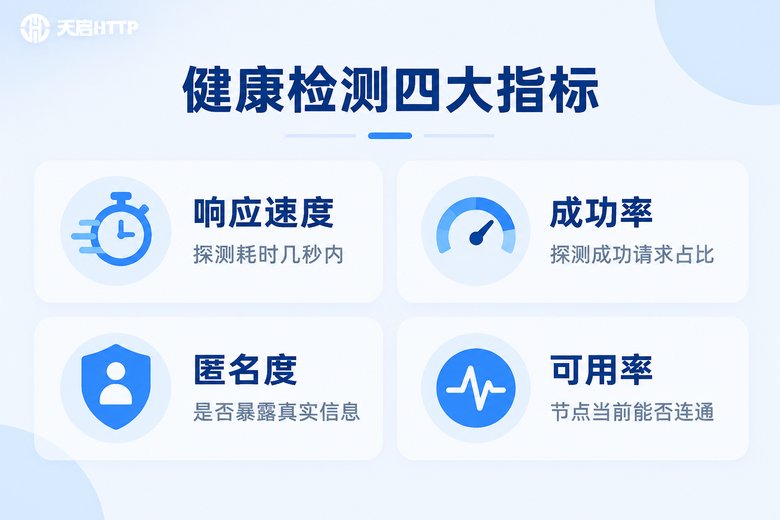
健康检测并不是简单地"ping一下通不通",一个成熟的检测机制会同时关注多个维度:
1. 响应速度:从通过节点发出请求到收到响应的耗时。延迟越低,业务体验越好,一般超过3~5秒还没响应,就会被标记为"慢节点"。
2. 请求成功率:在一段统计周期内,通过该节点发出的探测请求有多少比例正常返回。成功率持续偏低,说明节点已经不稳定。
3. 存活可用率:节点当前能否正常建立连接、完成一次完整请求,这是最基础的"生死线"。
4. 匿名表现:请求经过代理后,会不会把真实信息暴露给目标网站。匿名度不达标的节点,即使能连通也要降级处理。
把这几个指标汇总起来,就得到一张常见的判定参考表:
| 检测指标 | 它反映什么 | 常见的处理方式 |
|---|---|---|
| 响应速度 | 节点快不快 | 超时或过慢则降权 |
| 请求成功率 | 节点稳不稳 | 低于阈值进入观察期 |
| 存活可用率 | 节点还能不能用 | 连接失败计一次失败 |
| 匿名度 | 会不会暴露真实信息 | 不达标降级或剔除 |
一轮完整的健康检测是怎么跑起来的
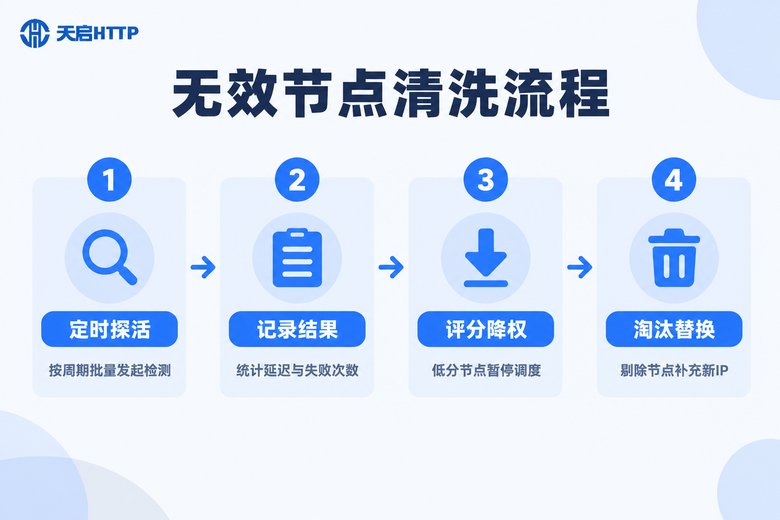
健康检测本质上是一个定时批量执行的探测任务,整个流程可以拆成四步:
第一步,确定探测目标。检测程序会选一个或多个"探测地址",可以是公共的回显服务,也可以直接用业务实际要访问的目标站点——用真实目标站检测,结果更贴近实战。
第二步,按周期发起探测。检测器每隔一段时间(比如30秒、1分钟或5分钟,视业务要求而定)遍历池内节点,通过每个节点并发发出探测请求,并记录返回结果。
第三步,记录并打分。每一次探测的耗时、是否成功、返回状态都会被记录下来,累加成每个节点的"健康档案":连续成功加分,失败或超时扣分。
第四步,按分数调度。分数高的节点优先分配给业务请求,分数低的节点减少调度甚至暂停使用,避免任务撞上坏节点。
用一段简化的示例代码来看,逻辑其实非常直观:
import time

def check_node(proxy_ip):
    """通过单个节点发起探测请求,返回是否可用及耗时"""
    start = time.time()
    try:
        resp = request_via(proxy_ip, target=CHECK_URL, timeout=3)
        return {"ip": proxy_ip, "alive": True, "latency": time.time() - start}
    except Exception:
        return {"ip": proxy_ip, "alive": False, "latency": None}

def clean_pool(pool, max_latency=3.0, fail_limit=3):
    for node in pool.all():
        result = check_node(node.ip)
        if not result["alive"]:
            node.fail_count += 1
            if node.fail_count >= fail_limit:
                pool.remove(node)        # 连续失败达标,淘汰出池
        elif result["latency"] > max_latency:
            node.score -= 10             # 响应过慢,评分降权
        else:
            node.fail_count = 0
            node.score = 100             # 检测通过,恢复正常权重
无效节点如何被自动清洗:从降权到淘汰
检测只是采集数据,真正的"清洗"发生在判定之后。一套完整的清洗机制通常包含四个动作:
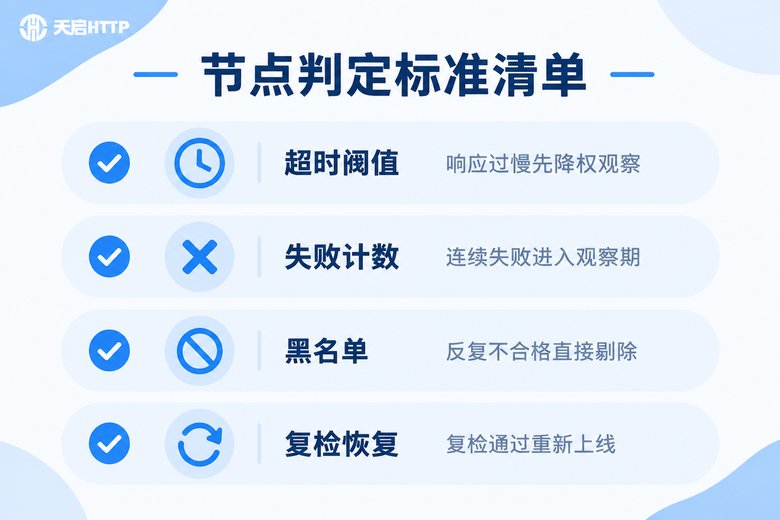
① 评分降权:节点偶尔超时一次,不会立刻被扔掉,而是先扣分降权。调度器会减少分给它的请求量,让它"边观察边工作"。
② 暂停调度:当失败次数或低分状态持续一段时间,节点会被移出调度队列,进入"隔离区",不再承接业务请求,但仍然接受检测。
③ 淘汰出池:连续多轮检测都不合格,或者触发黑名单规则的节点,会被彻底从池子里剔除,腾出位置。
④ 补充新节点:池子设有容量水位线,剔除多少就按需补充多少新节点,保证池内可用数量始终稳定,业务侧几乎无感知。
黑名单与复检:给节点"改过自新"的机会
节点失效的原因有很多是临时性的:目标网站短时间风控、运营商瞬时抖动、机房网络波动。如果一失败就永久拉黑,池子会被"误杀"得很快。因此成熟的IP池都会设计缓冲机制:
黑名单机制:短期内反复不合格的节点进入黑名单,暂停参与调度,防止它继续拖累任务成功率。
复检恢复:黑名单里的节点并不会被遗忘,系统会按较低频率继续探测,一旦连续若干次检测通过,就恢复它的调度权重,重新回到正常池中。
分级管理:不少IP池还会把节点分成不同层级,比如"高速通道""普通池""观察池",检测表现决定节点处在哪个层级,业务可以按需选用。
检测频率怎么定?几个实用经验
检测周期并不是越密越好,需要在准确性和资源消耗之间找平衡:
· 高实时性业务(如秒杀、抢购场景):建议30秒~1分钟一轮检测,宁可多花探测成本,也要保证节点状态新鲜。
· 一般采集、批量任务类业务:3~5分钟一轮足够,配合请求失败实时反馈,也能及时发现问题节点。
· 低频业务:可以拉长到10分钟以上,但建议在业务请求失败时触发"即时复检",用实际结果修正节点状态。
另外要记住一点:业务侧的真实失败反馈,是比定时探测更宝贵的检测信号。把"定时探活"和"请求失败即时降权"结合起来,池子的健康度才是实时的。
不想自己维护检测体系?选对服务商更省心
看到这里你会发现,自建IP池要自己写探测调度、维护黑名单、补充节点,开发和运维成本都不低。对大多数团队来说,更划算的做法是直接使用自带健康检测机制的服务商——节点在进入池子之前和之后都有筛选与清洗,你拿到的API返回结果本身就是经过可用性验证的。
以天启HTTP为例,它是专注国内业务的IP代理服务商,IP资源池规模大、节点覆盖国内多城市多运营商,提供API提取方式和多种协议类型支持,池内节点经过可用性筛选与动态维护,适合爬虫采集、数据抓取、批量任务等对成功率敏感的业务场景。如果你的目标网站在国内,选择国内服务商在延迟和稳定性上天然更有优势,接入也简单,注册后获取API链接即可直接调用,省去了自建检测体系的大量维护工作。
常见问题
Q: 健康检测会不会消耗很多请求次数?
会有一定消耗,因为探测本身就是真实请求。正规服务商的检测消耗由平台侧承担,不会额外转嫁给用户;如果是自建池,建议控制检测频率,并优先使用轻量的探测地址,降低成本。
Q: 节点被清洗掉之后,还能重新回到池子里吗?
可以。多数机制都有"复检恢复"设计:被隔离或拉黑的节点会继续接受低频探测,连续多次检测通过后即可恢复调度权重。只有彻底失效、长期无法连通的节点才会被永久淘汰。
Q: 为什么有的节点能ping通,却被判定为无效?
因为ping通只代表网络层可达,不代表代理服务可用。端口没开放、协议不匹配、认证失败、目标网站返回异常,都会导致"ping得通但用不了"。所以健康检测必须发真实的代理请求,而不能只看ping结果。
Q: 检测周期设置多长比较合适?
没有统一答案。对成功率要求极高的场景建议30秒到1分钟一轮;一般采集类业务3~5分钟即可;同时一定要开启"业务请求失败即时降权",让真实失败第一时间反映到节点状态上。
Q: 自建IP池和使用天启HTTP这类服务商,该怎么选?
如果团队有开发运维能力、对定制化要求极高,可以自建并参考本文的检测与清洗逻辑;如果希望快速上线、省心稳定,直接使用天启HTTP这样自带节点健康维护的国内服务商更划算,省去搭建和维护成本,把精力集中在业务本身。