为什么数据采集最怕"出口"出问题
做数据采集的人大多有过这样的经历:脚本写好了,跑得也挺顺,但没多久目标网站就开始弹验证码、返回 403,甚至直接把访问来源拉进黑名单。表面上看是"被限流了",根子上其实是出口 IP 暴露得太明显。
很多团队最初用的是免费代理或者共享代理池,几十上百个采集任务挤在同一条出口通道上。这样做的后果很直接:只要其中一个使用者行为激进,整条通道就会被目标站点标记,而你明明是正常采集,却要跟着一起"背锅"。更麻烦的是,公网代理的链路往往是明文转发的,凡是经过它的请求参数、Cookie、返回内容,都存在被中途读取的可能。
所以企业做数据采集,真正要解决的不是"能不能访问",而是访问过程是否干净、是否可控、是否可追溯。这也是企业级代理和普通代理最本质的区别。
企业级代理到底防住了什么
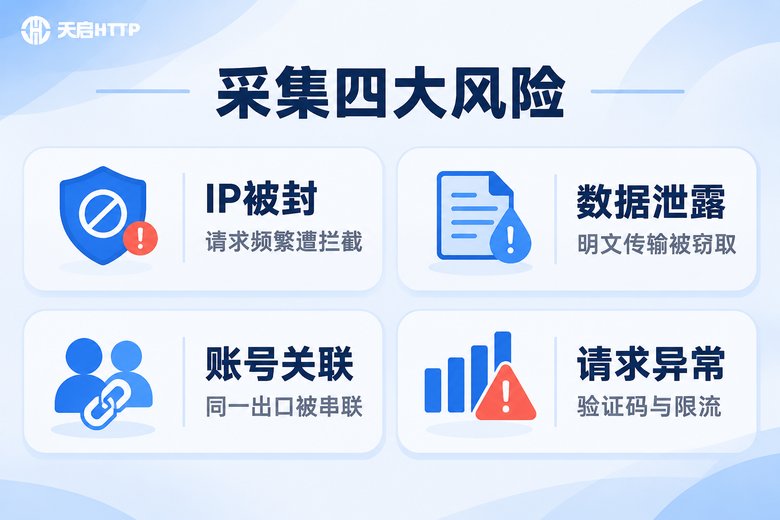
把安全这件事拆开看,数据采集环节常见的问题集中在四个方向:出口被批量拉黑、传输内容被被动获取、多个业务账号因为同一个出口被关联、请求节奏失控触发风控。企业级代理的价值,就是针对这四件事分别给出工程化的解法。
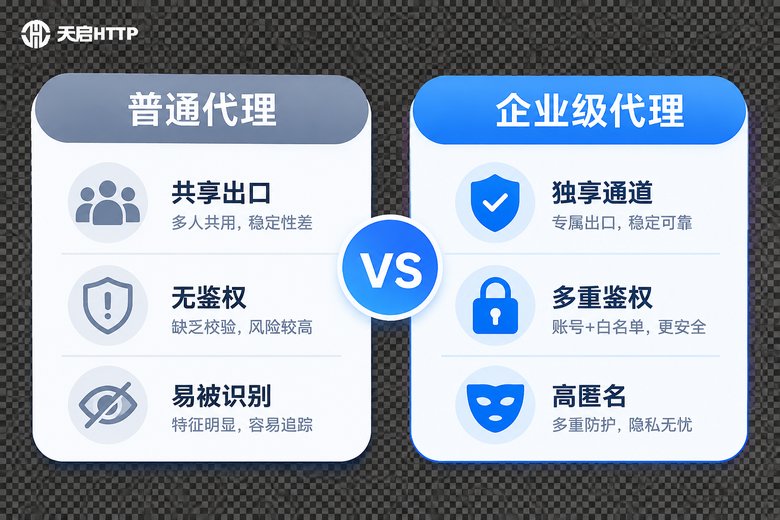
和随手找的共享代理相比,正规的企业级代理服务在通道隔离、身份校验、链路稳定性上都有明确的差异,具体可以看下面这张对照表:
| 对比维度 | 普通共享代理 | 企业级代理 |
|---|---|---|
| 出口隔离 | 多人共用,行为互相影响 | 独享通道,不与他人串用 |
| 身份校验 | 多数无鉴权,谁拿到地址都能用 | 账号密码鉴权 / IP 白名单双重限制 |
| 匿名程度 | 常透传真实来源信息 | 高匿名转发,不暴露原始请求头 |
| 稳定性 | 时断时续,成功率波动大 | 可用率有保障,长连接可维持 |
| 可管理性 | 无法统计,出问题难定位 | 后台可查看用量、可分配子账号 |
天启HTTP的三类通道,对应三种采集节奏
天启HTTP是国内代理 IP 服务商,产品线主要围绕国内网络环境设计。在数据采集场景里,常见的三种通道各有适用的位置:
短效动态代理:IP 按分钟级或按次更换,适合商品价格巡检、搜索结果翻页、资讯批量抓取这类"请求量大、单次会话短"的任务。因为出口在不断变化,单个目标站点很难对某个固定 IP 形成持续画像。
独享固定代理:通道由你单独使用,IP 长时间不变。它适合需要保持登录态的采集,比如后台数据导出、需要持续会话的业务系统对接。独享的最大好处就是干净——不会因为别人的行为把你的出口做脏。
隧道代理:你只需要连接一个固定入口,服务端自动完成 IP 轮换,代码里不用维护 IP 池,也不用手动切换。对于长期运行的采集服务,这种方式最容易做工程化封装,出错重试逻辑也更好写。
这三种通道都支持用户名密码鉴权和IP 白名单两种接入方式。白名单模式把调用方服务器的 IP 绑定到账号上,即使代理地址泄露,别人也调不动你的额度,这是很多团队容易忽略的一道保险。
一套可落地的安全采集方案
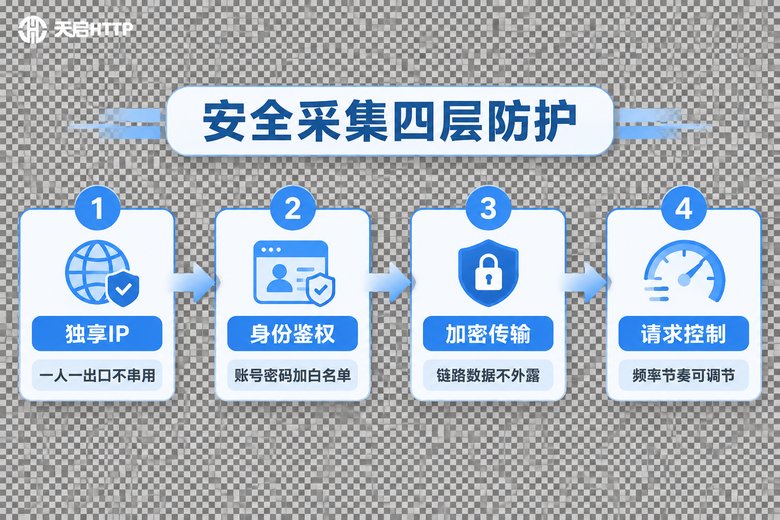
光有通道还不够,采集端本身也要配合。下面这套四层结构,是我们在实际项目里比较常用的组合:
第一层,出口隔离。把不同业务线的采集任务分配到不同的代理通道或子账号。比如竞品监控走一条动态通道,自家 ERP 数据同步走独享固定通道,两条线互不干扰,一条出问题不影响另一条。
第二层,身份鉴权。生产环境统一使用"账号密码 + IP 白名单"组合,密钥不写在代码仓库里,改用环境变量注入。这样即使代码泄露,攻击者也拿不到可用的代理凭证。
第三层,请求节流。给每个目标域名设置独立的并发上限和间隔,配合指数退避重试。采集不是越快越好,稳定的匀速请求比脉冲式的爆发更容易长期存活。
第四层,日志与告警。记录每次请求的通道、耗时、状态码,一旦失败率超过阈值就自动降速或切换通道。出了问题能第一时间定位到是哪条通道、哪个目标站点。
落到代码上,隧道代理的接入其实非常简单:
import os
import requests

# 代理入口与凭证从环境变量读取,不写死在代码里
# 具体的入口地址与端口,在官网后台开通后查看
proxy_host = os.getenv("TQ_PROXY_HOST")   # 例如 隧道入口地址
proxy_port = os.getenv("TQ_PROXY_PORT")
proxy_user = os.getenv("TQ_PROXY_USER")
proxy_pass = os.getenv("TQ_PROXY_PASS")

proxies = {
    "http":  f"http://{proxy_user}:{proxy_pass}@{proxy_host}:{proxy_port}",
    "https": f"http://{proxy_user}:{proxy_pass}@{proxy_host}:{proxy_port}",
}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
}

def fetch(url, retry=3):
    for i in range(retry):
        try:
            resp = requests.get(url, headers=headers, proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp.text
        except requests.RequestException:
            continue
        time.sleep(2 ** i)   # 指数退避,避免失败时疯狂重试
    return None
注意几个细节:超时时间一定要设,否则一条挂起的连接会拖垮整个采集队列;重试次数不要给太多,三次足够,剩下的交给上层任务调度;User-Agent 要固定且真实,很多人只换了 IP 却留着明显的脚本特征,照样会被识别。
选企业级代理时,容易踩的三个坑
坑一:只看 IP 数量,不看通道质量。IP 池再大,如果大部分地址已经被大量使用者做脏,实际可用的比例并不高。选型时更应该关注可用率和稳定性,而不是单纯的数字。
坑二:忽略鉴权方式。有些团队图省事,只用一个公共入口不加任何校验,结果额度被别人蹭用,排查半天找不到原因。账号密码鉴权和 IP 白名单能省掉大量麻烦。
坑三:把所有业务塞进同一条通道。核心业务和边缘任务混在一起,一旦某条线触发风控,全线受影响。分通道、分账号管理,是成本最低的容灾手段。
另外要提醒一句:天启HTTP 提供的是国内代理 IP服务,如果业务涉及境外站点的访问,这套方案并不适用,选型前先把场景对齐,能少走很多弯路。
常见问题
Q:企业级代理和普通代理在安全上最核心的差别是什么?
A:核心是"隔离"和"可控"。企业级代理通常是独享通道,不会和其他用户的行为互相牵连;同时提供账号密码鉴权、IP 白名单这类访问控制手段,谁能用、用了多少都能管得住。
Q:用了高匿代理就不会被封了吗?
A:不能这么理解。代理解决的是出口身份问题,但如果你的请求频率过高、请求头特征明显、行为模式单一,目标站点依然会拦截。代理要和请求节流、请求头伪装、重试策略配合使用。
Q:动态代理和独享固定代理该怎么选?
A:看是否需要保持会话。翻页抓取、价格监控这类每次请求独立的场景,用短效动态更合适;需要维持登录态、保持连续会话的,用独享固定代理更稳。长期运行的服务用隧道代理,代码维护成本最低。
Q:多账号采集为什么一定要做出口隔离?
A:因为目标平台通常会把同一出口 IP 上的多个账号关联起来。如果几个业务账号共用一条出口,其中一个账号触发风控,其他账号也可能被一并处理。按业务线拆分通道能有效降低这种连带风险。
Q:采集日志需要记录到什么程度?
A:至少记录时间、目标域名、使用的通道、状态码、耗时和失败原因。这些字段足够你在失败率上升时快速判断是通道问题、目标站点策略变化,还是采集逻辑本身出了 bug。