为什么你需要一个自己的代理IP库
做数据采集、多店铺运营、批量注册或接口测试的朋友,大多踩过同一个坑:临时去找几条代理IP,用完就废,下次再找一遍,如此循环。单条采购的问题很明显——数量不可控、质量不可控、调度更不可控。
所谓"代理IP库",本质上就是一份能随时调用的出口地址清单,加上一套让它自动保持干净的维护机制。它不复杂,但要建得好用,核心就四件事:采集、去重、打分、失效剔除。这四步不是做一次就完事,而是一个持续运转的循环。
四步法总览:一个循环,不是一个项目
很多人把建IP库当成一次性工程,写完脚本拉一批IP存进数据库就收工了。结果三天之后,池子里九成的地址已经跑不通。正确的做法是把四个动作串成一个循环:
- 采集:从多个来源持续补充新IP,保证池子有进水;
- 去重:把重复的、格式脏的挡在入库之前,避免无效膨胀;
- 打分:给每条IP一个健康分,让调度有依据;
- 失效剔除:定期体检,把死掉的降级或清出去,同时触发补池。
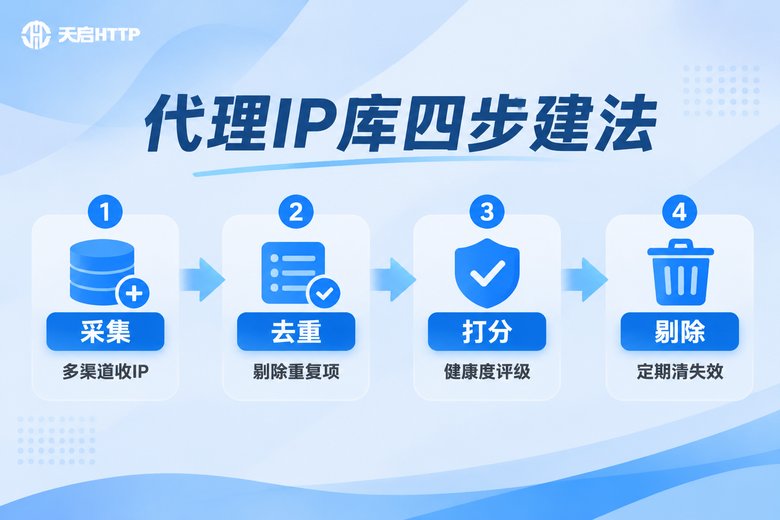
四步里只有第一步是"入口",后三步都属于"质量管控"。经验上看,质量管控花的时间通常比采集更多,也正是自建IP库和临时买几条IP的最大区别。
第一步 采集:IP从哪里来,怎么收进来
先明确一点:不要用网上公开的免费IP列表。这类地址绝大多数已经被滥用过,速度慢、存活短,而且来源不明,用在业务上有安全风险。可用的采集渠道主要三类:
1. 服务商接口拉取。正规代理服务商都会提供API提取地址,按需拉取一批IP。这是最省心的来源,质量稳定、有售后。像天启HTTP就支持通过接口按量提取短效代理IP,也有隧道代理、独享代理等形态,适合不同规模的业务。
2. 自有资源池导入。如果有自建的服务器或机房资源,可以把它们整理成统一格式批量导进库里,作为长期稳定的兜底资源。
3. 业务侧回流。在日常采集任务里,凡是实际跑通过、响应也快的出口,都可以打上标记回流进库,相当于让业务自己帮你筛出好IP。
采集环节要养成三个习惯:记来源、记时间、设超时。每条记录都要带上"从哪来的""什么时候进来的"两个字段,后面打分和剔除时全靠它。同时给请求设一个3到5秒的超时,卡住不动的直接放弃,别让一条慢IP拖住整批任务。
第二步 去重:把重复项挡在入库之前
去重看着简单,其实是最容易留下隐患的一步。常见的坑有三个:
格式不统一。有的记录写成"1.2.3.4:8080",有的写成"1.2.3.4:8080"(全角冒号),还有的端口前后带空格。不统一归一化,去重就形同虚设。
只按IP去重。同一台机器可能开放多个端口,只按IP去重会误删掉可用的端口组合,正确的主键应该是"IP + 端口 + 协议"。
去重后没更新。一条IP重新入库时,应该刷新它的最近活跃时间,而不是当成新条目再插一行。
一段最简的去重逻辑长这样:
def normalize(raw):
    """把各种脏格式统一成 ip:port"""
    raw = raw.strip().replace(":", ":")
    ip, port = raw.split(":")
    return f"{ip.strip()}:{int(port)}"

def dedup(raw_list):
    seen = set()
    result = []
    for item in raw_list:
        key = normalize(item)
        if key not in seen:
            seen.add(key)
            result.append(key)
    return result
实际项目里,建议把归一化后的 key 建成数据库唯一索引,让"去重"由存储层兜底,比在代码里判重更稳。
第三步 打分:给每条IP一个健康分
池子里几百上千条IP,调度时怎么选?总不能随机挑。最简单的办法是给每条IP算一个0到100的健康分,用速度、成功率、匿名度、稳定性四个维度来评。
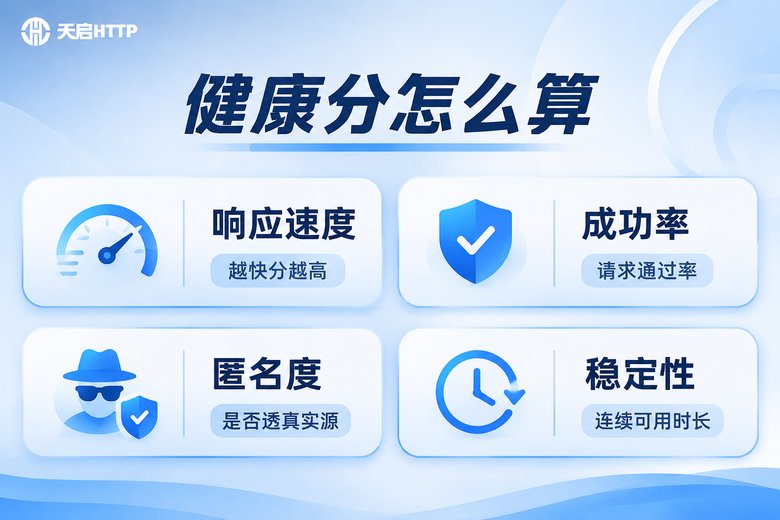
| 维度 | 权重 | 怎么测 |
|---|---|---|
| 响应速度 | 30 | 单次请求往返耗时,越快得分越高 |
| 成功率 | 40 | 连续请求N次,通过比例越高越好 |
| 匿名度 | 20 | 是否透传真实来源地址 |
| 稳定性 | 10 | 连续可用时长的长短 |
权重不是固定的,采集任务重的场景可以把成功率提到50以上,对速度敏感的场景则把速度权重加大。一个可以直接套用的简化实现:
def health_score(latency_ms, ok_rate, is_anonymous, stable_minutes):
    s = max(0, 30 - latency_ms / 100)      # 速度分,满分30
    s += ok_rate * 40                       # 成功率分,满分40
    s += 20 if is_anonymous else 0          # 匿名分,满分20
    s += min(10, stable_minutes / 6)        # 稳定分,满分10
return round(s, 1)分数算出来之后要分层用:80分以上做主力池,60到80做备用池,60以下进观察区。调度时优先取主力池,主力池不够再往下取,这样整体成功率会明显提升。
第四步 失效剔除:让池子一直"活着"
前面三步决定库建得怎么样,这一步决定库能用多久。失效剔除的关键是别等IP彻底死了才发现,而要提前把它降权。
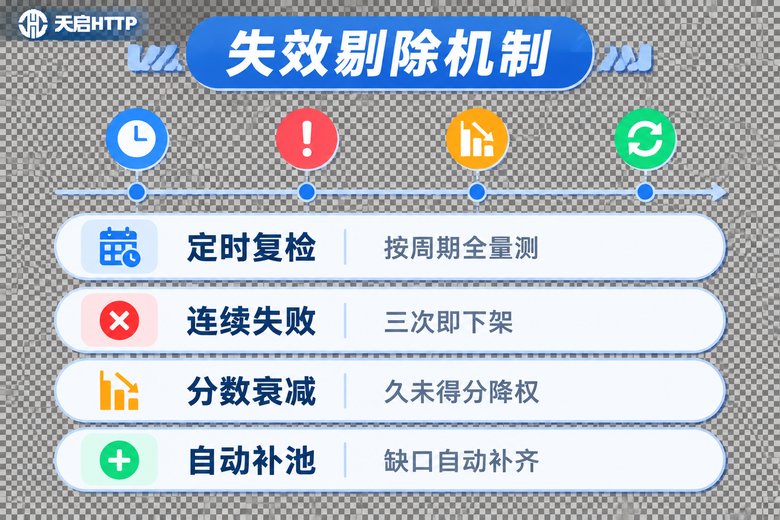
具体做法有四条:
定时复检。设一个固定周期(比如每10分钟)对主力池全量测一遍,备用池可以放宽到30分钟一轮,避免测得太勤把IP本身耗掉。
连续失败计数。一次失败可能只是网络抖动,连续三次失败的记录直接下架,不要反复重试浪费资源。
分数衰减。长时间没被调度、没拿到新分的IP,按天缓慢扣分。这样可以自动淘汰那些"测着还行、实际没用上"的僵尸条目。
自动补池。剔除之后池子会变薄,必须触发一次采集补齐。可以给池子设一个健康水位线,比如可用IP低于总数的60%就自动补。
还有一个细节:剔除不等于删除。把失败的IP挪到观察区保留一段时间,如果某条地址后来又恢复了,可以自动回到池子里,省下一次采集成本。
自建还是接入:大多数团队其实不需要从零造轮子
上面这套机制如果完整实现,大概需要一套采集脚本、一个存储、一个定时任务和一套调度策略。有技术团队的可以自己做,但如果业务重心不在基础建设上,把"稳定供给"这部分交给专业服务商,性价比通常更高。
| 对比项 | 完全自建 | 接入天启HTTP |
|---|---|---|
| 前期投入 | 需开发采集、去重、打分、调度 | 接口对接即可使用 |
| IP来源 | 需自行寻找稳定渠道 | 平台统一供给,持续更新 |
| 维护成本 | 需长期盯运行状态 | 服务端维护,客户端零负担 |
| 适用场景 | 超大规模、有定制需求 | 绝大多数常规采集与运营业务 |
天启HTTP 是国内代理IP服务商,提供短效代理、隧道代理、独享代理等产品形态,支持 HTTP、HTTPS、SOCKS5 协议接入,可以通过接口按需提取IP。对于不想自己养一套IP库维护系统的团队来说,直接用接口拉取、业务侧只做简单的可用性校验,就能满足大部分采集和运营需求。
需要说明的是,天启HTTP 的节点资源面向国内网络环境,不适用于需要海外IP的业务场景。
常见问题
Q:IP库需要多大才够用?
不看总数看可用数。一个500条但可用率90%的池子,远好过一个5000条但可用率只有15%的池子。建议先定"同时并发需要多少条",再按3到5倍冗余去建。
Q:多久做一次全量复检比较合适?
短效代理建议10到15分钟一轮,长效或独享类可以放宽到30分钟以上。复检本身也要走代理,太频繁会额外消耗配额。
Q:为什么我的IP刚采集回来就失效了?
多半是采集时没有做即时验证,把一批已经过期的地址直接入库了。正确做法是"采集完先测一轮,只有通过验证的才允许入库"。
Q:去重一定要自己写代码吗?
不必。把归一化后的"IP:端口:协议"设成数据库唯一索引,重复插入自动被拦截,代码里只需要做格式清洗就行。
Q:自己建的库和用服务商接口,能一起用吗?
可以,而且推荐这样做。把服务商接口作为主力进水口,自建逻辑只负责校验、打分和调度,两边优势都能拿到。
Q:打分模型调不好怎么办?
先别追求精细,用最简单的方案起步:只统计成功率,跑一周看看数据,再逐步加入速度、匿名度、稳定性几个维度。模型是调出来的,不是设计出来的。