代理IP大全到底是个什么东西
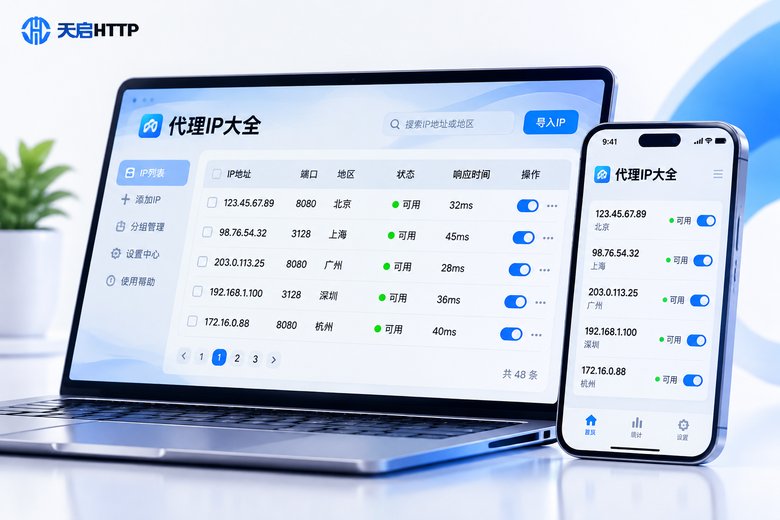
很多人第一次听到"代理IP大全"会以为是某个软件,其实它更像是一份可以调用的IP清单。里面通常包含这么几列:IP地址、端口、协议类型、所属地区、认证账号密码、有效期、当前延迟。数量从几十个到上万个都有可能。
之所以叫"大全",是因为来源杂、类型多:有一批是短效不断补充的,有一批是长期稳定的,还有一批是专供某个业务单独使用的。如果不做分类和筛选,直接把整份列表丢进程序里轮询,结果往往是一半的IP连不上,剩下的跑一会儿就失效。所以真正要解决的问题不是"怎么拿到IP",而是"怎么把这一大堆IP管明白"。
下面按实际操作顺序讲:先分类,再筛选,然后批量导入,最后批量导出留档。
第一步:分类清楚,别把不同用途的IP混在一起
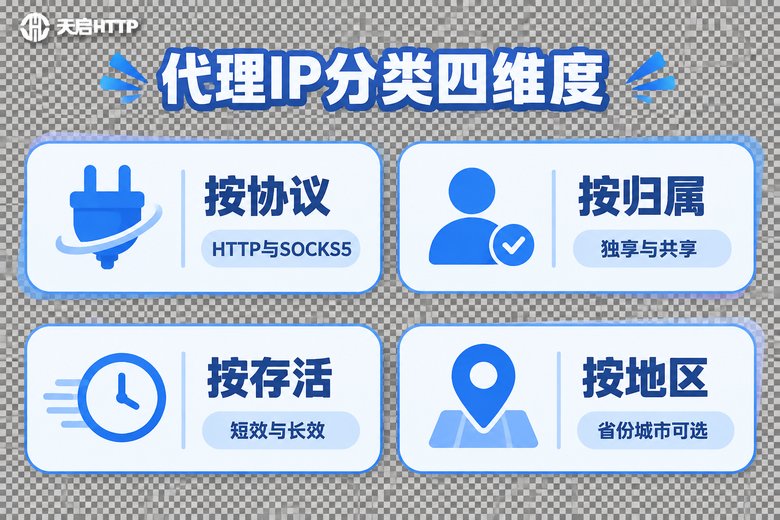
分类的目的是让后面每一步都有针对性。常见分法有四种,可以叠加使用:
| 分类方式 | 常见类型 | 特点 | 适合场景 |
|---|---|---|---|
| 按协议 | HTTP、HTTPS、SOCKS5 | HTTP对接简单,SOCKS5通用性强 | 网页采集、客户端程序 |
| 按归属 | 独享、共享 | 独享只有自己在用,共享多人共用 | 稳定性要求高的业务 / 临时测试 |
| 按存活 | 短效、长效、静态 | 短效几分钟到几十分钟,静态长期不变 | 高频切换 / 长期挂机 |
| 按认证 | 账密认证、IP白名单 | 账密换机器不用改配置,白名单省去传参 | 多终端 / 固定服务器 |
实操建议在表格里加一列"业务标签",比如采集组、账号组、测试组,一列就能解决后续调度问题。谁用哪类IP,一眼看清,不会出现测试IP被正式业务占满的情况。
第二步:筛选,把不能用的先淘汰掉
一份几千条的列表,真正能跑的可能只有六成。筛选按下面的顺序做,效率最高:
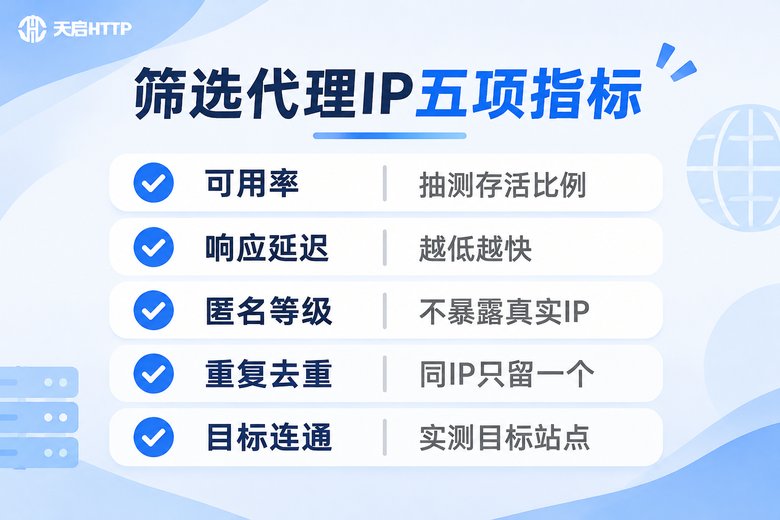
1. 先做格式清洗。把全角冒号、空格、换行符、注释行统一处理掉,格式不对的直接剔除,不然后面测活全是报错。
2. 去重。同一个IP和端口重复出现很常见,保留一条就行。
3. 抽测存活。不用逐条测,随机抽 10%~20% 做连通性测试,算出可用率,可用率太低的整批先放一边。
4. 测延迟和目标连通。能连上不代表能干活,要用真实业务的目标站点复测一次。延迟一般控制在 100 毫秒以内体验比较顺畅,超过 300 毫秒就要谨慎用在并发高的任务上。
5. 看匿名等级。做账号类业务时,优先选不往请求头里塞真实IP的高匿代理,避免被目标站点识别。
import requests

def check_proxy(proxy, test_url="https://www.baidu.com", timeout=5):
    """返回 True 表示这个代理当前可用"""
    proxies = {"http": proxy, "https": proxy}
    try:
        r = requests.get(test_url, proxies=proxies, timeout=timeout)
        return r.status_code == 200
    except Exception:
        return False

# 用法:逐条验证后放进可用池
ok_pool = [p for p in proxies_list if check_proxy(p)]
print("可用数量:", len(ok_pool))
第三步:批量导入,格式统一才是关键
导入之所以总出错,八成是格式没对齐。先把所有条目统一成两种最常见的写法之一,再导入就顺了:
写法一:IP:端口,适合IP白名单认证的代理。
写法二:IP:端口:账号:密码,适合账密认证的代理。
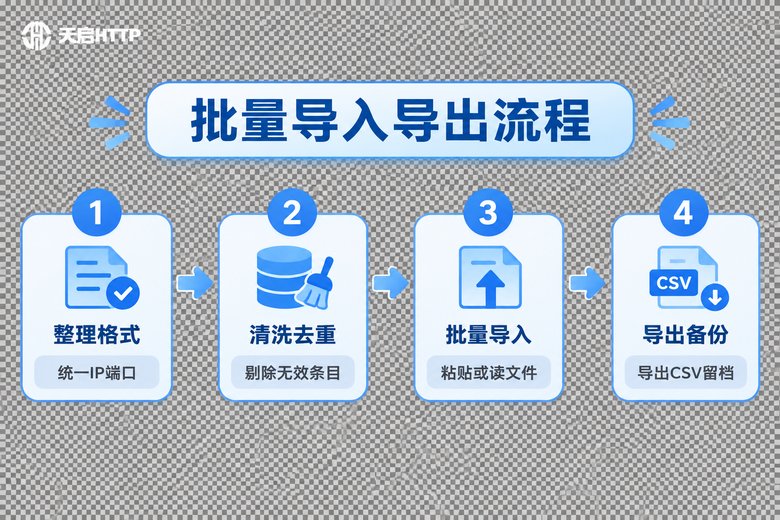
整理好之后,导入有三种方式,按需选:
· 直接粘贴:软件里一般有"批量添加"输入框,一行一条粘进去即可,适合几百条以内。
· 读取文件:把列表存成 txt 或 csv,用程序读取解析,适合上千条。
· 接口拉取:用服务商提供的提取链接,按需拉一批,用完再拉,不用自己维护列表。
def parse_line(line):
    """把一行文本解析成标准结构,格式不对返回 None"""
    line = line.strip().replace(":", ":").replace(" ", "")
    if not line or line.startswith("#"):
        return None
    parts = line.split(":")
    if len(parts) == 2:
        return {"host": parts[0], "port": parts[1], "user": None, "pwd": None}
    if len(parts) == 4:
        return {"host": parts[0], "port": parts[1], "user": parts[2], "pwd": parts[3]}
    return None

seen, pool = set(), []
with open("proxy.txt", encoding="utf-8") as f:
    for line in f:
        item = parse_line(line)
        if not item:
            continue
        key = (item["host"], item["port"])   # 用 IP+端口 作为去重依据
        if key in seen:
            continue
        seen.add(key)
        pool.append(item)

print("去重后有效条目:", len(pool))导入完成后先别急着上量,挑几条手动跑一次,确认认证方式、协议类型和程序里配置的一致。很多"导入成功但用不了"的情况,都是协议填成了 HTTP 而实际是 SOCKS5。
第四步:批量导出与定期备份
导出不只是留个底,更是为了做数据沉淀。建议导出的字段固定成这几列:IP、端口、协议、地区、认证方式、延迟、过期时间、业务标签。字段固定下来之后,每次导出都能直接和历史数据对比,知道哪一批IP质量在下降。
import csv

with open("proxy_export.csv", "w", newline="", encoding="utf-8-sig") as f:
    writer = csv.writer(f)
    writer.writerow(["IP", "端口", "协议", "地区", "延迟", "过期时间", "业务标签"])
    for p in pool:
        writer.writerow([p["host"], p["port"], p.get("protocol", "HTTP"),
                         p.get("area", ""), p.get("delay", ""),
p.get("expire", ""), p.get("tag", "默认")])两个小习惯很有用:一是按日期命名文件,比如 proxy_20240612.csv,回溯起来方便;二是短效IP定时自动导出,设个定时任务每小时跑一次,程序崩溃了也能快速恢复,不用重新整理一大轮。
为什么不少团队最后会选天启HTTP
自己拼凑代理列表,最大的成本不在获取,而在维护:测活、去重、补量、盯延迟,全是琐碎活。天启HTTP 是国内代理IP服务商,把这些环节做成了可直接调用的能力:支持 HTTP、HTTPS、SOCKS5 三种协议,提供独享代理IP、隧道代理和 API 提取等使用方式,节点覆盖国内多个省市地区,认证上同时支持账密认证和 IP 白名单。
对接方式也很直接:要一批测一批的,用提取链接按需拉取,拉回来的就是清洗过的可用IP;需要固定入口自动换IP的,用隧道模式,程序里只需要配置一个地址,不用自己维护列表。对于需要长期稳定IP的账号类业务,独享类型不会和别人共用,波动小很多。
常见问题
Q:代理IP大全里的IP,为什么刚导入还能用,过一会儿就失效了?
大概率是短效IP到期了。短效代理的有效期通常只有几分钟到几十分钟,需要在程序里做成"失效即补充"的机制,别一次性导进来就再也不管。
Q:批量导入时提示格式错误怎么办?
先检查三处:是不是全角冒号、有没有多余空格、认证信息是不是漏了。统一改成半角 IP:端口 或 IP:端口:账号:密码 再导入,基本都能解决。
Q:独享IP和共享IP该怎么选?
要求稳定、怕被别人拖累速度的业务选独享;只是做连通性测试、临时跑一下的,共享就够用,成本更低。
Q:筛选时延迟多少算正常?
国内节点一般 30~100 毫秒比较理想,100~300 毫秒属于可用但要注意并发量,超过 300 毫秒建议直接淘汰,不然业务超时会越来越多。
Q:导入了几百个IP,程序怎么自动轮换?
最简单的做法是维护一个可用池,每次请求随机取一条,失败就标记并换下一条,定时把失败次数过多的条目剔除,再从提取接口补新的进来。
Q:天启HTTP支持哪些协议和提取方式?
支持 HTTP、HTTPS、SOCKS5 协议,提供 API 提取和隧道代理两种主要方式,认证支持账密认证与 IP 白名单,按业务需要选择即可。