

为什么Python采集离不开代理IP
用Python写采集脚本的朋友几乎都遇到过同一个问题:脚本跑得好好的,突然所有请求开始失败,返回403、429,或者干脆连接被重置。原因很简单——目标网站对单个IP的访问频率做了限制,同一个IP短时间请求太多,就会被限流甚至拉黑。
这时候代理IP就是最直接的解法。原理不难理解:你的请求不再直接从本机发出去,而是先发给代理服务器,由代理服务器代替你去访问目标网站,再把结果原样带回来。对目标网站来说,看到的是代理服务器的IP,而不是你的真实IP。
所以"好用的代理IP"通常要满足三个条件:可用率高(拿到手就能用,不用一个一个试)、响应速度快(不然采集效率反而下降)、能批量提取(方便脚本自动轮换)。先把手上的代理用起来,再讲怎么挑。
requests配置代理的核心写法
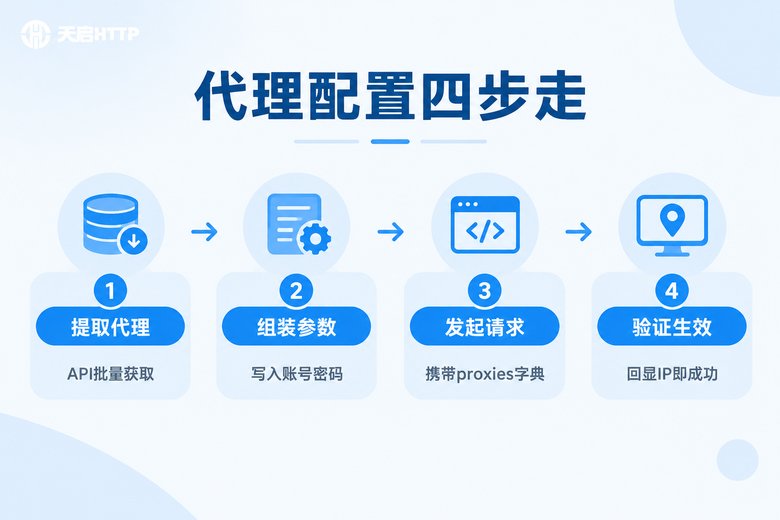
requests库对代理的支持非常友好,核心就是一个 proxies 字典。最基本的写法如下:
import requests

proxies = {
    "http": "http://123.45.67.89:8080",
    "https": "http://123.45.67.89:8080"
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.text)
# 返回的origin字段如果是代理IP,说明配置成功
有几个细节值得注意:
第一,https的键也可以写http://开头。很多人以为https请求必须配https代理,其实requests会通过代理建立隧道转发加密流量,这里的"http://"指的是代理服务器本身的协议,不是目标网站的协议。
第二,如果代理需要账号密码认证,直接把认证信息写进URL:
proxies = {
    "http": "http://用户名:密码@123.45.67.89:8080",
    "https": "http://用户名:密码@123.45.67.89:8080"
}
第三,建议每次配置完先用回显服务验证一下,确认返回的是代理IP而不是本机IP,再正式开跑。
用Session统一管理代理和请求头
实际项目中不建议每次请求都单独传proxies,更推荐用 Session 对象统一管理,还能顺手把请求头伪装成浏览器:
import requests

session = requests.Session()
session.proxies.update({
    "http": "http://123.45.67.89:8080",
    "https": "http://123.45.67.89:8080"
})
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
})

resp = session.get("https://example.com", timeout=10)
Session的好处是:代理、Cookie、请求头全部自动保持,代码更干净,后续做IP轮换也只需要改session.proxies这一处。
超时、重试与IP轮换:让脚本更抗造
代理IP不像本机网络那么稳定,个别节点偶尔响应慢甚至失效很正常。给脚本加上超时和自动重试,整体可用率会明显提升:
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
import requests

session = requests.Session()
session.proxies.update({
    "http": "http://123.45.67.89:8080",
    "https": "http://123.45.67.89:8080"
})

retry = Retry(total=3, backoff_factor=1,
              status_forcelist=[500, 502, 503, 504])
adapter = HTTPAdapter(max_retries=retry)
session.mount("http://", adapter)
session.mount("https://", adapter)

resp = session.get("https://example.com", timeout=(5, 10))
这段代码的含义是:失败自动重试3次,每次间隔递增;timeout设成"连接5秒、读取10秒"的元组,避免某个慢节点把整个脚本卡死。
再进一步,可以维护一个IP池做随机轮换,进一步降低单个IP的压力:
import random

ip_pool = [
    "http://123.45.67.89:8080",
    "http://123.45.67.90:8080",
    "http://123.45.67.91:8080"
]

def get_proxies():
    ip = random.choice(ip_pool)
    return {"http": ip, "https": ip}

resp = requests.get("https://example.com",
                    proxies=get_proxies(), timeout=10)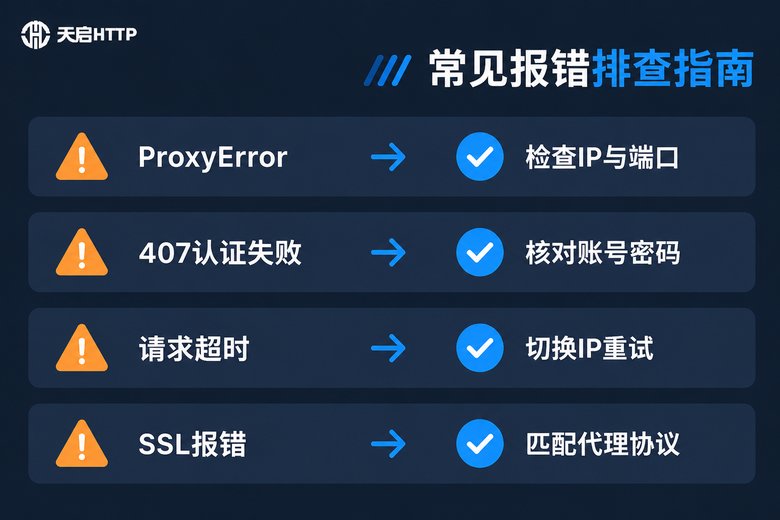
常见报错与排查方案
配置代理后跑不通,九成出在下面这几个报错上。对照表格逐项排查,基本都能解决:
| 报错信息 | 常见原因 | 处理方案 |
|---|---|---|
| ProxyError | 代理失效、IP或端口写错 | 换一个可用IP,核对端口和协议 |
| 407 Proxy Authentication Required | 账号密码错误或格式不对 | 检查"用户名:密码@"写法,特殊字符要转义 |
| ConnectTimeout / ReadTimeout | 代理节点响应慢 | 加大超时时间或切换节点 |
| SSLError | 代理不支持https隧道 | 确认服务商支持https,或目标站改走http测试 |
| Max retries exceeded | IP被目标站封禁 | 降低请求频率,轮换IP |
还有一个隐藏坑:系统环境变量干扰。如果系统里设置过HTTP_PROXY、HTTPS_PROXY环境变量,requests会自动读取,可能覆盖你的配置。排查时可以在代码里加上 session.trust_env = False,强制只使用代码里显式传入的代理。
怎么挑选好用的代理IP服务
自己搭代理服务器成本高、维护累,绝大多数采集项目直接用现成的代理服务更划算。挑选时重点看四点:一看可用率,IP拿到手能不能直接用,直接决定脚本成败;二看响应速度,代理太慢,采集效率反而不如不用;三看提取方式,有没有API批量提取接口,能不能配合脚本自动轮换;四看协议支持,至少要覆盖HTTP和HTTPS。
如果是面向国内网站的采集业务,可以优先了解天启HTTP。它是国内的IP代理服务商,依托自建机房提供覆盖国内多城市的IP资源,支持HTTP、HTTPS、SOCKS5等常用协议,通过API即可批量提取IP,官方文档里也提供了Python的接入示例代码,把示例里的代理地址替换进前面讲的proxies字典就能直接跑,对新手很友好。

常见问题
Q: 设置了代理,为什么查到的还是本机IP?
先检查proxies字典的键名是否写对(必须小写http/https),再确认代理本身可用,最后排查系统环境变量是否覆盖了配置。用回显服务验证最直观。
Q: https请求能走http代理吗?
可以。proxies里https键写"http://"开头即可,requests会通过代理建立隧道转发加密流量,不影响安全性。
Q: 免费代理能用吗?
不推荐。免费代理可用率极低、速度慢,还存在流量被窥探的安全风险。正式项目建议使用天启HTTP这类正规付费服务,稳定性和安全性都有保障。
Q: 请求频率太高被封IP怎么办?
三管齐下:使用API提取的IP池做轮换、每次请求之间加随机延时、配合前面讲的自动重试机制。天启HTTP的API批量提取正好可以配合脚本自动换IP。
Q: 天启HTTP怎么接入Python项目?
在其官网获取API提取链接后,请求接口拿到IP列表,按本文的proxies写法填入即可。官方文档提供完整的Python示例,照着改几行代码就能跑通。