
用Java写爬虫,最头疼的往往不是解析网页,而是程序跑着跑着请求突然全挂:要么返回403,要么连续超时,要么直接弹验证码。原因很简单——同一个IP在短时间内高频访问,目标网站的反爬机制很快就会盯上你。本文从原理讲到代码,手把手教你用Java通过代理IP发送HTTP请求,并给出一套可直接落地的防反爬实战方案。
一、为什么Java爬虫必须用代理IP
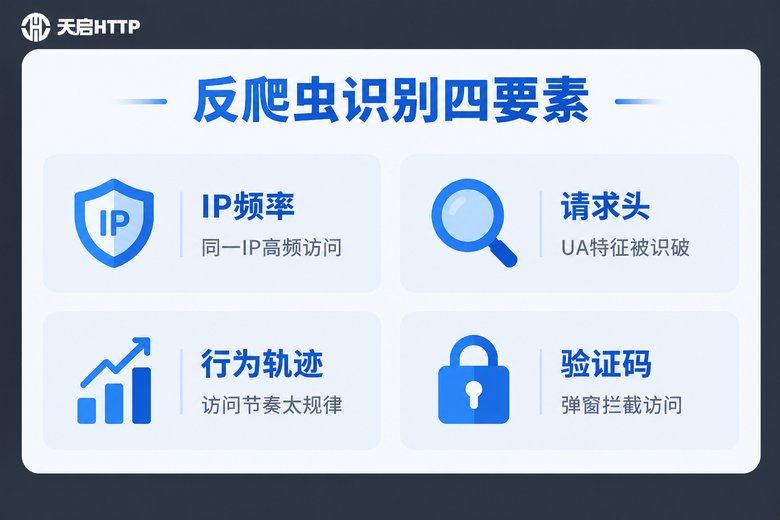
反爬虫的本质,是网站通过一系列特征判断"这是不是一台机器在批量访问"。常见的识别手段有四类:
1. IP频率限制:同一个IP每分钟请求几十上百次,直接触发限流或封禁;
2. 请求头检测:缺少User-Agent、Referer,或者UA写着"Java/1.8",一眼就被认出是程序;
3. 行为轨迹分析:访问间隔精确到毫秒、只抓目标页面不点其他链接,行为太规律;
4. 验证码拦截:疑似爬虫时弹出滑块或图形验证码,请求直接中断。
而代理IP的作用,就是让每次请求从不同的出口IP发出,把访问压力分散到大量IP上,单个IP的请求频率降下来,被封的概率自然大幅降低。再配合请求头伪装和频率控制,就能搭建起一套完整的反反爬体系。
二、Java设置代理发送HTTP请求的三种方式
下面三种方式覆盖了绝大多数Java项目,代码可以直接复制使用,把IP和端口换成你自己从代理服务商后台提取的地址即可。
方式一:HttpURLConnection(JDK自带,零依赖)
适合轻量级采集任务,不需要引入任何第三方依赖,通过java.net.Proxy对象即可挂上代理:
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.net.HttpURLConnection;
import java.net.InetSocketAddress;
import java.net.Proxy;
import java.net.URL;

public class JdkProxyDemo {
    public static void main(String[] args) throws Exception {
        // 代理IP和端口从服务商后台提取
        Proxy proxy = new Proxy(Proxy.Type.HTTP,
                new InetSocketAddress("123.45.67.89", 8080));

        URL url = new URL("http://httpbin.org/get");
        HttpURLConnection conn = (HttpURLConnection) url.openConnection(proxy);
        conn.setRequestMethod("GET");
        conn.setConnectTimeout(5000);
        conn.setReadTimeout(5000);
        // 伪装浏览器请求头,降低被识别概率
        conn.setRequestProperty("User-Agent",
                "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36");

        BufferedReader reader = new BufferedReader(
                new InputStreamReader(conn.getInputStream(), "UTF-8"));
        String line;
        while ((line = reader.readLine()) != null) {
            System.out.println(line);
        }
        reader.close();
    }
}
方式二:Apache HttpClient(功能最全面)
中大型采集项目的首选,连接池、重试、Cookie管理都很成熟。先引入依赖:
<dependency>
    <groupId>org.apache.httpcomponents</groupId>
    <artifactId>httpclient</artifactId>
    <version>4.5.14</version>
</dependency>通过RequestConfig设置代理:
import org.apache.http.HttpHost;
import org.apache.http.client.config.RequestConfig;
import org.apache.http.client.methods.CloseableHttpResponse;
import org.apache.http.client.methods.HttpGet;
import org.apache.http.impl.client.CloseableHttpClient;
import org.apache.http.impl.client.HttpClients;
import org.apache.http.util.EntityUtils;

public class HttpClientProxyDemo {
    public static void main(String[] args) throws Exception {
        HttpHost proxy = new HttpHost("123.45.67.89", 8080, "http");
        RequestConfig config = RequestConfig.custom()
                .setProxy(proxy)
                .setConnectTimeout(5000)
                .setSocketTimeout(5000)
                .build();

        try (CloseableHttpClient client = HttpClients.custom()
                .setDefaultRequestConfig(config).build()) {
            HttpGet get = new HttpGet("http://httpbin.org/get");
            get.setHeader("User-Agent",
                    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36");

            try (CloseableHttpResponse response = client.execute(get)) {
                System.out.println(EntityUtils.toString(response.getEntity(), "UTF-8"));
            }
        }
    }
}
方式三:OkHttp(API最简洁)
代码量少、性能好,追求开发效率可以选它:
import okhttp3.OkHttpClient;
import okhttp3.Request;
import okhttp3.Response;

import java.net.InetSocketAddress;
import java.net.Proxy;
import java.util.concurrent.TimeUnit;

public class OkHttpProxyDemo {
    public static void main(String[] args) throws Exception {
        Proxy proxy = new Proxy(Proxy.Type.HTTP,
                new InetSocketAddress("123.45.67.89", 8080));

        OkHttpClient client = new OkHttpClient.Builder()
                .proxy(proxy)
                .connectTimeout(5, TimeUnit.SECONDS)
                .readTimeout(5, TimeUnit.SECONDS)
                .build();

        Request request = new Request.Builder()
                .url("http://httpbin.org/get")
                .header("User-Agent", "Mozilla/5.0 (Windows NT 10.0; Win64; x64)")
                .build();

        try (Response response = client.newCall(request).execute()) {
            System.out.println(response.body().string());
        }
    }
}
三种方式怎么选?看这张对比表:
| 方式 | 是否需要依赖 | 优点 | 适用场景 |
|---|---|---|---|
| HttpURLConnection | 否,JDK自带 | 零依赖、轻量 | 简单采集、小脚本 |
| Apache HttpClient | 是 | 连接池、重试机制成熟 | 中大型采集项目 |
| OkHttp | 是 | API简洁、性能好 | 追求开发效率的团队 |
三、避免反爬虫的实战技巧
挂上代理只是第一步,真正稳定的采集系统还需要下面这套组合拳。
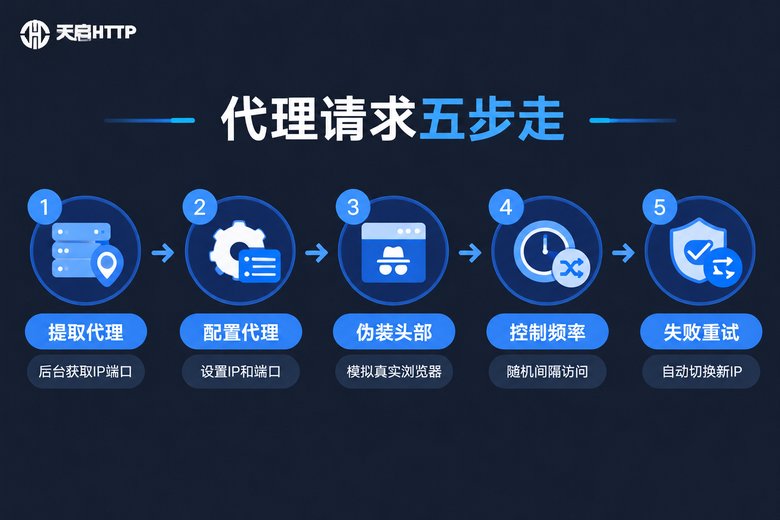
1. 搭建代理IP池,自动轮换
不要全程只用一个IP,把服务商提供的多个IP放进池子里,每次请求随机取一个,失败就换下一个:
import java.util.List;
import java.util.Random;

public class ProxyPool {
    private static final List<String> PROXY_LIST = List.of(
            "123.45.67.89:8080",
            "98.76.54.32:3128",
            "101.102.103.104:8888"
    );

    private static final Random RANDOM = new Random();

    public static String getRandomProxy() {
        return PROXY_LIST.get(RANDOM.nextInt(PROXY_LIST.size()));
    }
}
2. 伪装请求头
至少带上User-Agent和Referer,模拟真实浏览器行为;有条件的话维护一个UA列表轮换使用,避免所有请求都用同一个UA,那样等于换了个IP却留着同一张"名片"。
3. 控制请求频率
在两次请求之间加入随机休眠,让访问节奏更像真人:
Thread.sleep(1000 + new Random().nextInt(2000)); // 随机休眠1~3秒4. 超时与失败重试
务必设置连接超时和读取超时(建议5秒左右),捕获异常后自动从IP池换一个新IP重试;遇到403、429状态码时,说明当前IP已被限制,应立即切换,不要死磕。
四、代理IP怎么选?
选代理服务商,重点看五个指标:IP可用率(可用率低的项目会大量报错重试)、响应速度(延迟高会拖慢整体采集效率)、匿名度(必须高匿名,否则目标网站能看到你的真实IP)、IP池规模与城市覆盖(池子越大越不容易撞车)、协议支持(HTTP/HTTPS/SOCKS5按需选择)。
这里推荐天启HTTP:国内IP代理服务商,自建机房,支持HTTP/HTTPS/SOCKS5多种协议,高匿名模式,IP覆盖国内多个城市,响应快、可用率高,非常适合国内网站的采集场景。注册后在后台提取IP和端口,直接替换上文代码中的代理地址就能跑起来。
常见问题
Q: 怎么验证代理IP是否生效?
访问一个返回本机IP的接口(例如 httpbin.org/ip),对比返回结果是不是代理IP而非本机真实IP,如果是代理IP就说明配置成功了。
Q: 代理请求一直超时怎么办?
先检查IP是否已过期(短效代理存活时间有限),再确认端口和认证方式是否正确;代码层面设置好超时时间,失败后自动换IP重试即可。
Q: 免费代理能用吗?
不推荐。免费代理可用率低、速度慢、稳定性差,还可能因为被大量人用过而早已被目标站拉黑。正式项目建议使用天启HTTP这类国内付费代理服务,稳定性和效率完全不是一个量级。
Q: 代理IP多久换一次合适?
没有固定标准。短效代理按服务商标注的存活时间轮换;实际采集中发现连续超时或返回403、429,就应立即切换新IP。
Q: 高并发采集要注意什么?
使用连接池复用连接(如HttpClient的PoolingHttpClientConnectionManager),控制单个IP的并发数,配合大IP池轮换分摊压力,避免把单个IP瞬间打爆。