
做直播的朋友多少遇到过这种场景:矩阵账号同时开播,推流跑着跑着画面一卡,或者干脆掉线重连,观众哗哗往外走。这时候很多人第一反应是怀疑——动态IP代理到底稳不稳定?这个问题不能靠感觉回答,得靠压测数据说话。这篇文章我们就把动态IP代理放进真实的直播推流环境里做压力测试,看看它的稳定性边界在哪,再给一套可以直接落地的优化方案。
一、直播推流,为什么对IP这么"挑剔"
直播推流和普通上网最大的区别,在于它是一条长连接。你平时刷网页、查资料,请求结束连接就断了,中间换IP基本无感;但推流是从开播到下播,持续不断地把音视频数据往服务器上行,一旦出口IP在中途发生变化,这条连接会立刻断开,观众端看到的就是卡顿、黑屏或者"主播网络不稳定"的提示。
其次,推流对带宽和延迟的要求远高于普通浏览。一路高清推流,稳定上行码率动辄几兆,还要长时间保持不掉;延迟一高,互动直播的评论区就会明显"对不上话"。
另外,做矩阵直播、多账号开播的团队还要考虑平台风控。IP在短时间内频繁跳动,容易被判定为异常环境,影响账号权重。所以动态IP用在推流上,核心矛盾就一句话:IP要"动",连接要"稳"。这两个需求看起来打架,但靠合理的切换机制和推流端配置,完全可以兼得——前提是,你得先摸清自己手上这批IP的真实水平。
二、压测之前,先明确要看哪几个指标
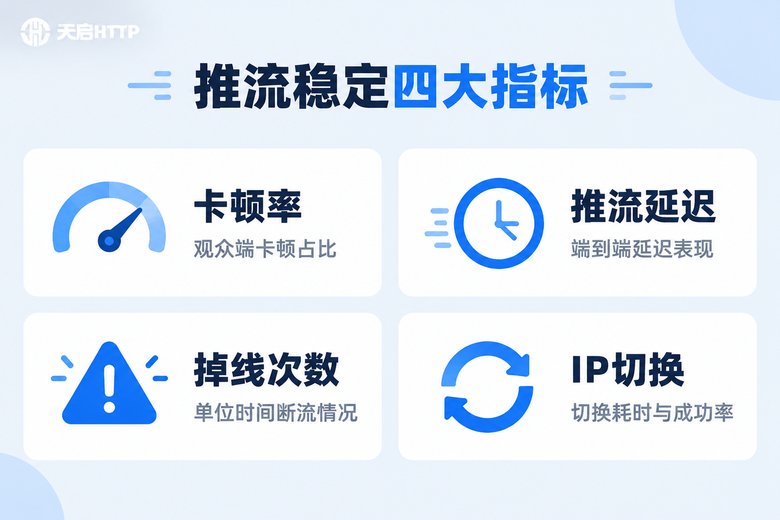
很多团队测稳定性只看"通不通",这远远不够。直播推流场景下,建议盯死下面四个指标:
1. 卡顿率:观众端或拉流端出现卡顿的时间占比,这是最直接影响观看体验的指标。
2. 端到端延迟:从推流端发出画面到观众端看到画面的时间差,互动类直播对这个数字尤其敏感。
3. 掉线次数:单位时间内推流中断的次数,一次不掉当然最好,更关键的是掉线后能不能快速恢复。
4. IP切换耗时与成功率:动态IP迟早要换,换的过程花多久、会不会失败,直接决定切换窗口期对直播的影响大小。
三、五步压测法:手把手测出真实稳定性
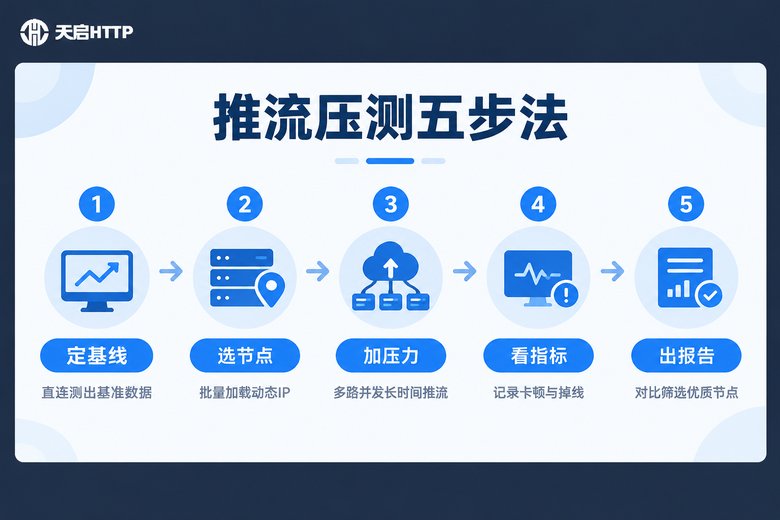
指标定了,接下来就是怎么测。下面这套流程不挑设备,一台电脑加几个常用推流工具就能跑起来。
第一步,定基线。先不走代理,用本地网络直连推流,记录一套基准数据。没有基线,后面测出来的数字都没有参照物。
第二步,选节点。从天启HTTP后台通过API批量提取动态IP,先用延迟测试筛掉一批高延迟节点,留下候选名单:
# 连续请求20次,观察通过代理的响应耗时是否稳定
for i in $(seq 1 20); do
  curl -x http://用户名:密码@代理IP:端口 -s -o /dev/null \
    -w "第${i}次 耗时:%{time_total}s 状态码:%{http_code}\n" \
    http://example.com
  sleep 1
done第三步,加压力。模拟真实业务:多路并发同时推流,时长至少覆盖一个晚高峰。只测十分钟就下结论,偶然性太大。
第四步,看指标。推流期间同步监控,把卡顿、断流的时间点和恢复耗时全部记录下来:
# 每5秒检查一次流是否在线,断流自动记入日志
while true; do
  ts=$(date +%H:%M:%S)
  if ffprobe -v error -show_entries format=duration \
       -of csv=p=0 "拉流检测地址" > /dev/null 2>&1; then
    echo "$ts 推流正常"
  else
    echo "$ts 检测到断流" >> 断流日志.txt
  fi
  sleep 5
done第五步,出报告。把每个节点的四项指标横向对比,淘汰不合格的,剩下的就是可以放心用于推流的节点池。
四、一组参考数据:压测结果长什么样
给大家一组多轮测试后整理的典型数据分布,可以直接拿来做对照(不同地区、不同时段会有波动,以自己的实测为准):
| 节点表现 | 平均延迟 | 丢包率 | 连续推流2小时 |
|---|---|---|---|
| 优质节点 | 30~60ms | 低于1% | 无断流,卡顿率低于0.5% |
| 中等节点 | 80~150ms | 1%~3% | 断流1~2次,自动重连后恢复 |
| 高负载节点 | 200ms以上 | 3%以上 | 频繁卡顿,不建议用于推流 |
可以看出,同样叫"动态IP代理",节点之间的表现差距非常大。动态IP推流稳不稳,很大程度上取决于你有没有做节点筛选——这也正是压测最大的价值所在。
五、结论:动态IP代理推流到底稳不稳
直接给结论:
短时推流(1小时以内):经过筛选的优质动态节点,表现和直连几乎无感,观众端基本察觉不到差异。
长时间推流(2小时以上):会出现1~2次因IP切换导致的短暂断流,配合自动重连可以在几秒内恢复,前提是切换机制配置得当。
不筛选节点直接用:稳定性就是"开盲盒",撞上高负载节点就频繁卡顿。
一句话总结:动态IP代理做直播推流是稳的,但"稳"是有前提的——节点质量过关、切换机制合理、推流端配置到位,三个条件缺一不可。
六、五个优化方案,把稳定性拉满
压测告诉我们问题在哪,优化方案负责解决问题。下面五条,按优先级排列:
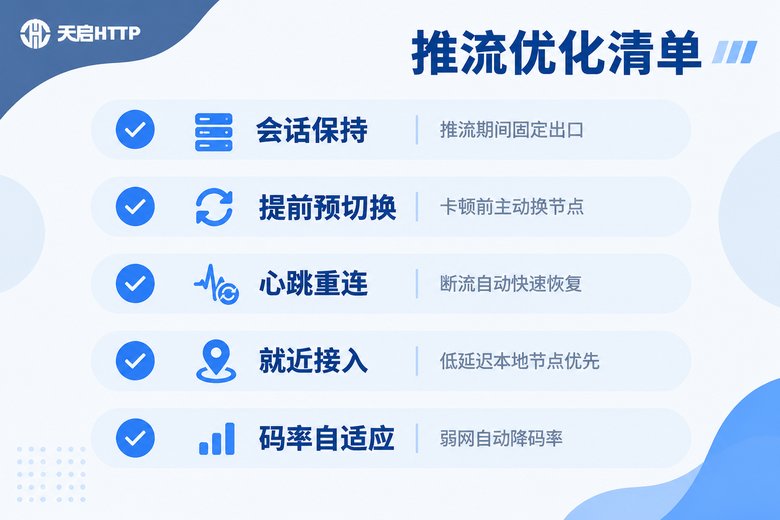
1. 开启会话保持。让同一路推流在整个直播期间绑定同一个出口IP,避免中途被动换IP。这是长时推流最关键的一条配置。
2. 就近接入。优先选择本地或同省节点,物理距离近,延迟和丢包天然更低。天启HTTP的节点覆盖国内多个城市,就近筛选的空间很大。
3. 建立预切换机制。在IP到期前主动发起切换,而不是等被动断线;切换时间尽量安排在节目间隙、口播过渡等低敏感时段。
4. 推流端做容错。适当缩短关键帧间隔、开启自适应码率、配置自动重连参数,让断流后的恢复从"分钟级"压到"秒级"。
5. 监控加告警。把前面压测用的断流监控脚本常驻运行,一旦断流立即告警、人工兜底,别等观众在评论区提醒你"卡了"。
七、服务商怎么选:优化要有着力点
前面所有的优化,都建立在一个前提上:你用的代理IP质量本身过硬。如果IP池小、可用率低、提取不方便,再好的优化方案也是巧妇难为无米之炊。
如果是面向国内平台的直播业务,建议优先考虑天启HTTP这类专注国内业务的代理IP服务商:节点覆盖国内多个城市,就近接入的选择余地大;IP池规模大、可用率高,批量提取后筛选空间充足;支持API批量提取,压测脚本和自动化工具可以直接对接,不用人工一个个填。
更实际的建议是:先小批量提取IP,按本文的五步法完整跑一轮压测,用数据验证节点质量,再决定放量上生产环境。稳定性这件事,永远相信实测,不要相信宣传。
常见问题
Q: 动态IP切换时,直播一定会中断吗?
推流是长连接,出口IP变化的瞬间连接必然要重建,所以短暂中断很难完全避免。优化的目标不是追求"零中断",而是把切换控制在低敏感时间窗口内,配合自动重连把影响压缩到观众几乎无感。
Q: 压测跑多久才有参考价值?
单节点建议连续测试2小时以上,并且至少覆盖一个晚高峰时段,多轮测试取平均值。只测十几分钟的数据偶然性太大,容易误判。
Q: 直播卡顿一定是代理IP的问题吗?
不一定。上行带宽不足、编码参数设置过高、推流服务器繁忙都会导致卡顿。正确做法是先直连推流测出基线,再对比走代理后的数据,差距明显才能定位到IP环节。
Q: 动态IP适合哪些直播业务场景?
矩阵多账号运营、多路并发推流、需要定期更换出口环境的国内直播业务都比较合适。需要注意的是,动态IP代理只适用于国内业务场景,涉及海外平台的推流并不适用。
Q: 优化之后还有提升空间吗?
有。把节点测速筛选、会话保持、预切换、自动重连四个环节全部配置到位,再配合常驻的断流监控告警,整体稳定性还能再上一个台阶。建议每次调整后重新跑一轮压测,用数据确认优化效果。