
凡是维护过代理IP池的人都有体会:池子刚建好时很好用,跑上几天成功率就开始下滑,任务频繁超时、失败重试,排查半天才发现,问题出在一批"连不上、跑不动"的失效IP上。这些节点如果不及时清出去,会像慢性病一样拖垮整个池子。所以一个合格的IP池,必须内置一套健康检测与自动清洗机制。这篇文章就把它的底层逻辑彻底拆开讲清楚。
池子里的无效节点是怎么来的?
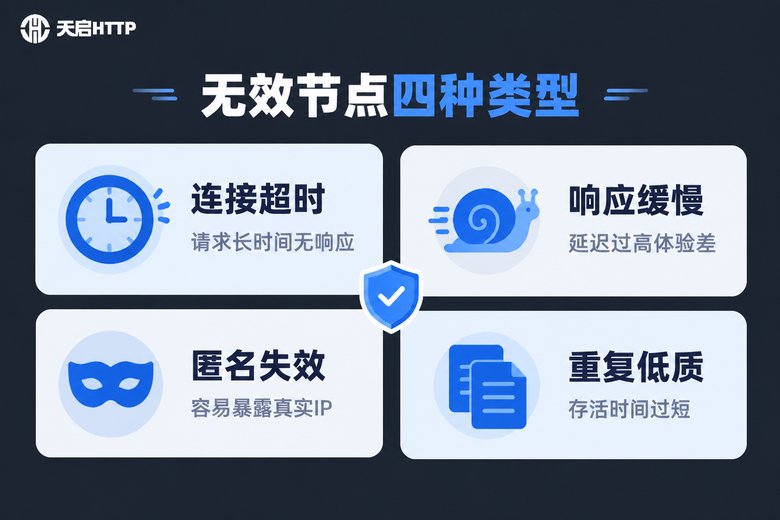
所谓无效节点,就是已经无法正常完成代理任务的IP。它们不是凭空出现的,主要有三个来源:
一是IP本身过期失效。运营商的IP资源是动态分配的,一个IP昨天还在提供服务,今天可能就被回收、重新分配给了别的用户,原来的代理通道自然就断了。
二是节点负载过高。同一个IP被过多任务同时挤占,服务器响应越来越慢,甚至直接拒绝新的连接,表现就是超时和批量失败。
三是匿名能力下降。有些IP虽然"能连上",但请求头里开始泄露真实IP信息,或者已被目标网站识别并限制,这类节点属于"半失效",同样需要被检测出来。
健康检测到底检测什么?
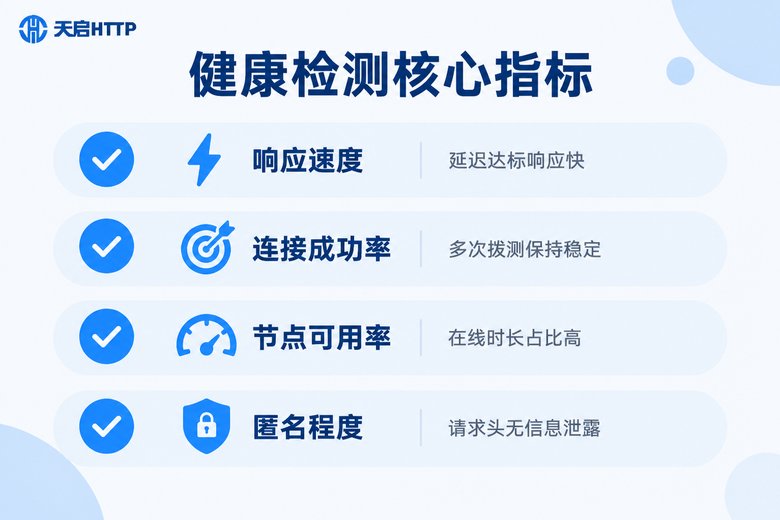
判断一个节点是否健康,不能只看"能不能连上",而是要看一组综合指标。主流的检测机制通常关注以下几项:
| 检测指标 | 具体含义 | 常见合格参考 |
|---|---|---|
| 响应速度 | 发起请求到收到响应的耗时 | 1~3 秒以内 |
| 连接成功率 | 多次拨测中成功次数的占比 | 90% 以上 |
| 可用率 | 节点在线时长占总时长的比例 | 95% 以上 |
| 匿名程度 | 是否泄露真实IP等敏感信息 | 高匿名优先 |
其中响应速度和连接成功率是硬门槛:响应太慢会拖垮任务效率,成功率不稳定会让重试成本飙升。还要注意一点,单次拨测通过并不代表节点稳定,生产级的检测机制会对每个节点做周期性多次拨测,用历史数据计算成功率,避免被偶然结果误导。
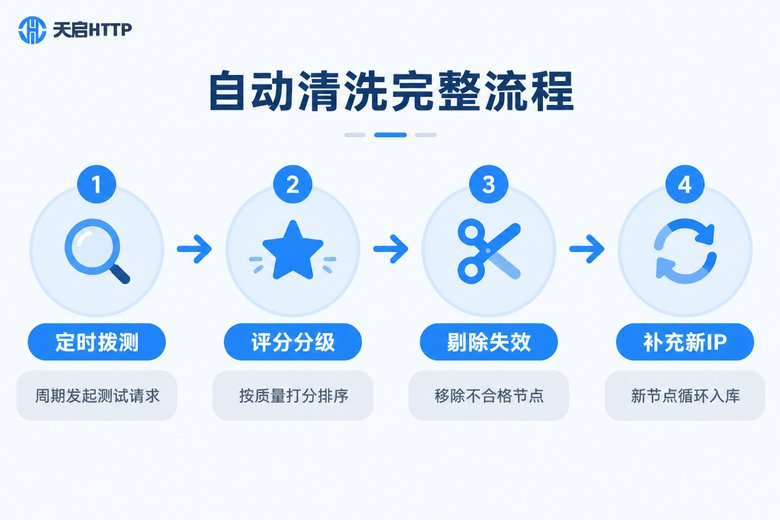
自动清洗的完整工作流程
一套成熟的清洗机制,本质上是一个"检测—评分—剔除—补充"的循环,周而复始地让池子保持新鲜:
第一步:定时拨测。系统按设定的间隔,对池内节点逐一发起真实测试请求,记录每个节点是否响应、耗时多少。
第二步:评分分级。根据响应速度、成功率、在线时长等指标给节点打分,划分成优质、一般、待观察几个等级,优质节点优先分配给核心任务。
第三步:剔除失效。连续多次不达标、或者直接失联的节点,被移出可用池,进入待复测或淘汰队列。
第四步:补充新IP。剔除之后池子出现缺口,系统自动补充新节点入库,保证池子总量动态平衡,不会越用越少。
如果想亲手验证节点质量,用几行代码就能实现最基础的拨测逻辑:
import requests
import time

def check_node(ip, port, timeout=3):
    """拨测单个节点:返回是否存活、响应耗时多少毫秒"""
    proxies = {
        "http": f"http://{ip}:{port}",
        "https": f"http://{ip}:{port}",
    }
    start = time.time()
    try:
        resp = requests.get("https://你的目标网址",
                            proxies=proxies, timeout=timeout)
        delay = round((time.time() - start) * 1000)
        return resp.status_code == 200, delay
    except Exception:
        return False, 9999

def clean_pool(nodes):
    """清洗:拨测失败或响应超时的节点直接剔除"""
    alive = []
    for ip, port in nodes:
        ok, delay = check_node(ip, port)
        if ok and delay < 3000:  # 3秒内响应才算健康
            alive.append((ip, port))
    print(f"清洗完成:保留 {len(alive)} / {len(nodes)} 个节点")
    return alive
这段脚本做的事和池子的底层逻辑一样:发起请求、记录耗时、剔除失败节点。区别在于生产级的IP池会把每次拨测结果持久化存储,结合历史表现做评分和趋势判断,而不是"一次失败就判死刑"。
检测频率和策略怎么定更合理?
清洗机制并不是越勤快越好。拨测太频繁,会浪费请求资源,还可能因为检测流量本身引起注意;拨测太稀疏,坏节点又会长时间占据池子。可以参考下面的思路来平衡:
| 业务类型 | 建议拨测间隔 | 补充策略 |
|---|---|---|
| 高实时性任务 | 30秒~1分钟 | 失败立即补位 |
| 常规数据采集 | 5~10分钟 | 按小时批量补充 |
| 长期挂机任务 | 每次使用前验证 | 失败自动切换 |
另外还有两个实用技巧:一是"多次确认"再剔除,单次失败可能只是网络抖动,连续2~3次失败再移除,能大幅降低误杀率;二是给被剔除的节点设置"冷却期",不要马上丢弃,放一段时间后复测,不少节点会"复活",这样能提高IP资源的整体利用率。
自己搭池子,还是直接用成熟服务?
看完原理你会发现,清洗机制本身并不神秘,真正难的是另一件事:IP来源。池子把坏节点剔掉之后,上哪去找持续、稳定的新IP来补充?这背后需要长期的资源和运维投入,对中小团队来说门槛不低。
所以对大多数业务来说,直接使用成熟的代理服务是性价比更高的选择。以天启HTTP为例,作为国内代理IP服务商,它的IP池由专业系统统一维护,节点经过自动质检与实时清洗,失效IP会被及时剔除更新,用户通过API提取到的IP可用性更有保障。如果你的业务对IP质量要求高,又不想自己花精力养池子,可以先小批量提取测试,用真实的成功率数据来做判断。
常见问题
Q: 无效节点清理掉之后,池子会不会越用越小?
不会。健康的清洗机制都是"边剔除边补充"的,移除失效节点的同时会自动引入新IP,池子总量保持动态平衡。真正需要关注的是补充IP的质量和速度,而不是数量缩水。
Q: 为什么有的节点明明能连上,还是被判为无效?
因为"能连上"只是最低标准。如果响应过慢、频繁超时,或者请求时泄露了真实IP信息,即使连接成功也无法胜任实际业务,这类"半失效"节点同样会被检测机制标记并处理。
Q: 拨测会不会消耗节点本身的使用额度?
会消耗少量请求,但正规做法是用轻量级请求做检测,单次开销极小。相比让坏节点混在池子里拖垮整个任务的成功率,这点检测成本完全值得。
Q: 怎么判断一个代理服务商的池子清洗做得好不好?
最直接的办法是实测:提取一批IP,统计实际成功率和响应速度;隔一段时间再测同一批,观察可用率的衰减速度。衰减慢、成功率稳定,说明池子的质检清洗机制到位,例如天启HTTP这类有自动质检体系的服务商,表现通常会更稳定。