
做爬虫的人都会撞上两面墙:一面是频率限制——目标站点盯紧单一IP,请求稍微密集就返回验证码甚至直接封禁;另一面是并发瓶颈——任务量一上来,成百上千个请求同时发出,默认配置的代理和客户端根本撑不住。SOCKS5代理正是破解这两面墙的常用钥匙:它工作在会话层、不挑应用协议,配合Python成熟的异步生态,能把每一个代理IP的价值压榨到极致。这篇教程分两条线走:先把SOCKS5代理在Python里正确跑通,再做系统性的并发优化。
为什么爬虫场景偏爱SOCKS5代理
很多初学者分不清SOCKS5和HTTP代理的差别,先说结论:HTTP代理只代理HTTP/HTTPS请求,SOCKS5几乎什么流量都能转发。SOCKS5工作在会话层,只负责原样转发数据包,不解析、不修改应用层内容,协议兼容性远好于HTTP代理。落到爬虫场景,这带来三个实际好处:
第一,远程DNS解析。使用socks5h协议头时,域名解析交给代理端完成,避免本地DNS污染或解析结果与出口IP不匹配的问题。第二,更低的协议开销,不需要维护HTTP头部的改写逻辑,长连接场景下表现更稳。第三,认证灵活,既支持账号密码,也支持IP白名单,方便在服务器上无人值守运行。
| 对比维度 | SOCKS5代理 | HTTP代理 |
|---|---|---|
| 工作层级 | 会话层,转发原始流量 | 应用层,解析HTTP报文 |
| 协议兼容 | TCP/UDP通用 | 仅HTTP/HTTPS |
| DNS解析 | 可由代理端远程完成 | 本地解析 |
| 典型开销 | 更低 | 略高 |
| 爬虫适用度 | 通用性强 | 纯Web采集够用 |
第一步:在Python中跑通SOCKS5代理
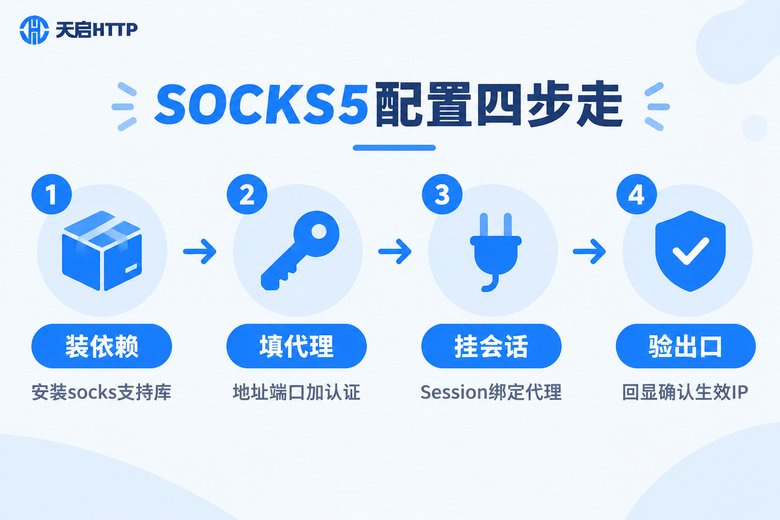
最常用的requests库本身不直接支持SOCKS5,需要先补装一个依赖:
pip install requests[socks]
# 等价于单独安装
pip install requests pysocks
然后像配置HTTP代理一样,把SOCKS5地址写进proxies字典即可:
import requests

proxy_url = "socks5://用户名:密码@代理服务器地址:端口"

proxies = {
    "http": proxy_url,
    "https": proxy_url,
}

resp = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=10)
print(resp.json()) # origin应当显示代理出口IP,而不是本机IP一个容易踩的坑:socks5和socks5h的区别。socks5表示先在本地解析域名、再通过代理连接;socks5h则把域名解析也交给代理端完成。采集时如果遇到解析异常,或想彻底规避DNS层面的干扰,把协议头换成socks5h往往能直接解决问题:
# h = hostname由代理端远程解析
proxy_url = "socks5h://用户名:密码@代理服务器地址:端口"
跑通之后先别急着加并发,用上面的回显接口确认出口IP确实变了再往下走,否则并发越高、错得越快。
第二步:Session连接池,为并发打底
默认情况下,requests每次请求都可能新建连接,高并发下反复握手会吃掉大量时间。正确姿势是用Session挂载代理,并主动调大连接池:
import requests
from requests.adapters import HTTPAdapter

session = requests.Session()

adapter = HTTPAdapter(
    pool_connections=20,   # 连接池数量
    pool_maxsize=100,      # 单个连接池最大连接数
    max_retries=3          # 内置重试
)
session.mount("http://", adapter)
session.mount("https://", adapter)

session.proxies = {
    "http": "socks5://用户名:密码@代理服务器地址:端口",
    "https": "socks5://用户名:密码@代理服务器地址:端口",
}

resp = session.get("https://目标站点.com", timeout=(5, 10))
print(resp.status_code)连接池的意义在于复用已建立的SOCKS5隧道:同一个代理IP连续请求同一批页面时,省掉反复握手的成本,吞吐量能提升一大截。timeout建议拆成连接超时和读取超时两个值,避免个别慢节点把整个任务拖死。
第三步:异步并发,把吞吐量拉满
多线程方案(如concurrent.futures的ThreadPoolExecutor)配置简单,20到50个线程就能应付中小规模采集,但线程切换的开销决定了它撑不起海量并发。大规模场景的标准答案是asyncio加aiohttp,单线程即可维持成百上千个并发连接:
pip install aiohttp aiohttp-socksimport asyncio
import aiohttp
from aiohttp_socks import ProxyConnector
PROXY_URL = "socks5://用户名:密码@代理服务器地址:端口"
async def fetch(session, url):
try:
async with session.get(url, timeout=aiohttp.ClientTimeout(total=10)) as resp:
return url, resp.status
except Exception as e:
return url, repr(e)
async def main():
connector = ProxyConnector.from_url(PROXY_URL, limit=100) # limit限制总连接数
async with aiohttp.ClientSession(connector=connector) as session:
urls = [f"https://目标站点.com/page/{i}" for i in range(200)]
results = await asyncio.gather(*(fetch(session, u) for u in urls))
ok = sum(1 for _, s in results if s == 200)
print(f"成功 {ok}/{len(results)}")
asyncio.run(main())几种主流并发方案的取舍,可以参考下表:
| 方案 | 并发模型 | 适合规模 | 特点 |
|---|---|---|---|
| requests + 线程池 | 多线程 | 几百到几千页 | 上手最快,调试简单 |
| Session + 连接池 | 长连接复用 | 配合任意方案 | 显著降低握手开销 |
| aiohttp + asyncio | 单线程异步IO | 十万级以上 | 吞吐最高,需异步生态 |
| httpx 异步客户端 | 异步IO | 中大规模 | API接近requests,支持HTTP/2 |
无论选哪种方案,都要给并发加上限速和随机延迟。并发高不等于可以无限快,把节奏控制在目标站点可接受的范围内,才能长时间稳定运行:
import asyncio
import random

async def polite_fetch(session, url):
    await asyncio.sleep(random.uniform(0.3, 1.2))  # 随机延迟,模拟正常访问节奏
    return await fetch(session, url)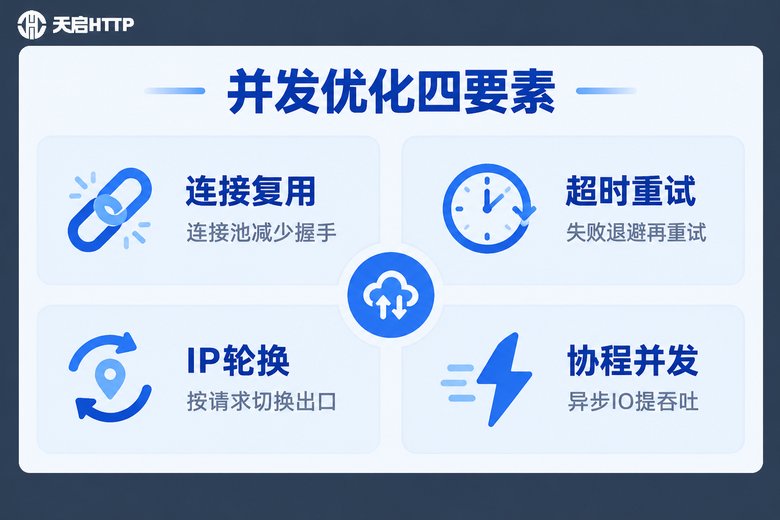
第四步:重试、轮换与失败兜底
真实采集环境里,代理IP会失效、目标站点会抖动,稳定性靠的是兜底逻辑,而不是单次成功。三个必备机制如下。
一是指数退避重试。失败后不要立刻原样重发,按1秒、2秒、4秒逐步拉长间隔,给对方喘息时间:
import time
import requests

def fetch_with_retry(url, proxies, max_retries=3):
    for attempt in range(max_retries):
        try:
            resp = requests.get(url, proxies=proxies, timeout=(5, 10))
            if resp.status_code == 200:
                return resp
        except requests.RequestException:
            pass
        time.sleep(2 ** attempt)  # 1s、2s、4s指数退避
return None二是代理池轮换。把提取到的多个SOCKS5代理放进队列,每个请求取下一个,失败就换IP重试,把压力摊到整个池子上:
from itertools import cycle

proxy_pool = cycle([
    "socks5://用户名:密码@ip1:端口",
    "socks5://用户名:密码@ip2:端口",
    "socks5://用户名:密码@ip3:端口",
])

def next_proxy():
return {"http": next(proxy_pool), "https": next(proxy_pool)}三是失效剔除。定时用轻量请求探测池内IP的可用性,连续失败的节点直接移除并补充新IP,保证池子里永远是"活水"。
代理IP从哪来:天启HTTP的接入方式
自建代理池维护成本高,大多数团队会直接采购代理服务。天启HTTP是国内IP代理服务商,支持HTTP、HTTPS、SOCKS5等协议,IP覆盖国内多个城市,可通过API批量提取代理,直接对接上面代码里的代理池结构。实际接入只需三步:在后台生成SOCKS5提取链接、定时调用接口刷新IP列表、把返回的IP按"地址:端口:用户名:密码"的格式塞进代理池轮换使用。
需要提醒的是,天启HTTP提供的是国内IP资源,适合目标站点在国内的采集、监控、数据对接等场景;如果你的采集目标全在境外,它并不适用,选型时要先确认自己的业务范围。另外,并发量大的项目建议重点关注服务商的IP可用率和提取频率限制,这两项直接决定代理池的补水速度能不能跟上消耗速度。
常见问题
Q: 配置了SOCKS5代理,为什么请求还是走的本机IP?
按顺序排查:是否安装了PySocks依赖;proxies字典是否真的传进了请求方法;用Session时是否设置的是session.proxies而不是局部变量;协议头拼写是否正确。最后用httpbin.org/ip这类回显接口验证出口IP,一眼就能定位问题。
Q: SOCKS5代理频繁连接超时怎么办?
先区分是代理问题还是目标站点问题:换一个回显接口测试代理本身是否可用。代理可用则检查认证信息和IP白名单设置;代理不可用说明节点已失效,需要更换IP或联系服务商处理。代码层面务必设置连接和读取双重超时,并配上重试逻辑。
Q: 并发数开到多少合适?
没有标准答案,取决于目标站点的承受能力和代理质量。建议从20到50并发起步,观察成功率和平均响应时间,逐步上调直到指标开始恶化。同时配合随机延迟和IP轮换,避免把请求压力集中到单一IP上。
Q: 天启HTTP支持SOCKS5协议吗?
支持。天启HTTP提供HTTP、HTTPS、SOCKS5等协议的代理服务,IP覆盖国内多个城市,可通过API批量提取并对接代理池。注意其资源为国内IP,境外采集场景不适用。
Q: aiohttp-socks支持socks5h吗?
支持。ProxyConnector.from_url可以直接解析socks5h://开头的地址,远程DNS解析的行为与requests中一致,需要规避本地DNS干扰时同样推荐使用。