
一、什么是隧道代理?先搞懂它的工作原理
很多刚做爬虫的朋友都有过这样的经历:脚本写好了,跑了几分钟就收到目标网站的访问限制提示,于是只能手动去换IP,改完再跑、跑完再换,效率低得让人崩溃。
隧道代理就是为了解决这个问题而生的。简单来说,它会提供一个固定的代理入口(隧道地址),你所有的请求都发往这个入口,至于背后实际用哪个IP去访问目标网站,完全由隧道代理服务端自动完成轮换。
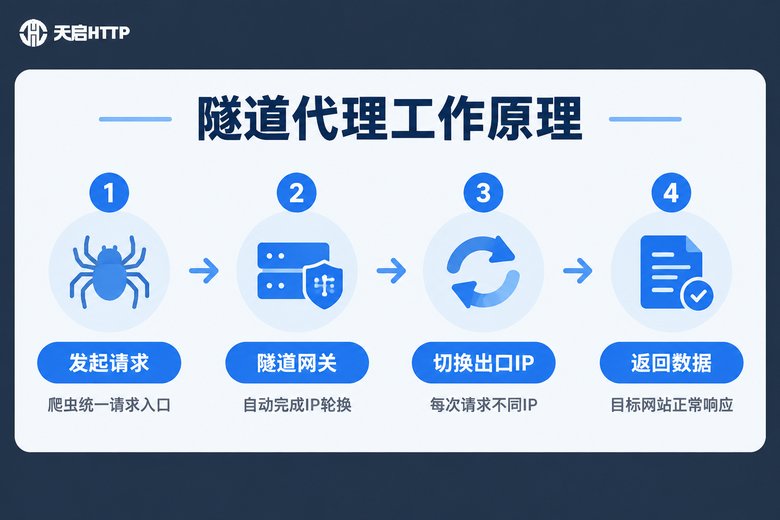
整个过程可以概括为四步:
1. 爬虫把请求统一发到隧道网关;
2. 隧道网关从IP资源中自动选出一个可用IP;
3. 用这个IP去访问目标网站;
4. 拿到数据后原路返回给你。
对写代码的人来说,你几乎感知不到IP切换的存在,就像请求"自动长了腿",每次出去都是一张新面孔。
二、隧道代理在爬虫中的四大核心优势
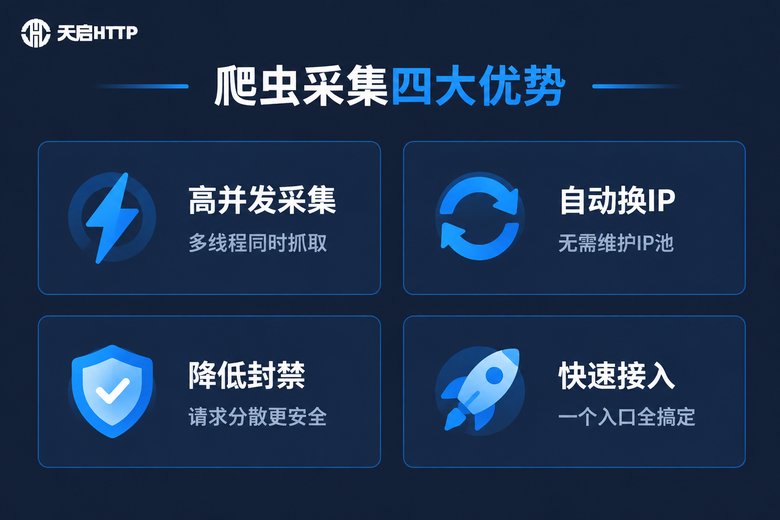
1. 免去维护IP池的麻烦
传统做法需要自己调API提取IP、验证可用性、剔除失效IP,还要写存储和调度逻辑,一套流程下来代码量不小。隧道代理把这些全部封装在服务端,你只需要一个入口地址。
2. 天然适配高并发
爬虫讲究速度,多线程、多进程甚至分布式采集是常态。隧道代理在网关层自动分流,每个请求都能拿到不同的出口IP,并发越高优势越明显。
3. 有效降低封禁风险
同一个IP高频访问同一个网站,很容易触发风控。隧道代理让请求IP持续变化,把访问压力分散开,目标网站更难把你列入限制名单。
4. 接入成本极低
不需要改爬虫架构,只要在请求里加上代理配置,几分钟就能让老脚本用上隧道代理,改造成本几乎为零。
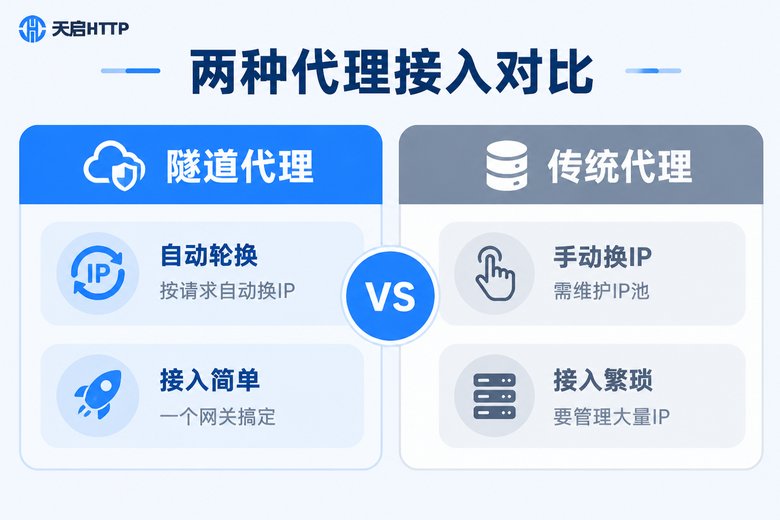
三、隧道代理 VS 传统代理IP:一张表看懂区别
为了更直观,我们把隧道代理和传统的"API提取+手动切换"模式做个对比:
| 对比项 | 隧道代理 | 传统代理IP |
|---|---|---|
| IP轮换方式 | 每次请求自动切换 | 手动提取、手动更新 |
| 接入方式 | 一个固定网关入口 | 需管理大量离散IP |
| 开发工作量 | 加几行配置即可 | 需自建IP池调度模块 |
| 并发友好度 | 网关层自动分流 | 需自行处理IP分配 |
| 适合场景 | 中大型、高并发爬虫 | 小规模、需精细控IP的任务 |
一句话总结:如果你不想把精力浪费在"管IP"上,而是想把时间花在解析数据、优化业务逻辑上,隧道代理是更省心的选择。
四、配置教程:Python爬虫接入隧道代理(完整版)
下面以最常用的 Python + requests 为例,演示如何接入天启HTTP的隧道代理。
第一步:获取隧道信息
注册并登录天启HTTP官网,进入控制台找到隧道代理产品,创建一条隧道,你会得到三样东西:隧道地址、端口、认证信息(用户名和密码)。
第二步:基础接入示例
import requests

# 替换为你在天启HTTP控制台获取的隧道信息
tunnel = "http://用户名:密码@隧道地址:端口"

proxies = {
    "http": tunnel,
    "https": tunnel,
}

url = "https://目标网站.com/list?page=1"
resp = requests.get(url, proxies=proxies, timeout=10)
print(resp.status_code)
print(resp.text[:200])
就这么简单——传统代理还要先调API拿IP列表再逐个拼接验证,隧道代理一步到位。每次请求经过隧道网关,出口IP都会自动更换。
第三步:加上超时与重试,让爬虫更健壮
import time
import requests

tunnel = "http://用户名:密码@隧道地址:端口"
proxies = {"http": tunnel, "https": tunnel}

def fetch(url, max_retry=3):
    for i in range(max_retry):
        try:
            resp = requests.get(url, proxies=proxies, timeout=10)
            if resp.status_code == 200:
                return resp
        except requests.RequestException:
            pass
        time.sleep(1)  # 稍等片刻后重试
    return None
第四步:多线程并发采集
import requests
from concurrent.futures import ThreadPoolExecutor

tunnel = "http://用户名:密码@隧道地址:端口"
proxies = {"http": tunnel, "https": tunnel}

def fetch(url):
    try:
        resp = requests.get(url, proxies=proxies, timeout=10)
        return url, resp.status_code
    except requests.RequestException as e:
        return url, str(e)

urls = [f"https://目标网站.com/detail/{i}" for i in range(50)]

with ThreadPoolExecutor(max_workers=10) as pool:
    for url, status in pool.map(fetch, urls):
        print(url, status)
把 max_workers 调整到你需要的并发数即可。由于隧道代理在网关层自动分配出口IP,你完全不需要在代码里写任何IP管理逻辑。
五、进阶技巧与注意事项
1. 控制好请求频率
隧道代理解决了"IP单一"的问题,但不代表可以无限制猛刷。合理设置请求间隔、避开目标网站的高峰时段,是长期稳定采集的基本功。
2. 遵守爬取规则与法律法规
只采集公开、合法的数据,尊重目标网站的robots协议,不要将代理用于任何违规用途。
3. 做好异常兜底
网络请求没有100%成功,务必加上超时、重试和日志记录,出问题时才能快速定位原因。
4. 注意场景匹配
天启HTTP是国内IP代理服务商,IP资源面向国内业务场景。如果你的目标网站在国内,隧道代理会是非常顺手的工具;如果是需要海外IP的场景,则不适用。
常见问题
Q: 隧道代理和普通代理IP到底有什么区别?
最大的区别在于"谁来换IP"。普通代理需要你自己提取、验证、切换IP;隧道代理把这一切放在云端网关完成,你只面对一个固定入口,每次请求自动换IP。
Q: 隧道代理适合什么规模的爬虫项目?
从小脚本到分布式采集都适用。尤其是请求量大、并发高、不想维护IP池的项目,隧道代理的优势最为明显。
Q: 接入隧道代理需要改多少代码?
通常只需要在请求库的代理配置里填入隧道地址和认证信息,几行代码就能完成,原有爬虫架构不用动。
Q: 天启HTTP的隧道代理支持哪些编程语言?
只要是支持HTTP代理协议的语言都可以使用,比如Python、Java、Go、PHP等,配置思路基本一致:把代理指向隧道地址即可。
Q: 可以用它采集国外网站吗?
天启HTTP是国内IP代理服务商,提供的是国内IP资源,适合采集国内业务场景的目标网站;需要海外IP的场景不适用。