
代理IP池为什么必须持续维护
做过爬虫的人都有一个共识:代理IP池不是“建好就完事”的一次性工程,而是一个需要天天打理的活系统。IP是典型的消耗型资源——有的IP用着用着就被目标网站封禁了,有的节点临时维护直接失联,还有的随着时间推移响应越来越慢。如果把IP池比作一个鱼塘,无效IP就是塘里的死鱼,不及时捞出来,不仅占地方,还会污染整池水。
更麻烦的是,无效IP对采集任务的伤害是隐蔽而持续的。调度器随机分到一个已失效的IP,请求超时、重试、再超时,表面上程序还在跑,实际吞吐量已经大幅下滑;更糟的情况是拿到一个“半死不活”的IP,请求能通但匿名度下降,目标网站一眼识别出爬虫特征,直接触发封禁策略,连累整个采集任务。
所以,一个成熟的IP池必须具备“自我净化”能力:持续检测、动态评分、自动剔除、及时补充,四个环节缺一不可。本文围绕其中最核心的“自动剔除无效IP”,把策略一层层拆开讲透。
无效IP的四个典型信号
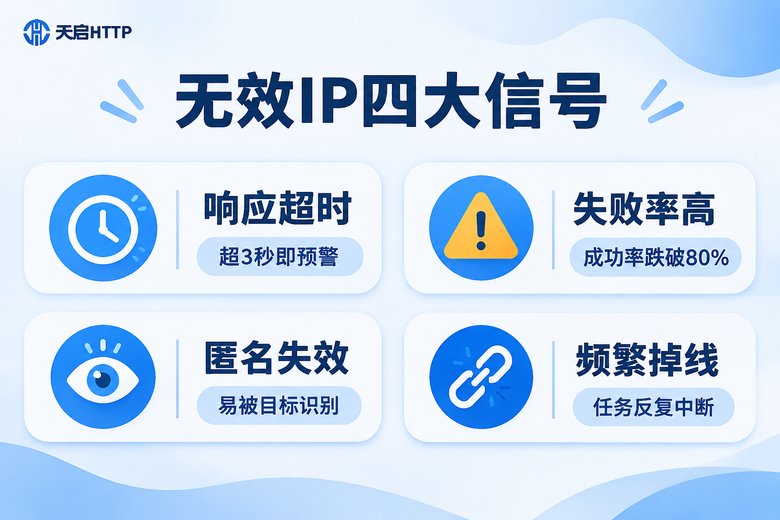
要自动剔除,先得定义什么叫“无效”。实践中,无效IP很少是彻底断连那种“一眼假”,更多表现为以下四种慢性病:
1. 响应超时。正常IP的响应时间通常在1秒以内,如果一个IP连续多次响应超过3秒,说明它要么线路拥堵,要么节点过载,继续留在池子里只会拖慢整体任务节奏。
2. 失败率飙升。单次失败可能只是网络抖动,但如果一个IP最近20次请求里失败超过4次(成功率低于80%),基本可以判定它已经被目标站点重点关照,继续硬冲只会浪费请求配额。
3. 匿名度下降。有些IP起初匿名表现很好,用一段时间后目标网站能通过请求头特征识别出代理身份。这类IP最危险——请求能成功,拿到的却可能是反爬页面或被污染的数据。
4. 连接不稳定。时通时断、频繁掉线的IP,会让重试机制反复触发,消耗大量调度资源,性价比极低。
这四个信号就是后续打分体系的输入项:信号越多、越严重,IP的健康分越低,离被剔除就越近。
自动剔除策略详解:五步闭环
自动剔除不是简单的“失败就删”,而是一套环环相扣的流程。完整的闭环分为五步:
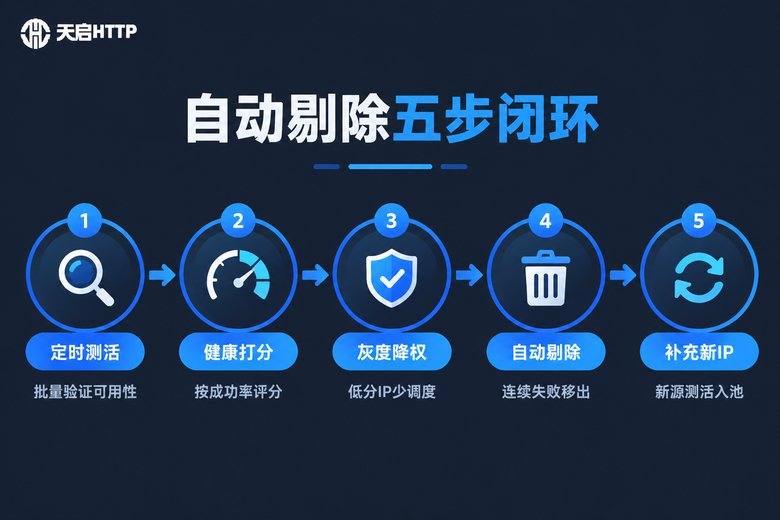
第一步:定时测活。每隔固定周期(比如5分钟)对池内IP做一轮批量验证,用轻量请求探测连通性和响应速度,记录成败结果。测活请求要足够轻量,避免和业务请求抢资源。
第二步:健康打分。给每个IP维护一个动态分数,初始100分。请求成功且响应快就加分,响应慢小扣,失败大扣。这个分数就是IP的“体检报告”,后续所有去留决策都以它为准。
第三步:灰度降权。分数下降但还没到淘汰线的IP,不要一棍子打死,而是降低它的被调度权重——少用它、关键任务不用它。这样既不浪费还有价值的IP,也控制住了风险敞口。
第四步:自动剔除。设置明确的硬性红线:连续失败3次,或健康分跌破40分,直接移出可用队列。剔除动作要干脆利落,同时记录剔除原因,方便事后回溯分析是IP质量问题还是目标站策略变化。
第五步:补充新IP。剔除腾出的容量要第一时间补上,否则池子会越用越小。通过API从服务商批量提取新IP,经过一轮准入测活后入池,形成“淘汰—补充”的良性循环。
四种剔除策略对比,怎么选
除了上面这套组合拳,常见的剔除策略还有几种,各有侧重:
| 策略 | 核心逻辑 | 优点 | 局限 | 适合场景 |
|---|---|---|---|---|
| 定时测活 | 周期性全量验证 | 实现简单、结果直观 | 测活本身消耗资源 | 小规模池 |
| 失败计数 | 连续失败N次即剔除 | 误杀率低、逻辑清晰 | 反应速度偏慢 | 通用型业务 |
| 健康评分 | 多维度动态打分 | 精细平滑、可调性强 | 参数需要调优 | 中大型池 |
| 灰度降权 | 低分IP减少调度 | 榨干剩余价值 | 需配合调度器 | 高成本IP池 |
实际生产中,这几种策略通常组合使用:测活打底、评分量化、灰度缓冲、硬线剔除。单一策略要么太粗放,要么太迟钝,组合起来才能兼顾准确性和响应速度。
代码实战:最小可用的IP池维护脚本
思路讲完了,下面用Python写一个最小可用的维护脚本,实现“测活—打分—剔除”的核心闭环:
import requests
import time

# IP池结构:{ip: {"score": 健康分, "fail": 连续失败次数}}
ip_pool = {}

def check_ip(ip, timeout=3):
    """测活:返回 (是否可用, 响应耗时)"""
    proxies = {"http": f"http://{ip}", "https": f"http://{ip}"}
    try:
        start = time.time()
        resp = requests.get("https://httpbin.org/get",
                            proxies=proxies, timeout=timeout)
        return resp.status_code == 200, time.time() - start
    except Exception:
        return False, timeout

def maintain():
    """一轮维护:测活 → 打分 → 剔除"""
    for ip in list(ip_pool):
        ok, cost = check_ip(ip)
        node = ip_pool[ip]
        if ok and cost < 1:
            node["score"] = min(100, node["score"] + 5)  # 快速成功,加分
            node["fail"] = 0
        elif ok:
            node["score"] -= 2                            # 能通但慢,小扣
        else:
            node["fail"] += 1
            node["score"] -= 20                           # 失败,大扣
        # 硬性红线:连续失败3次或分数跌破40,直接剔除
        if node["fail"] >= 3 or node["score"] < 40:
            print(f"[剔除] {ip} score={node['score']} fail={node['fail']}")
            ip_pool.pop(ip)

if __name__ == "__main__":
    # 演示:每5分钟跑一轮维护
    while True:
        maintain()
        time.sleep(300)
这个脚本只有几十行,但五脏俱全。放到生产环境,还可以继续升级:用线程池或异步并发测活提升效率、把剔除原因落库便于分析、与调度器联动实现灰度降权、剔除的IP进入观察区定期复检等。核心原则不变:让每一轮维护都留下数据痕迹,让每一次剔除都有据可查。
选对IP来源,维护事半功倍
策略再精细,如果IP本身“先天不足”,维护成本也会居高不下。免费渠道拿到的IP可用率往往只有个位数百分比,剔除速度根本赶不上失效速度,池子永远处于“缺血”状态。这也是为什么正经做采集的团队,都会选择付费代理服务作为IP来源。
以天启HTTP为例,它是国内IP代理服务商,支持HTTP/HTTPS/SOCKS5多协议,IP资源覆盖国内多省市,可通过API批量提取,配合较高的IP可用率,能从源头上减少无效IP的产生。接入方式也简单:API提取之后,按上面的准入测活流程过一遍,健康的直接入池。这样维护策略负责“淘汰”,高质量来源负责“补充”,一推一拉,池子就能长期保持活力。需要说明的是,天启HTTP聚焦国内IP资源,适合目标网站在国内的采集业务场景。
常见问题
Q: IP池多久维护一次比较合适?
测活周期建议5~15分钟。周期太短,测活请求本身会占用不少资源;太长,失效IP会在池里滞留,持续拖累任务。业务高峰期可以适当加密检测频率,低峰期放宽。
Q: 被剔除的IP还能回收再利用吗?
可以。剔除不等于永久拉黑,建议把剔除的IP放进“观察区”,隔一段时间(比如1小时)重新测活,恢复健康的可以降权放回池子;确认彻底失效的,再移入黑名单。
Q: 池子规模变大后,剔除策略需要调整吗?
需要。池子超过几千个IP后,全量轮询测活的开销会很大,建议改成“抽样检测+按需验证”的组合:调度时优先使用近期验证过的高分IP,长期没被用到的IP在真正被分配时再做单次验证。
Q: 用了付费代理服务,还需要自己维护IP池吗?
需要,但负担会小很多。服务商保证的是IP的出厂质量,而IP在池里的实时状态——是否被目标封禁、响应快慢——只有自己的维护体系才知道。像天启HTTP这类高可用率的服务能把剔除频率压到很低,但“测活—打分—剔除—补充”的闭环仍然值得保留,这是池子长期稳定的保险丝。