
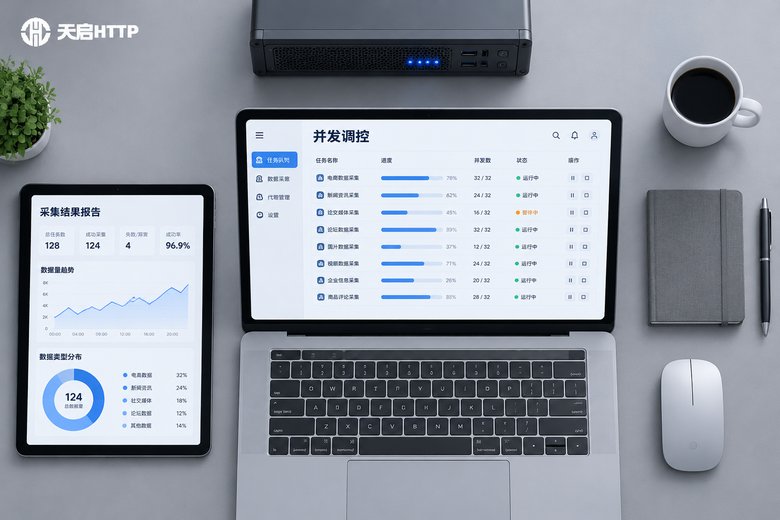
做采集的人几乎都遇到过同一个怪圈:任务跑得慢,把并发从100拉到500,本以为效率翻五倍,结果不是代理池被瞬间榨干,就是目标站直接限流,成功率高台跳水,最后反而比原来更慢。到了2026年,主流站点的风控越做越细,"无脑堆并发"这条路基本走不通了。并发数的本质不是"越大越好",而是一道匹配题——你的代理承载量,和目标站的限流阈值,中间要找到一个双方都能接受的平衡点。这篇文章就把这笔账算清楚。
先搞懂:并发数到底被什么卡住
并发数,指同一时刻正在"飞行中"的请求数量。它看起来是你自己设的参数,实际上由三股力量共同决定:
第一股力量:代理承载量。你的IP池里当下有多少个可用IP、每个IP能扛多大的请求频率、单IP带宽够不够,这决定了供给端的上限。200个可用IP和2000个可用IP,能支撑的并发完全不是一个量级。
第二股力量:目标站限流。绝大多数站点会对单IP请求频率设红线,同一IP每秒超过某个次数,就可能触发限流、弹验证码甚至临时封禁。这是需求端的天花板,而且它通常不写在文档里,只能靠压测摸出来。
第三股力量:任务自身特性。单个请求平均耗时多久、失败重试率多高,决定了每个"并发位"被占用的时间。请求越慢、重试越多,同样并发数下的实际吞吐就越低。
三股力量里最短的那块板,就是你的真实并发上限。调并发之前,先把这三笔账分别算清楚。

算清第一笔账:代理池能扛多少并发
代理侧的承载能力,可以用一个简单公式估算:
理论并发 ≈ 可用IP数 × 单IP安全频率(次/秒) × 单请求平均耗时(秒)
举个例子:你手上有200个可用IP,压测发现单IP每秒1次请求是安全线,单个请求平均耗时2秒,那么理论并发 = 200 × 1 × 2 = 400。也就是最多同时挂400个请求在飞,每个IP身上的压力刚好不越线,此时整体吞吐约200次/秒,正好等于200个IP乘以每秒1次。
套用公式时,有三个容易踩的坑:
一是"可用IP数"不等于"购买量"。短效动态IP存活时间短,任何时刻池子里真正能用的IP都会打折扣,应该统计实时验活之后的存活量,而不是订单上的数字。
二是IP轮换速度要跟得上消耗。并发越高,IP失效和被限的速度越快,如果提取新IP的速度补不上缺口,高并发跑不了几分钟就会"无IP可用"。
三是单IP安全频率因站而异。不同站点的限流策略差别很大,下表只给经验参考区间,具体数值一定要自己压测:
| 任务类型 | 单请求耗时 | 单IP频率参考 | 策略倾向 |
|---|---|---|---|
| 轻量JSON接口 | 0.5秒以内 | 2~5次/秒 | 可以偏激进 |
| 普通网页解析 | 1~3秒 | 1~2次/秒 | 均衡为主 |
| 重页面/大文件 | 5秒以上 | 1次/秒以下 | 必须保守 |
算清第二笔账:目标站的限流红线在哪
目标站的限流规则通常不公开,但可以用小样本压测摸出来:固定其他条件,只用50~100个IP,逐级提高单IP请求频率(比如从每秒0.5次开始,每次上浮一档),每一档跑够几百个请求,记录成功率、平均响应时间和验证码出现率。
你会看到一条典型的曲线:频率较低时,成功率稳定在98%以上;越过某个临界点后,成功率开始下滑、响应时间变长、验证码变多。这个拐点的前一档,就是该站点对单IP的安全频率。另外要留意时段差异——很多站点白天高峰期限流更严、晚间放松,压测最好高峰、平峰各测一轮,别拿平峰数据去跑高峰任务。
四步调优法:从保守起步到动态适配
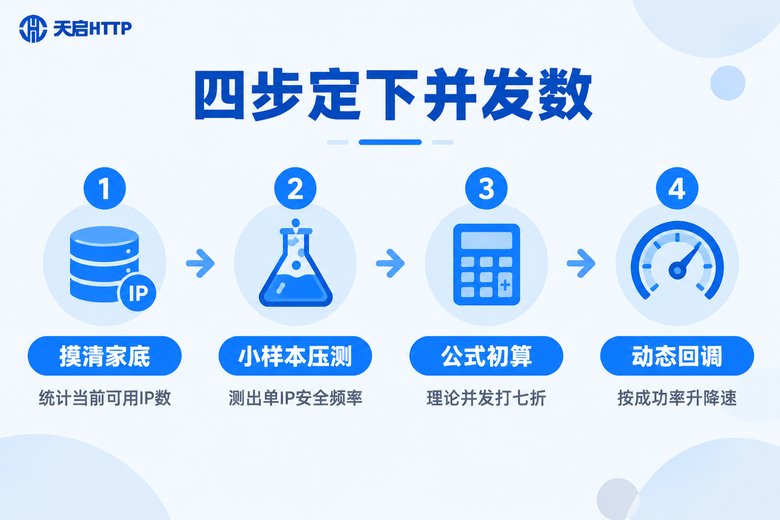
第一步:摸清家底。接入代理服务后先跑一轮IP可用性校验,统计当下真实可用IP数。以天启HTTP为例,通过API提取短效动态IP后,先批量验活再入池,别把失效IP算进承载力。
第二步:小样本压测。按上面的方法测出目标站的单IP安全频率,同时记录单请求平均耗时,这两个数是公式的基本盘。
第三步:公式初算,再打七折。用公式算出理论并发后乘以0.7作为初始值。留出的余量用来吸收波动:IP临时失效、网络抖动、目标站突然收紧策略,都需要缓冲空间。
第四步:动态回调。正式运行时盯住三个指标——成功率、平均响应时间、验证码率。成功率跌破90%就自动降并发,稳定在98%以上再小步上调,让系统自己找到平衡点。示意代码如下:
import asyncio, random

AVAILABLE_IPS = 200        # 实时验活后的可用IP数
SAFE_QPS = 1               # 压测得出的单IP安全频率(次/秒)
AVG_COST = 2.0             # 单请求平均耗时(秒)
CONCURRENCY = int(AVAILABLE_IPS * SAFE_QPS * AVG_COST * 0.7)  # 打7折

sem = asyncio.Semaphore(CONCURRENCY)
results = []               # 滑动窗口:1=成功,0=失败

async def fetch(url, proxy):
    async with sem:                                    # 并发闸门
        try:
            async with session.get(url, proxy=proxy, timeout=10) as resp:
                results.append(1 if resp.status == 200 else 0)
                return await resp.text()
        except Exception:
            results.append(0)
        finally:
            await asyncio.sleep(random.uniform(0.8, 1.5))  # 随机延时打散节奏

async def auto_tune():
    """每30秒按成功率动态升降并发(示意逻辑)"""
    global CONCURRENCY
    while True:
        await asyncio.sleep(30)
        recent = results[-200:]
        if len(recent) < 50:
            continue
        rate = sum(recent) / len(recent)
        if rate < 0.90:
            CONCURRENCY = max(50, CONCURRENCY - 30)    # 跌破90%:降速保成功率
        elif rate > 0.98:
            CONCURRENCY += 20                          # 稳定98%以上:小步试探
        print(f"成功率{rate:.0%},并发调整为{CONCURRENCY}")
这段代码的核心思路是"信号量限并发 + 滑动窗口看成功率 + 阈值触发升降速"。接入实际框架时,把信号量替换成框架支持的动态并发控制即可,判断逻辑不变。
运行中的异常信号与排查对照
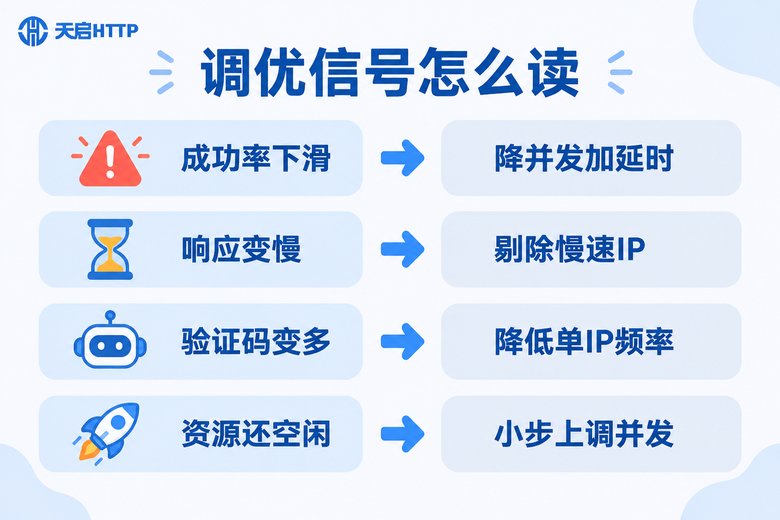
并发调好之后不是一劳永逸,目标站策略会变、代理池质量会波动。出现以下信号时,按对照表处理:
| 现象 | 多半是 | 处理思路 |
|---|---|---|
| 并发一拉高就大面积超时 | 代理带宽或IP质量到顶 | 降并发,剔除高延迟IP |
| 单个IP刚用几次就被限 | 站点阈值比压测时更严 | 降单IP频率,拉大随机延时 |
| 成功率白天低、晚上高 | 站点分时段限流 | 分时段配置不同并发档位 |
| IP消耗速度远超预期 | 失败重试在烧IP | 限制重试次数,失败后退避再试 |
| 并发加到某值后吞吐不涨 | 瓶颈在本地带宽或解析 | 先压测本地环节,别急着加IP |
代理侧怎么选:让承载量不再是短板
并发匹配的上限,最终卡在代理承载量上。选代理服务时,建议按采集场景逐项核对:
看IP池规模和轮换能力。高并发采集需要持续补充新鲜IP。天启HTTP作为国内IP代理服务商,短效动态IP支持API批量提取,配合本地验活机制,可以让IP池在高消耗下始终保持水位。
看匿名质量。高匿名代理不会在请求头里暴露代理特征,能明显降低被目标站识别的概率,同等频率下安全余量更大,压测出来的安全频率也更有参考价值。
看节点覆盖。采集国内站点时,优先选择与目标站用户地域分布接近的国内节点,响应更快、请求特征更自然。需要提醒的是,天启HTTP只提供国内IP,如果你的采集对象是境外站点,它并不适用,选型前要先确认业务范围。
看稳定性和并发承载。先小规模试用,跑真实任务观察高峰时段的超时率和提取接口的响应速度,确认扛得住再放量——这本身就是"小样本压测"思想在选型上的应用。
常见问题
Q: 并发数是不是越高,采集就越快?
不是。超过代理承载量或目标站限流红线后,超时、封禁和重试会吃掉全部收益,吞吐不升反降。正确的目标是找到"成功率不低于95%前提下的最高并发",而不是单纯追求大数字。
Q: 换了代理服务商,并发数要重新调吗?
要。可用IP数量、IP存活时长、单IP质量都变了,理论并发会随之变化,建议重新走一遍"验活统计—小样本压测—公式初算—动态回调"的完整流程。
Q: 目标站没公开限流规则,怎么估安全频率?
用小样本压测:固定其他条件,逐级提高单IP频率,每档跑几百个请求,记录成功率拐点,拐点前一档就是安全频率。高峰和平峰时段各测一轮更稳妥。
Q: 短效IP存活时间短,会拖累并发吗?
会。IP存活越短,高并发下消耗越快,轮换和补充速度必须跟上,否则跑几分钟就无IP可用。解决办法是提高提取频率、把验活做进入池流程,并选IP池规模大的服务商兜底。
Q: 高并发和请求延时怎么平衡?
延时是给目标站风控"看"的。并发越高,越要用随机延时打散请求节奏,避免整批请求呈现整齐的机器特征。宁可单请求慢一点,也别让成功率崩掉——整体吞吐反而更高。