
为什么不能只看后台标注的延迟数字
很多朋友选节点的时候,习惯直接看服务商后台标的“延迟 XXms”,看到数字小就下单了。但那个数字通常是节点在机房理想网络环境下测出来的参考值,和你实际用起来完全是两回事。你的真实延迟,等于本地网络 + 代理节点 + 目标网站三段加在一起,任何一段拖后腿,体感都会变差。
到了 2026 年,业务对延迟的敏感度只会更高:数据采集要拼并发效率、抢购秒杀拼的是毫秒级差距、批量注册和投票任务拼的是成功率。这些场景下,光看标称值做决策,很容易踩坑。正确做法是自己动手实测,而且要同时满足三个维度:多地测、多时段测、用真实业务请求测。下面就把完整流程拆开讲清楚。
先搞懂:一次请求的延迟由哪几段组成
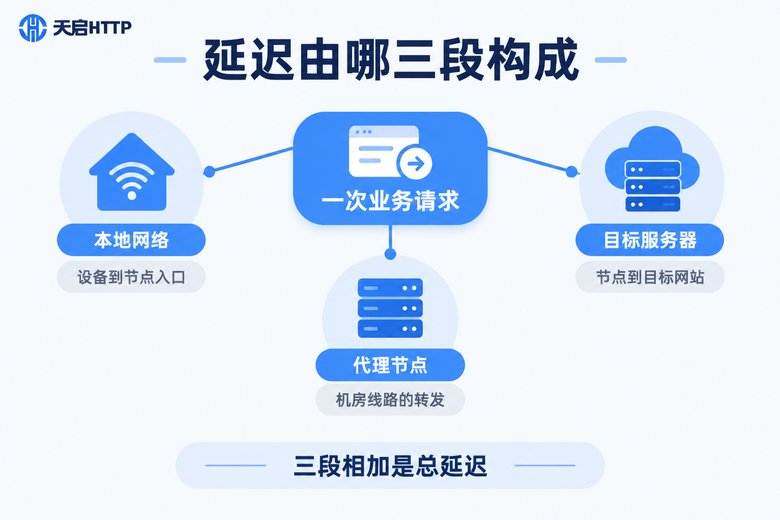
在动手测之前,得先明白延迟是怎么“攒”出来的。一次走代理的业务请求,链路可以拆成三段:
第一段,你的设备到代理节点入口的耗时,主要受你本地宽带质量、运营商跨网影响;第二段,节点在机房内部的线路转发耗时,取决于机房的线路质量和带宽储备;第三段,节点出口到目标网站的耗时,取决于节点和目标站之间的物理距离与路由。
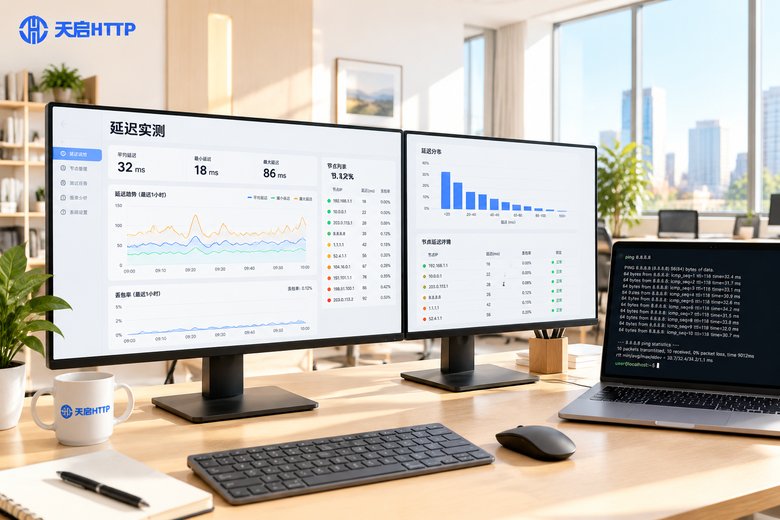
还要注意一个关键区别:ping 走的是 ICMP 协议,业务请求走的是 TCP/HTTP,两者路径相似但不完全等价。ping 只能反映网络层的大致状况,业务的真实速度必须用业务请求本身来验证。这也是为什么本文要分两步走:先用多地 ping 做初筛,再用业务请求做终审。
第一步:多地 ping 实测怎么做
拿到节点 IP 后,先做最基础的 ping 测试。Windows 系统在命令行输入:
:: Windows 下连续 ping 20 次代理节点
ping -n 20 123.45.67.89
macOS 或 Linux 用:
# macOS / Linux 连续 ping 20 次
ping -c 20 123.45.67.89
但单点 ping 意义有限,重点是“多地”。你可以用这几种方式凑齐监测点:找不同城市的同事或朋友帮忙各测一轮;在公司宽带、家庭宽带、手机热点三种网络下分别测;或者用拨测平台的多个城市节点发起测试。监测点尽量覆盖你业务用户和目标服务器所在的主要城市。
每一轮要记录三个指标:平均延迟(整体水平)、抖动(最大值减最小值,反映稳定性)、丢包率(超过 1% 就要警惕)。测试时间点至少覆盖早高峰 8-10 点、晚高峰 20-23 点和凌晨低峰各一轮,因为高峰期的表现才决定业务上限。
另外有个常见误会:有些节点机房会禁 ping,ping 不通不代表节点挂了。这时候改用 tcping 测端口的 TCP 握手速度:
# 测试代理节点端口的 TCP 连通性和握手耗时
tcping 123.45.67.89 8080
第二步:用真实业务请求验证延迟
ping 数据好看,只说明网络层没问题,业务快不快还得看完整链路。最直接的验证工具是 curl,它能拆出每个阶段的耗时:
curl -x http://用户名:密码@代理IP:端口 \
     -o /dev/null -s \
     -w "TCP连接: %{time_connect}s\n首字节: %{time_starttransfer}s\n总耗时: %{time_total}s\n" \
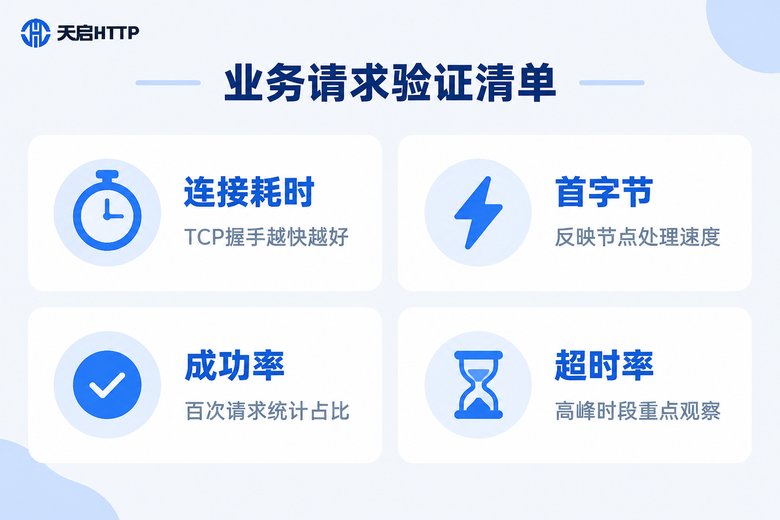
https://www.baidu.com重点看两个数:time_connect(TCP 握手耗时,反映节点响应速度)和 time_starttransfer(首字节耗时,反映节点到目标站的整体链路质量)。
如果要批量验证一个 IP 池,用 Python 脚本跑一轮更高效,还能顺便统计成功率和 P95 耗时:
import time
import requests

# 代理信息替换为自己的
proxy_url = "http://用户名:密码@代理IP:端口"
proxies = {"http": proxy_url, "https": proxy_url}

target = "https://www.baidu.com"
total, success = 30, 0
costs = []

for _ in range(total):
    start = time.time()
    try:
        resp = requests.get(target, proxies=proxies, timeout=10)
        if resp.status_code == 200:
            success += 1
    except Exception:
        pass
    costs.append(round((time.time() - start) * 1000))

avg = sum(costs) / len(costs)
costs.sort()
p95 = costs[int(len(costs) * 0.95) - 1]

print(f"成功率:{success / total * 100:.1f}%")
print(f"平均耗时:{avg:.0f}ms")
print(f"P95耗时:{p95}ms")验证时有三个要点:一是目标地址尽量用真实业务接口或同量级的网站,测出来的数据才有参考价值;二是条件允许就加并发,单线程顺畅不代表高并发下不崩;三是至少跨两三天测,排除偶发的网络波动。
延迟多少算合格?分场景对照着看
测完数据,怎么判断节点能不能用?不同业务的容忍度差别很大,下面这张表给你一个参考基准(以实测数据为准):
| 业务场景 | 平均延迟参考 | 更需要盯的指标 |
|---|---|---|
| 数据采集 / 批量请求 | 100ms 以内 | 成功率、长时间并发稳定性 |
| 抢购 / 秒杀 | 50ms 以内 | 抖动、超时率 |
| 注册 / 投票类任务 | 80ms 以内 | 成功率、重连速度 |
| 游戏多开 / 挂机 | 60ms 以内 | 抖动、丢包率 |
| 价格 / 舆情监控 | 150ms 以内 | 批量任务的整体波动 |
特别提醒一句:平均值会骗人。一个节点平均 60ms,但如果 P95 耗时飙到 500ms,说明每 20 次请求就有一次特别慢,对抢购、采集这类业务是致命的。所以统计的时候一定要把 P95 甚至 P98 拉出来看,别只盯着平均数。
实测常见的坑与优化建议
结合大量实测经验,这几个坑最常见:一是只测一次就下结论,单次结果偶然性太大;二是忽略本地基线,测节点之前先测一次不走代理的直连延迟做对照,才能看出节点本身加了多少耗时;三是把禁 ping 误判成节点故障,记得用 tcping 补测;四是只在空闲时段测,白天流畅不代表晚高峰扛得住;五是只看延迟不看成功率和抖动,快但不稳的节点比慢而稳的更耽误事。
优化方向上,选服务商时就优先考虑自建机房、节点城市覆盖广、支持高并发调用的厂商,从源头上减少第二段和第三段的延迟波动。以天启HTTP为例,节点覆盖国内多个城市,支持批量提取和高并发调用,你可以把上面的 ping 脚本和业务验证脚本直接跑在它提取的 IP 池上做轮询测试,用数据筛出最匹配自己业务的节点,而不是凭感觉挑。
常见问题
Q: ping 延迟很低,业务请求却很慢,是什么原因?
ping 只测了网络层的 ICMP 往返,而业务请求要经过 TCP 握手、节点转发、目标站处理等完整流程。可能是节点带宽或并发能力不足,也可能是目标站响应慢。用 curl 拆分各阶段耗时,就能定位是哪一段拖了后腿。
Q: 节点 ping 不通,是不是节点坏了?
不一定。很多机房出于安全策略会禁 ping,ICMP 不通但 TCP 服务完全正常。改用 tcping 测一下节点的服务端口,能通就说明节点是好的。
Q: 一天测几次才靠谱?
至少三个时段:早高峰、晚高峰、凌晨低峰各一轮。业务如果集中在某个时段,就重点测那个时段的表现,高峰期数据才是决定性依据。
Q: 每个节点要采样多少次才有参考价值?
单节点建议不少于 50 次,最好 100 次以上,并跨两三天执行。样本太少容易被偶发波动误导,算出来的平均值和 P95 都不可信。
Q: 有没有更省事的测法?
可以把本文的 Python 验证脚本改成批量版,配合服务商的提取 API 轮询测试整个 IP 池,一次性输出所有节点的成功率、平均耗时和 P95,按结果排序取用即可。选像天启HTTP这样支持批量提取的服务商,这套流程跑起来会非常顺。