
一、按流量计费的钱,到底花在哪了?
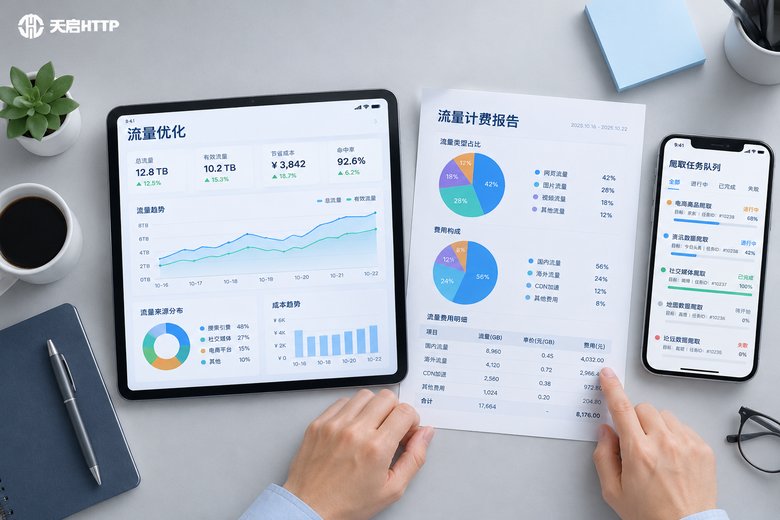
按流量计费是代理IP最主流的计费方式之一:用多少流量,付多少费用,听起来很公平。但很多用户月底一核对账单才发现,流量消耗远超预期。问题往往不在"用得多",而在"漏得多"。
要省钱,先要知道流量是怎么被吃掉的。一次代理请求的流量 = 上行的请求数据 + 下行的响应数据,其中响应体(网页HTML、接口返回的JSON、图片等)通常占大头。而下面这几类"隐形消耗"最容易被忽视:
1. 重复请求:同一个页面或接口被反复抓取,每次都完整下载一遍;
2. 大图直出:明明只需要缩略图,却把几MB的原图拉了下来;
3. 失败重试:超时后无脑重试,失败一次就多浪费一次流量;
4. 冗余字段:接口返回几十个字段,真正用到的只有三五个。
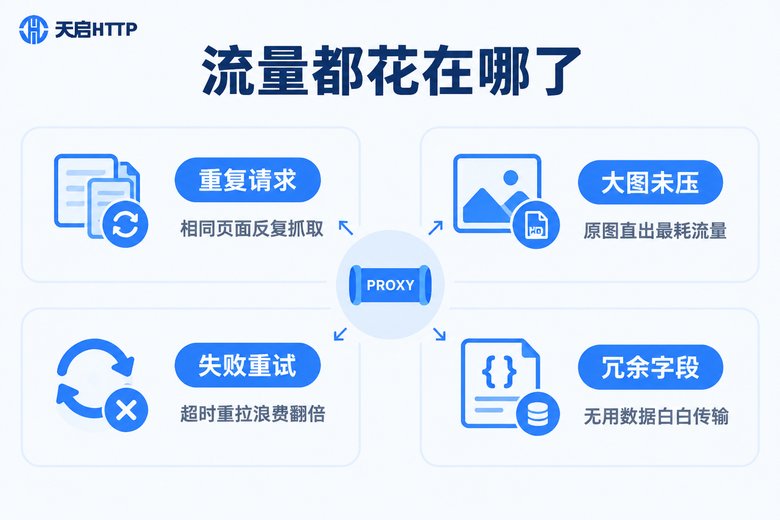
把这四项堵住,大部分浪费就消失了。下面三招——压缩、缓存、请求合并——就是针对性的解决方案。
二、第一招:压缩,让数据"瘦"着过网
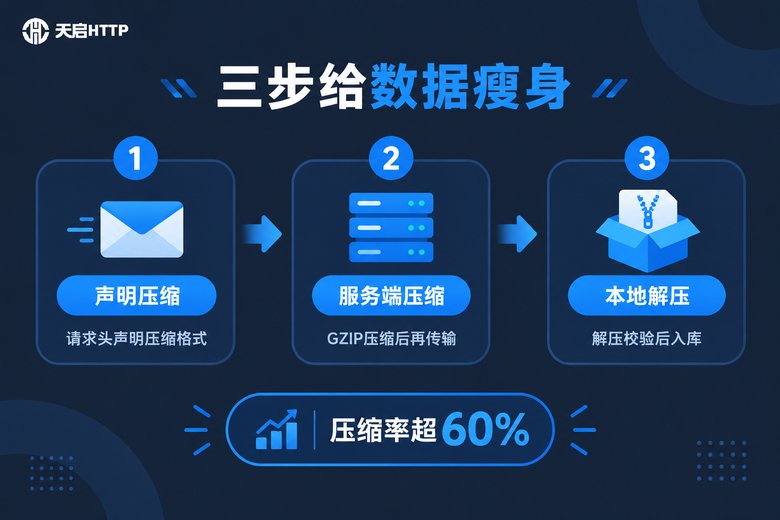
压缩是性价比最高的省流量手段,尤其适合HTML、JSON这类文本数据,压缩后体积通常能减少一半以上。
1. 让服务端帮你压缩。在请求头里声明支持压缩,目标服务器就会先把数据压成GZIP再传给你:
import requests

headers = {
    "Accept-Encoding": "gzip, deflate"  # 声明支持压缩
}
resp = requests.get("https://目标网站.com/api/list",
                    headers=headers, timeout=10)
# requests会自动解压,拿到的数据完整无损,流量却省了一大半
2. 字段裁剪。如果接口支持参数筛选,只请求需要的字段;不支持的话,也尽量选择返回内容更精简的接口版本,别为三五个字段扛回一整包数据。
3. 图片按需下载。需要缩略图就请求缩略图地址,做列表页就别拉详情大图;格式上优先WebP等高压缩比格式。
4. 分页拉取。一次只拉当前页需要的数据,别一口气把几千条记录全拖下来。
三、第二招:缓存,一样的数据只下载一次
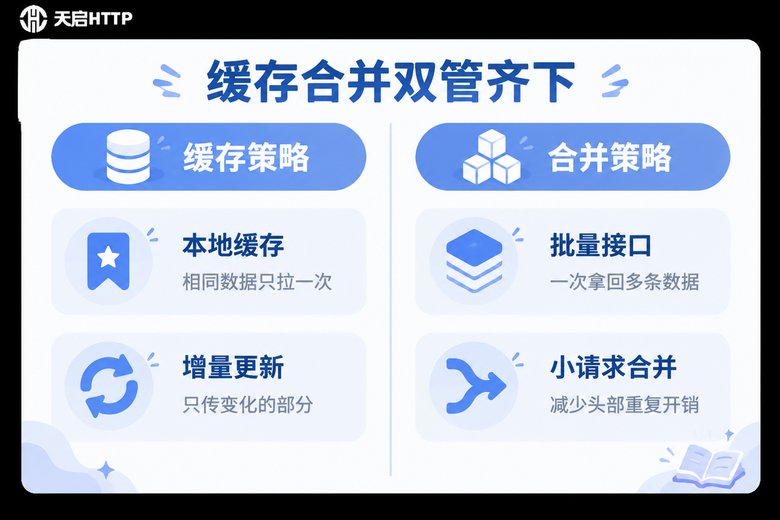
很多采集任务的痛点是:数据明明没变化,却每次都重新下载。缓存要解决的就是这个问题——本地有的,就不再走代理。
1. 本地缓存。把抓取结果按"URL+参数"生成键存到本地,再次遇到相同请求时直接读缓存,流量消耗为零:
import hashlib, json, os, time

def cache_key(url, params):
    raw = url + json.dumps(params, sort_keys=True)
    return hashlib.md5(raw.encode()).hexdigest() + ".json"

def smart_get(url, params, ttl=1800):
    key = cache_key(url, params)
    # 缓存存在且未过期,直接读本地,不走代理
    if os.path.exists(key) and time.time() - os.path.getmtime(key) < ttl:
        return json.load(open(key))
    data = fetch_via_proxy(url, params)
    json.dump(data, open(key, "w"))
    return data
2. 增量更新。列表类数据只抓新增部分;详情类数据可以利用ETag、Last-Modified等条件请求——数据没变化时,服务器只返回一个很小的"未修改"标记,几乎不耗流量。
3. 任务去重。调度层先查一遍"这个地址今天是否已经抓过",重复任务直接跳过,从源头上减少无效请求。
四、第三招:请求合并,把十次请求并成一次
每个HTTP请求除了正文,还要携带请求头、Cookie等"包装信息",小请求越碎,这部分开销占比越高。请求合并的思路很直接:能一次拿的,就不要分十次拿。
1. 批量接口优先。很多平台的接口支持一次传入多个ID、返回多条数据,批量调用比循环单次调用既省流量又省时间。
2. 复用连接。用Session保持长连接,避免每个请求都重新建立连接。连接反复建立不仅拖慢任务,还会增加超时和失败重试的概率——而重试一次,流量就多花一份:
session = requests.Session()
session.headers.update({"Accept-Encoding": "gzip, deflate"})
session.proxies = proxies

for pid in id_list:
    resp = session.get(detail_url.format(pid), timeout=10)
    # 同一会话内复用连接,稳定又省流量
3. 错峰调度。把大批量任务安排到业务低峰期执行,链路更通畅,超时重试更少,任务总流量自然更可控。
五、三招组合:省流量效果对比
三招不是单选题,组合使用效果最好。下面是一张基于常见业务经验的效果参考表:
| 策略 | 核心做法 | 适用数据 | 流量节省参考 |
|---|---|---|---|
| 压缩 | GZIP + 字段裁剪 + 按需拉图 | HTML、JSON等文本 | 约30%~60% |
| 缓存 | 本地缓存 + 增量更新 + 去重 | 更新频率低的数据 | 约20%~50% |
| 请求合并 | 批量接口 + 连接复用 + 错峰 | 小请求密集的采集 | 约10%~30% |
以上比例为经验参考值,实际收益取决于数据特点。落地顺序上建议:先上压缩(改动最小、见效最快),再补缓存(收益持久),最后做合并(优化架构),这是投入产出比最高的路径。
六、选对服务商,省钱事半功倍
策略能省流量,服务商则决定了每一MB流量的质量与单价。选择时建议重点关注三点:
1. 计费模式是否透明。像天启HTTP采用按流量计费的模式,用多少算多少,配合后台的用量统计,每一笔消耗都清清楚楚,方便你持续验证优化效果。
2. IP质量与稳定性。IP可用性高、响应快,超时重试就少,隐性浪费自然就低。天启HTTP的IP资源覆盖国内多个城市,支持HTTP/HTTPS/SOCKS5等多种协议,适合数据采集、电商运营等国内业务场景。
3. 先小量验证再放量。正式跑大批量任务前,先用小流量把整条链路跑通,确认压缩、缓存、合并策略都真正生效后,再逐步放大规模,避免策略失效导致流量白跑。
需要提醒的是,天启HTTP是国内IP代理服务商,适用于国内业务场景;如果你的业务需要海外IP,则不适合选择。
常见问题
Q: 按流量计费,上行请求也算流量吗?
一般情况下上下行都会计入消耗,但下行响应体通常占绝对大头,所以优化响应体积(压缩、按需拉取)收益最大。具体统计口径以服务商规则为准,建议在天启HTTP后台定期核对用量明细,发现异常消耗及时排查。
Q: 开启压缩会不会让CPU负担变重,得不偿失?
对文本数据来说,压缩节省的流量价值远大于CPU开销,普通服务器完全扛得住。注意图片、视频本身已经是压缩格式,重复压缩收益很小,重点压缩HTML、JSON等文本即可。
Q: 缓存时间设多长合适?数据会不会太旧?
取决于业务时效性:价格、库存类数据建议几分钟到半小时;榜单、列表类可以放宽到几小时;历史数据甚至可以长期缓存。再配合增量更新,就能在"新鲜度"和"省流量"之间取得平衡。
Q: 请求合并会不会更容易触发目标网站的风控?
合理控制就不会。单次批量别太大、请求频率贴近正常访问节奏、配合质量稳定的代理IP,反而因为总请求数变少、行为更规律,被风控的概率更低。
Q: 除了这三招,还有哪些省流量的好习惯?
给重试设上限(比如最多2次)、设置合理超时避免任务长时间挂起、错峰执行大批量任务、每周查看一次流量账单定位异常消耗。把天启HTTP的按流量计费模式和这些习惯结合起来,单位采集成本能降一大截。