
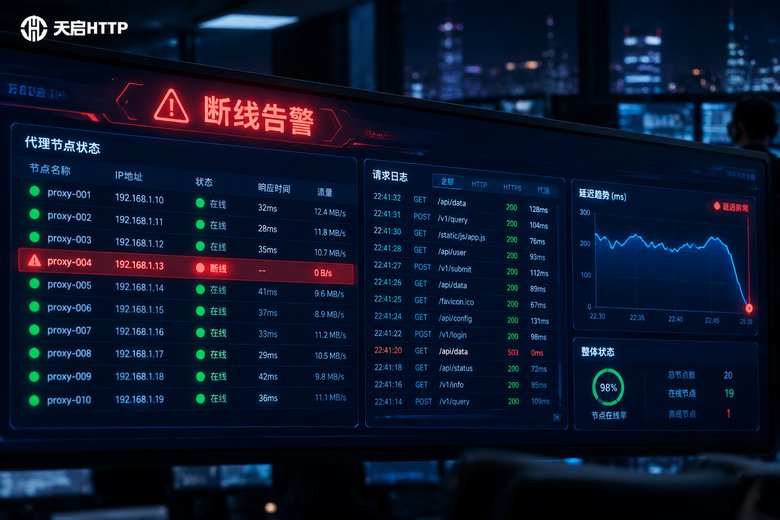
做数据采集、批量任务、多账号运营这类业务的朋友,多半经历过这样的场景:任务跑着跑着突然全红了,翻开日志一看,代理IP全在超时——而这时可能已经过去半个多小时,几百个任务白白空转。都2026年了,业务规模越做越大,靠人盯着屏幕发现问题早就不现实。给代理IP服务配一套断线告警,已经是基本功。这篇文章就把监控哪些指标、阈值怎么定、通知渠道怎么选,一次讲清楚。
为什么断线告警必须配?
代理IP是整条业务链路的"第一公里":IP一断,后面的采集、提交、验证全部停摆。断线通常有三种典型表现:
一是请求全部超时,大概率是代理服务整体异常或本地网络出了问题;二是成功率骤降,比如从99%掉到60%,往往是部分IP失效拖了后腿;三是个别IP频繁失败,其他都正常,这种情况只需剔除坏IP,不必大动干戈。
三种情况的应对方式完全不同,但共同点是:发现得越晚,损失越大。告警系统的价值,就是把"客户来问怎么挂了"变成"你在客户发现之前已经切好了备用方案"。
五个核心监控指标,缺一不可
配告警之前,先搞清楚要监控什么。下面五个指标基本覆盖了代理IP的绝大多数故障场景:
| 监控指标 | 含义 | 建议告警阈值 | 级别 |
|---|---|---|---|
| 可用率 | 成功请求占总请求的比例 | 低于95%警告,低于90%严重 | 警告/严重 |
| 响应延迟 | 请求从发出到返回的耗时 | 平均超过2秒 | 警告 |
| 连续失败次数 | 健康检查连续失败的次数 | 连续3次失败 | 严重 |
| IP存活时长 | 单个IP从可用到失效的时间 | 短于业务所需周期 | 提醒 |
| 超时率 | 超时请求占全部请求的比例 | 超过10% | 警告 |
其中可用率和连续失败次数是最核心的两个:可用率反映整体健康度,连续失败次数能最快发现"彻底断了"这种硬故障。建议单独跑一个轻量的健康检查任务,每隔30~60秒用当前代理发一次测试请求,专门产出这两个指标。

阈值怎么定?既要报得准,又不能"狼来了"
阈值定太高会漏报,定太低会天天误报,最后大家看到告警都麻木了。几条实用原则:
第一,连续N次再触发。网络抖动导致单次失败很正常,连续3次失败(约2~3分钟)再报警,能过滤掉九成以上的误报。
第二,分级设置。提醒级(如IP存活变短)只进邮件;警告级(延迟升高、可用率下滑)进IM群;严重级(连续失败、可用率低于90%)必须电话或短信叫醒人。
第三,配静默期和恢复通知。同一问题触发后30分钟内不重复轰炸;恢复后补一条"已恢复正常",心里才有底。
第四,按业务时段调整。凌晨没人值守的时段,可以把警告级也升级成短信,避免早上上班才发现半夜就断了。
通知渠道怎么选?按严重程度分发
告警不是发出去就算完,发到哪、谁看到、多快看到才是关键。常见渠道对比如下:
| 通知渠道 | 触达速度 | 适用场景 | 建议级别 |
|---|---|---|---|
| 电话 | 秒级 | 核心业务中断 | 严重 |
| 短信 | 秒级到分钟级 | 重要故障兜底 | 严重/警告 |
| IM群机器人 | 秒级 | 团队协同处理 | 警告 |
| 邮件 | 分钟级 | 记录留档、事后复盘 | 提醒 |
| 接口推送 | 实时 | 联动自动切换IP | 全部 |
推荐一套经过大量团队验证的组合:严重告警走"电话+短信"双保险,警告进IM群,提醒进邮件,同时所有级别的告警都通过接口推送同步给自动化脚本——收到严重告警时,脚本可以自动剔除故障IP、切换备用线路,把人工介入的时间压到最短。

一份能直接跑的监控脚本示例
如果暂时没有专业监控平台,用几十行Python也能搭一个最小可用的断线告警:
import requests
import time

PROXY_API = "你的代理提取链接"
TEST_URL  = "https://httpbin.org/get"
FAIL_LIMIT = 3            # 连续失败次数阈值
fail_count = 0

def get_proxy():
    """从API提取一个代理IP"""
    resp = requests.get(PROXY_API, timeout=5)
    ip, port = resp.text.strip().split(":")
    return {"http": f"http://{ip}:{port}", "https": f"http://{ip}:{port}"}

def check_proxy(proxy):
    """检测代理是否可用,返回耗时(毫秒)"""
    start = time.time()
    requests.get(TEST_URL, proxies=proxy, timeout=5)
    return round((time.time() - start) * 1000)

def send_alert(msg):
    """推送告警到IM群机器人"""
    requests.post("你的机器人Webhook地址",
                  json={"msgtype": "text", "text": {"content": msg}})

while True:
    try:
        proxy = get_proxy()
        cost = check_proxy(proxy)
        fail_count = 0
        print(f"检测正常,耗时 {cost}ms")
    except Exception:
        fail_count += 1
        print(f"检测失败,连续失败 {fail_count} 次")
        if fail_count >= FAIL_LIMIT:
            send_alert(f"【严重】代理IP连续{FAIL_LIMIT}次检测失败,请立即排查!")
            fail_count = 0
    time.sleep(60)
这个脚本的逻辑很简单:每分钟检测一次,连续失败3次就往IM群推送告警。跑稳定之后,再逐步加上延迟统计、可用率汇总和恢复通知,就能覆盖日常九成的断线场景。
告警响了之后,按这个流程处理
告警只是起点,处理要有章法:
第一步,判断故障范围。是单个IP失败还是全部失败?看监控面板一目了然。
第二步,单IP故障就地处理。把坏IP从任务池剔除、换上新IP即可,不用慌。
第三步,整体故障分层排查。先确认本地网络是否正常,再确认代理提取接口有没有返回,最后联系服务商确认服务状态。
第四步,记录复盘。把每次故障的时间、表现、原因、处理方式都记下来,积累两三个月,你对服务链路的薄弱点就心里有数了。
服务商够稳,告警才不会天天响
说到底,告警配得再好也只是"事后补救",想从根源上减少断线,还得靠服务商的质量。以天启HTTP为例,作为国内IP代理服务商,其自建机房和大带宽资源保障了IP的可用率与响应速度,IP池规模大、轮换及时,即使个别IP失效也能快速补充,业务侧的告警自然从"天天响"变成"很少响"。通过API提取代理后,接入上面这类健康检查脚本也很顺畅,监控、告警、自动切换一条链路很快就能跑通。
2026年,比拼的早已不是"有没有用代理IP",而是"代理IP链路有多稳、出了问题多快能恢复"。把监控指标配全、把通知渠道分级、把处理流程固化,再叠加一家靠谱的服务商,断线这件事就再也难不倒你了。
常见问题
Q: 健康检查的频率设多少合适?
建议30~60秒一次。太密会占用请求额度,太稀会拖长发现时间。配合"连续3次失败才告警"的规则,2~3分钟内就能确认真实故障,误报也少。
Q: 告警太多,大家都麻木了怎么办?
按分级原则收紧:只有严重级才打电话,警告进群、提醒进邮件;同时给每类告警设静默期,并定期复盘哪些告警可以合并或降级。
Q: 断线和IP被封是一回事吗?
不是。断线通常是网络链路或代理服务整体异常,所有IP一起出问题;被封是单个或部分IP不可用,其他正常。前者查链路和服务商,后者换IP就行。
Q: 没有技术团队,也能配断线告警吗?
可以。主流监控平台都支持可视化配置检测任务和通知规则,填入检测地址、选好通知渠道即可;也可以直接用文中的脚本稍作修改,成本很低。
Q: 天启HTTP接入这类监控方便吗?
方便。通过API提取代理后即可接入自建检测脚本或监控平台,配合其高可用、快响应的IP资源,告警阈值可以设得更严格,业务运行也更安心。