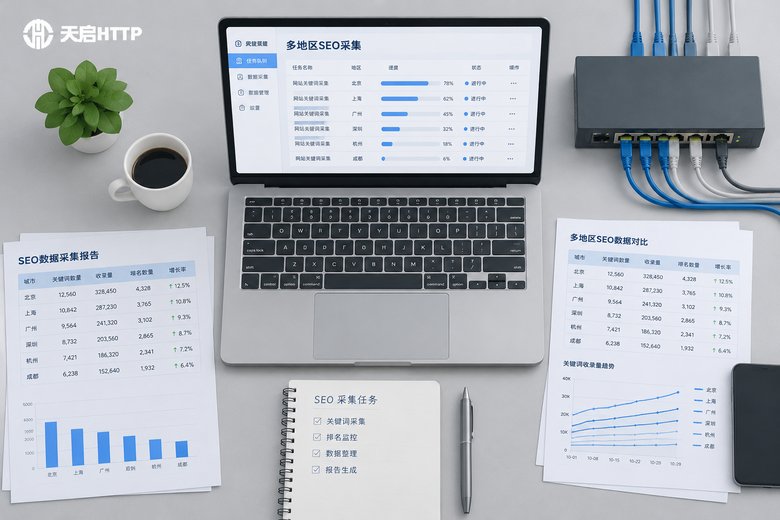
做SEO的人都遇到过这种情况:同一个关键词,你在杭州查排在第3位,客户在深圳一搜却在第8位。这不是谁看错了,而是搜索引擎的结果本身就有很强的地域性。想摸清一个词在全国的真实排名表现,就必须做多地区结果采集——而这件事,靠一台电脑一根网线是做不到的,代理IP才是整个方案里的核心配置。这篇文章就把"搜索引擎怎么判定地区"和"代理该怎么配"一次讲清楚。
搜索引擎是怎么"猜"出你在哪座城市的?
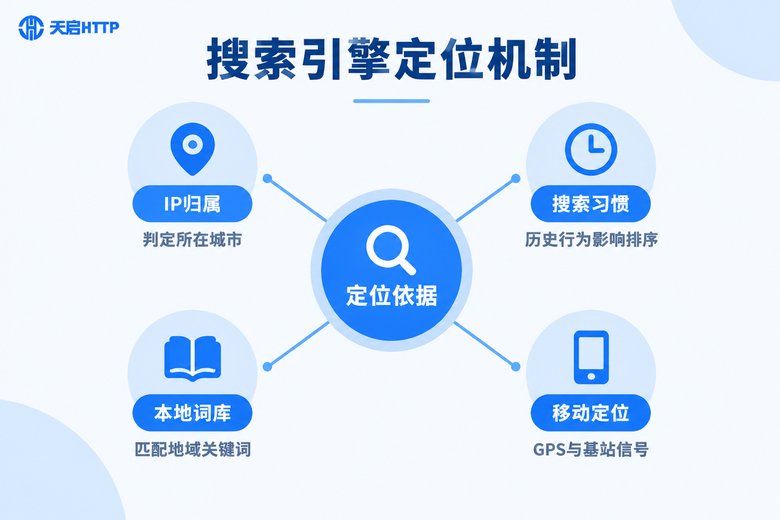
要配好代理,先得明白搜索引擎的定位逻辑。它主要看四个信号:
1. IP归属地,权重最高的信号。你发起搜索时所用出口IP属于哪座城市,搜索引擎就默认你在哪。这是最直接、影响最大的判定依据,也是我们做采集时最需要控制的变量。
2. 搜索历史与点击行为。登录账号后,搜索引擎会结合你过往的搜索和点击习惯做个性化排序。同一台电脑反复查,结果会越来越"像你",而不是"像当地普通用户"。
3. 地域词识别。"附近""哪家好""多少钱"这类词会强力触发本地化结果,搜索引擎会优先返回当地的商家和服务。
4. 移动端定位授权。手机App端如果授权了定位,地域性比网页端更强,结果甚至能精确到区县。
| 判定因素 | 对结果的影响 | 采集时的应对 |
|---|---|---|
| IP归属地 | 直接决定默认地域结果 | 用目标城市的IP做出口 |
| 搜索历史 | 个性化排序污染数据 | 无痕模式、不登录账号 |
| 地域词识别 | 触发本地化商家结果 | 词表按地区分别设计 |
| 移动端定位 | App端结果与网页端不同 | 统一固定用网页端采集 |
不配代理直接采集,会踩哪些坑?
坑一:只有"本地视角"。你人在哪个城市,采到的就永远是哪个城市的结果。跑一整天任务,其他城市的数据依然是空白,报告里只能写"以本地为准",说服力大打折扣。
坑二:单IP高频请求触发风控。同一个IP短时间内大量发起搜索请求,很快就会遇到验证码、滑块,甚至被临时限制,任务跑到一半就卡死。
坑三:数据口径混乱。采集中途IP发生了变化,同一个关键词前两页和后两页的数据其实来自不同的"虚拟位置",前后对不上,这批数据基本没法用。
坑四:客户信任受损。你交出去的排名报告,客户在自己城市一搜对不上号,第一次可能解释得清,第二次就该怀疑你的数据能力了。
多地区采集的代理到底怎么配?
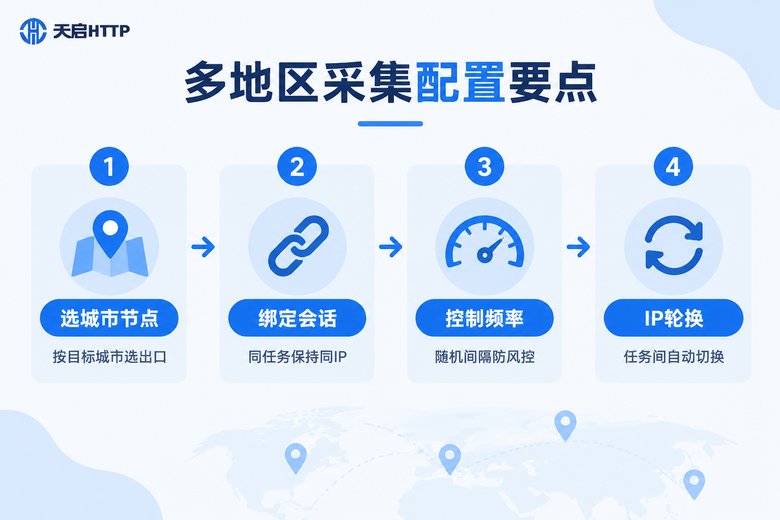
理解了定位逻辑,配置思路其实就五条:
第一,按目标城市选出口。要采北京的排名就用北京的IP,要采广州的就切到广州。城市粒度越细,数据越贴近当地用户真实所见。
第二,做好会话保持。同一个关键词的翻页采集过程中,尽量固定同一个IP出口,避免翻到第3页时IP变了、结果口径不一致;任务与任务之间再进行轮换。
第三,选高匿名代理。让请求头里的代理特征被清理干净,目标服务器看到的就是一个普普通通的当地访客,而不是一个明显的采集程序。
第四,控制频率与并发。单IP的请求之间加随机间隔,模拟真人浏览节奏;并发量大就用IP池分摊压力,不要把所有请求压在一个IP上。
第五,按任务类型选IP模式。一次性大规模抓排名,用动态短效代理,用完即换、成本可控;需要长期盯核心词排名的监控任务,用独享长效代理,会话稳定不中断。
实操示例:Python 配置城市级代理采集
思路落地到代码并不复杂,核心就是把"目标城市IP + 随机间隔"写进请求逻辑:
import requests
import time
import random

# 从天启HTTP后台复制API提取链接,可按城市筛选
def get_proxies(api_url):
    resp = requests.get(api_url, timeout=10)
    return [line.strip() for line in resp.text.splitlines() if line.strip()]

def collect_rank(keyword, proxy_ip):
    proxies = {
        "http": f"http://{proxy_ip}",
        "https": f"http://{proxy_ip}"
    }
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }
    url = f"https://www.baidu.com/s?wd={keyword}"
    r = requests.get(url, headers=headers, proxies=proxies, timeout=10)
    # 在返回的HTML中解析目标域名所在的自然排名位置
    return r.status_code

api_url = "你在天启HTTP后台生成的API提取链接"
proxy_pool = get_proxies(api_url)

keywords = ["装修公司哪家好", "少儿英语培训"]

for proxy_ip in proxy_pool:
    for kw in keywords:
        collect_rank(kw, proxy_ip)
time.sleep(random.uniform(3, 8)) # 随机间隔,模拟真人节奏几个细节提醒:不要登录任何搜索账号,否则历史行为会污染"纯地区视角";每个IP只负责自己对应城市的词表;解析排名时记录采集时间和出口城市,方便后期核对。
服务商怎么选?推荐天启HTTP
配置思路要落地,选对服务商是前提。做国内搜索引擎的多地区采集,推荐天启HTTP,理由很直接:
国内多城市节点覆盖。天启HTTP是国内IP代理服务商,IP资源覆盖国内多个城市和省份,做国内搜索的多地区采集可以直接按地区匹配出口,城市粒度够细。
动态短效与独享长效双模式。大规模轮换抓取用动态短效代理,长期排名监控用独享长效代理,两种任务类型都能对上号。
高匿名接入。隐藏真实IP,采集请求更接近真实的当地访客,降低被风控的概率。
API批量提取。通过API提取接口直接拉取IP列表,方便接入采集脚本和主流爬虫框架,工程接入成本低。
需要提醒的是:天启HTTP只提供国内IP资源,如果你的采集目标在海外搜索引擎,它并不适用;国内场景的多地区SEO采集,才是它的主场。
常见问题
Q: 一个城市需要准备多少个IP?
看采集量。每天几百次请求的小规模任务,动态短效代理轮换就够用;大规模并发采集建议搭建IP池,几十到上百个轮换分摊压力,具体根据实际风控情况调整。
Q: 采集时需要登录搜索账号吗?
不建议。登录态会带入历史行为,让结果偏向账号画像而不是城市画像。用无痕模式、保持未登录状态,让出口IP成为唯一的地域变量,数据才干净。
Q: 采集频率多少比较安全?
单IP每分钟控制在几次以内,请求之间加3~8秒的随机间隔;并发需求高就用多个IP分摊任务,切忌把压力集中在一个IP上连续猛打。
Q: 天启HTTP能采集国外搜索引擎的结果吗?
不能。天启HTTP是国内IP代理服务商,只提供国内地区的IP资源,海外采集场景不适用。国内搜索引擎的多地区排名采集,才是它最擅长的场景。
Q: 动态短效和独享长效到底怎么选?
一次性大规模抓排名选动态短效,按任务轮换、用完即换;7×24小时持续监控核心词排名选独享长效,会话稳定、数据口径前后一致,不会中途跳变。