做价格监控的团队几乎都遇到过这样的场景:采集任务原本跑得好好的,突然开始返回验证码、空数据,甚至直接连接失败——这就是被目标平台"限流"了。限流一旦发生,价格数据断更,比价、调价、预警全链条的时效性都会被拖垮。很多人第一反应是"加大重试",结果往往封得更死。这篇文章就从分布式调度和IP轮换两个维度,给你一套真正能落地的解决方案。
价格监控为什么特别容易被限流?
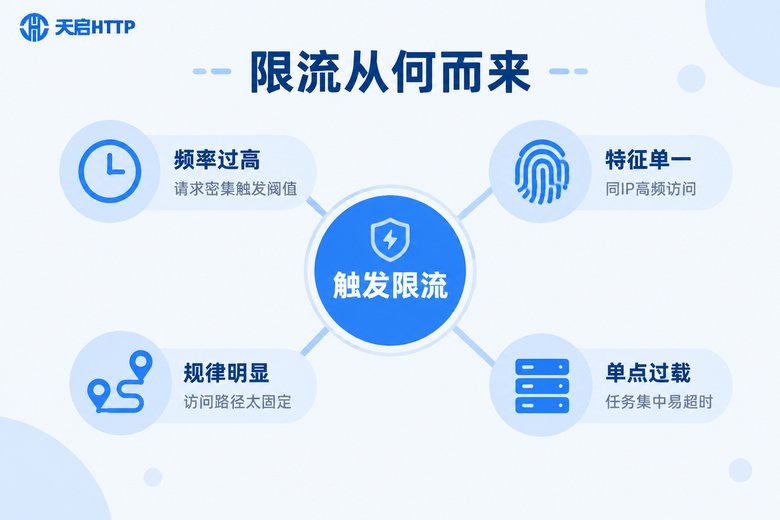
先理解对手,才能应对对手。电商平台和各类比价目标站点的风控系统,主要从三个维度判断"你是不是机器":
一是请求频率。价格监控天然要求高频、定时刷新,同一个页面每隔几分钟就要抓一次,频率远超正常用户的浏览习惯,最容易撞上阈值。
二是IP特征。如果所有请求都来自同一个IP,哪怕频率控制得不错,风控也会把这个IP标记为"采集源"——轻则弹验证码、返回空页面,重则直接封禁。
三是行为规律。固定时间、固定顺序、固定User-Agent的访问路径,在风控眼里就是一张清晰的"机器人画像"。
常见的限流信号和对应思路可以对照下表:
| 限流信号 | 常见表现 | 对应思路 |
|---|---|---|
| 频率限制 | 返回429状态码、验证码页 | 错峰调度、随机间隔 |
| IP封禁 | 单个IP完全无法访问 | IP轮换、多出口分散 |
| 行为识别 | 页面正常但数据被污染 | 随机化路径与请求指纹 |
| 单点过载 | 任务积压、节点频繁超时 | 分布式分片执行 |
记住一个原则:先用调度把节奏降下来,再用IP轮换把压力摊开。顺序反了,只会陷入"被封—重试—封得更狠"的恶性循环。
分布式调度:先别急着换IP,把节奏控制好
分布式调度的核心思想是:不追求单点快,而追求整体稳。把"一台机器拼命抓"改成"多台机器慢慢抓",总抓取量不变,但单点压力成倍下降,风控看到的访问曲线也会平滑得多。
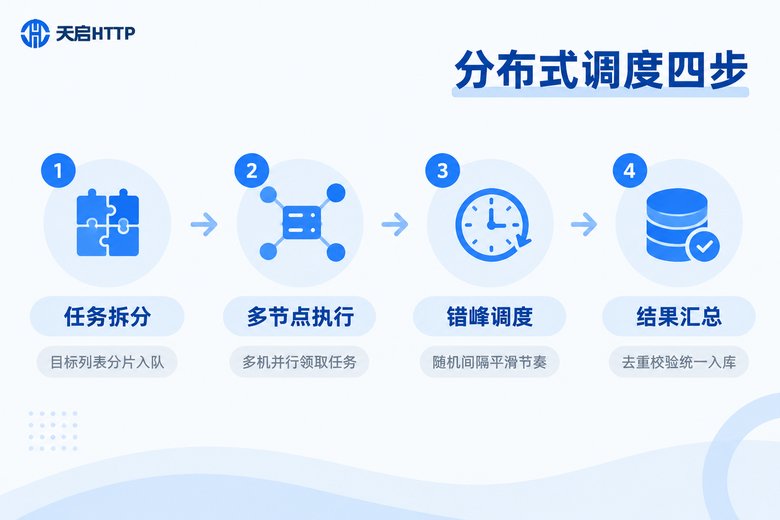
一套最小可行的调度架构分四步:
① 任务拆分:把待监控的商品列表按店铺、品类切成小分片,写入持久化的任务队列;
② 多节点领取:多台采集节点从队列各自领任务,谁空闲谁多干,互不等待;
③ 错峰执行:请求之间加入随机间隔,把"整点齐刷刷抓取"打散在时间轴上;
④ 结果汇总:各节点把价格数据写入统一数据库,去重、校验后入库。
import time
import random
import requests

HEADERS_POOL = [
    {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)……"},
    {"User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7)……"},
]

def polite_fetch(url):
    """随机间隔 + 随机UA,模拟真实访问节奏"""
    time.sleep(random.uniform(3, 8))        # 3~8秒随机间隔
    headers = random.choice(HEADERS_POOL)
    resp = requests.get(url, headers=headers, timeout=10)
    resp.raise_for_status()
    return resp.text

def jittered_delay(base_seconds=60):
    """定时任务加随机抖动,避免全员整点齐发"""
return base_seconds + random.uniform(0, base_seconds * 0.2)几个容易被忽略的细节:随机抖动一定要有,整点集中发请求等于自报家门;重试要有上限和退避,失败后先等待再重试,而不是立刻连发;队列必须持久化,这样某个节点宕机后,未完成的任务能被其他节点接手,监控不中断。
IP轮换:让每个请求都"像不同的人"
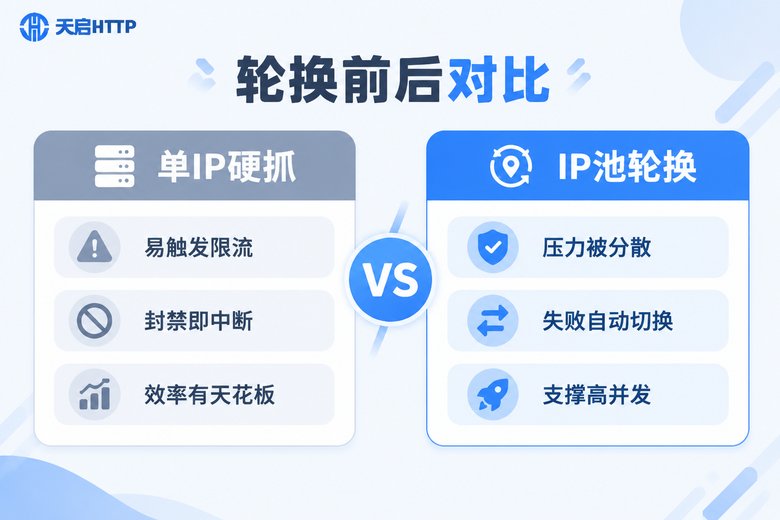
调度解决的是"节奏"问题,IP轮换解决的是"身份"问题。再礼貌的访问节奏,如果永远来自同一个IP,风控照样能把你识别出来。IP轮换的本质,是让平台看到的是一群分散的、正常的访问者,而不是一个高频的采集器。
常用的轮换策略有三种,按页面类型组合使用效果最好:
| 轮换策略 | 工作方式 | 适用场景 |
|---|---|---|
| 按请求轮换 | 每次请求换一个IP | 列表页、搜索页大批量抓取 |
| 会话级保持 | 同一任务固定IP一段时间 | 需连续翻页、保持状态的页面 |
| 失败自动切换 | 请求异常立即换IP重试 | 所有场景的兜底机制 |
import random
import requests

class ProxyPool:
    """简易IP轮换池:从代理商API定期提取,失败自动剔除"""
    def __init__(self):
        self.proxies = []

    def refresh(self):
        # 替换为你自己的代理提取链接(示例结构,以服务商文档为准)
        data = requests.get("你的API提取链接", timeout=10).json()
        self.proxies = [f"http://{item['ip']}:{item['port']}" for item in data]

    def get(self):
        return random.choice(self.proxies) if self.proxies else None

def fetch(url, pool):
    for _ in range(3):                       # 最多重试3次
        proxy = pool.get()
        try:
            resp = requests.get(url,
                                proxies={"http": proxy, "https": proxy},
                                timeout=10)
            if resp.status_code == 200:
                return resp.text
        except Exception:
            if proxy in pool.proxies:
                pool.proxies.remove(proxy)   # 剔除失效IP
return None两条实战经验:IP质量比数量重要,一个高匿、干净的IP池,胜过一大池子早已被标记的IP;轮换要和调度联动,单节点单位时间内消耗的IP数量必须和它的请求频率匹配,否则换得再勤,整体看起来还是"高频访客"。
调度 + 轮换组合拳:一套可落地的架构
把两者组合起来,就是一套成熟的价格监控采集架构:
调度中心负责生成任务、控制全局频率上限 → 任务队列负责分发与容错 → 采集节点集群各自携带独立IP池,按"随机间隔 + 会话保持 + 失败切换"执行抓取 → 清洗入库后供比价、调价、预警系统消费。
这套架构有两大好处:可横向扩展——监控的商品从一万涨到十万,只需加节点、加IP,不用重构代码;抗风控能力强——单个IP被封不影响整体任务,队列会自动把任务转交给健康节点继续执行。
IP资源怎么选?天启HTTP让轮换更省心
方案落地时,IP池的质量直接决定采集的稳定性。如果你监控的是国内电商平台、行业站点的价格数据,推荐使用天启HTTP——它是专注国内场景的IP代理服务商,拥有海量国内IP资源,支持API批量提取,可以直接接入上文示例中的轮换池;高匿名转发让目标服务器难以识别代理特征。配合分布式调度使用,价格监控任务可以长时间稳定运行。具体套餐和IP量级,可以到天启HTTP官网按业务规模选择。
常见问题
Q: IP轮换是不是越频繁越好?
不是。频繁轮换会丢失会话状态,对需要连续翻页或保持登录态的页面反而不友好。正确做法是按页面类型区分:列表页用按请求轮换,详情页用会话级保持,再配一层失败自动切换兜底。
Q: 被限流后立刻换IP就能恢复吗?
不一定。如果触发的是频率限制,换IP后继续高频请求,新IP也会很快被封。建议先降低频率、拉长间隔,再配合换IP,双管齐下才能根治。
Q: 分布式调度需要很多服务器吗?
不需要一步到位。两三台机器加一个持久化的任务队列,就能跑起最小架构。核心是"任务拆分 + 错峰 + 失败转移"这套机制,规模可以随业务量慢慢扩展。
Q: 价格监控的抓取频率设置多少合适?
取决于业务对时效的要求和目标站的容忍度。建议从保守值起步(单IP每分钟个位数请求),观察返回状态逐步上调。比价类业务通常分钟级更新就够用,不必追求秒级。
Q: 天启HTTP适合价格监控这类场景吗?
适合。天启HTTP是国内IP代理服务商,IP资源覆盖国内,支持API批量提取和高匿名转发,很契合国内电商平台价格监控的采集需求;需要海外IP的场景则不在其适用范围内。