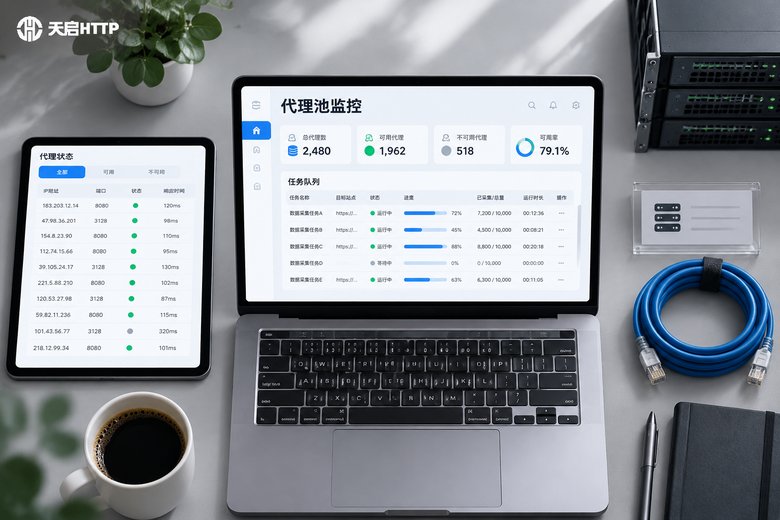
做数据采集的朋友大概率遇到过这样的场景:代理池里明明躺着几百个IP,任务跑起来成功率却越来越低,重试次数一路飙升。问题往往不在"池子不够大",而是池子里混进了大量无效IP。这篇文章就来聊聊爬虫代理池的日常维护,重点讲清楚如何让系统自动剔除无效IP,让池子始终保持"满血"状态。
代理池为什么会"越用越脏"
很多人以为把IP采集成池就一劳永逸,实际上代理池更像一个"消耗品仓库",无效IP的来源主要有四个:
1. IP天然有生命周期:尤其是短效代理,存活时间本来就以分钟计,到期自动失效,谁也拦不住。
2. 目标网站在反制:访问频率稍高就会被限流、封禁,IP从"可用"悄悄变成"半残"。
3. 高并发把IP"打挂":单个IP承载的请求量过大,响应速度会断崖式下跌,直到彻底无响应。
4. 线路与机房波动:供应商侧的设备维护、网络抖动,也会让一部分IP临时失联。
所以代理池维护的本质就八个字:持续质检,及时换血——把不能干的剔出去,把新鲜的补进来。
什么样的IP算"无效"?先认清四个信号
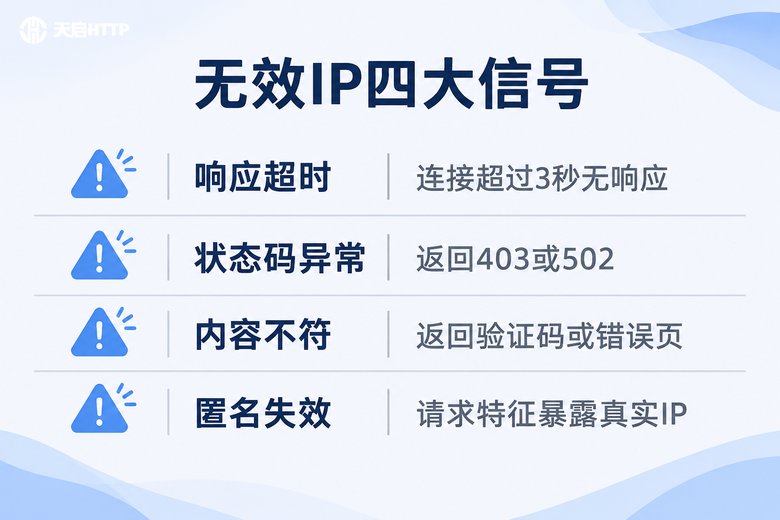
要实现自动剔除,第一步是给"无效"下定义。实战中主要看以下四个信号:
响应超时:连接超过3秒还没反应,基本可以判定这条链路有问题。
状态码异常:频繁返回403、429、502,说明这个IP很可能已经被目标站盯上了。
内容不匹配:明明请求的是商品页,返回的却是验证码页、登录页,属于典型的"软失效"。
匿名度下降:请求特征开始暴露真实信息,采回来的数据容易被污染,这类IP要果断淘汰。
| 信号 | 典型表现 | 处理动作 |
|---|---|---|
| 响应超时 | 连接超过3秒无响应 | 标记可疑,复检确认 |
| 状态码异常 | 频繁返回403或502 | 累计失败,达标剔除 |
| 内容不匹配 | 返回验证码或错误页 | 进入冷却,稍后复检 |
| 匿名度下降 | 请求特征暴露真实IP | 直接淘汰,不再复用 |
自动剔除策略详解:给池子装上四道防线
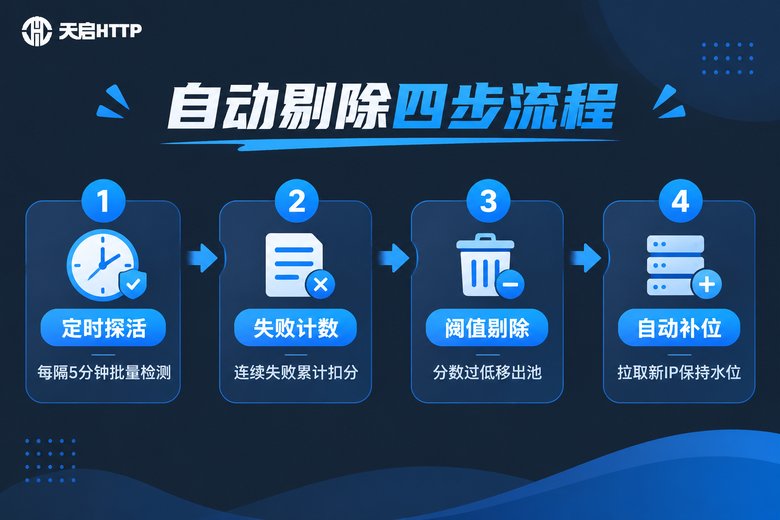
第一道:定时健康检查(探活)。每隔一段时间,用轻量请求(比如访问一个稳定页面)对池内IP做一轮"体检",超时或异常的直接标记。探活频率要和IP的生命周期匹配:短效代理建议1~5分钟一轮,别等任务跑失败了才发现IP早凉了。
第二道:失败计数 + 阈值剔除。业务请求每失败一次就记一笔账,连续失败达到阈值(比如3次)就移出池子。这个策略实现简单、反应实时,适合作为日常兜底。
第三道:加权评分,动态排序。更精细的做法是给每个IP打分:成功加分、失败扣分,取IP时优先用高分。分数跌破及格线就淘汰。这样一来,"偶尔抽风"的IP不会被一票否决,"稳定靠谱"的IP会被优先调度,整体成功率明显更平滑。
第四道:冷却熔断与自动补位。被目标站限流的IP,直接扔掉有点浪费——可以先放进"冷却区",过段时间复检,恢复了再回池。同时,主池水位一旦低于阈值,就自动从供应商API拉取新IP补充,保证采集任务不断粮。
| 策略 | 核心逻辑 | 优点 | 适用场景 |
|---|---|---|---|
| 定时探活 | 周期性主动检测 | 提前发现问题 | 所有池子必备 |
| 失败计数 | 连续失败达标即剔除 | 简单直接、实时 | 中小规模代理池 |
| 加权评分 | 成功加分失败扣分 | 平滑客观、可排序 | 大规模长期运行 |
| 冷却熔断 | 异常IP先冷冻再复检 | 避免误杀、省成本 | 目标站限流频繁 |
代码实战:一个带自动剔除的迷你代理池
上面的思路落地成代码并不复杂,下面用Python写一个几十行的迷你版,核心是"评分 + 计数"双保险:
import time
import requests
from collections import defaultdict

class ProxyPool:
    def __init__(self, fail_limit=3, timeout=3, score_floor=40):
        self.scores = {}                 # IP -> 健康分
        self.fails = defaultdict(int)    # IP -> 连续失败次数
        self.fail_limit = fail_limit     # 连续失败剔除阈值
        self.timeout = timeout           # 探活超时(秒)
        self.score_floor = score_floor   # 低于该分数直接淘汰

    def add(self, ip):
        self.scores[ip] = 100            # 新IP入池,初始满分

    def probe(self, ip):
        """定时探活:用轻量请求检测IP是否可用"""
        try:
            start = time.time()
            r = requests.get("https://www.baidu.com",
                             proxies={"http": f"http://{ip}",
                                      "https": f"http://{ip}"},
                             timeout=self.timeout)
            return r.status_code == 200 and time.time() - start < self.timeout
        except Exception:
            return False

    def report(self, ip, ok):
        """业务侧上报结果,驱动评分与剔除"""
        if ok:
            self.fails[ip] = 0
            self.scores[ip] = min(100, self.scores[ip] + 5)   # 成功加分
        else:
            self.fails[ip] += 1
            self.scores[ip] -= 30                             # 失败扣分
            if self.fails[ip] >= self.fail_limit or \
               self.scores[ip] <= self.score_floor:
                self.remove(ip)

    def remove(self, ip):
        """移出主池(可先放入冷却区,等待复检回池)"""
        self.scores.pop(ip, None)
        self.fails.pop(ip, None)

    def get(self):
        """优先取健康分最高的IP"""
        return max(self.scores, key=self.scores.get, default=None)
业务侧的用法很简单:取IP、发请求、上报结果,三步走:
pool = ProxyPool()
for ip in ["117.68.x.x:8000", "223.214.x.x:3128"]:   # 示例IP
    pool.add(ip)

ip = pool.get()
try:
    resp = requests.get("https://target-site.com/data",
                        proxies={"http": f"http://{ip}"}, timeout=5)
    pool.report(ip, resp.status_code == 200)
except Exception:
    pool.report(ip, False)
再配一个后台线程,让"体检"定时跑起来:
import threading

def probe_loop(pool, interval=300):
    """每5分钟对全池做一轮健康检查"""
    while True:
        for ip in list(pool.scores):
            if not pool.probe(ip):
                pool.report(ip, False)
        time.sleep(interval)

threading.Thread(target=probe_loop, args=(pool,), daemon=True).start()
生产环境中,还可以把数据放进Redis,用有序集合按分数存IP,剔除和取用都是 logarithmic 级别的开销,池子再大也不慌。
剔除只是止损,"补水"才是闭环
自动剔除解决了"去坏",但池子要持续转起来,还得解决"添新":
水位监控:设定最低水位线,比如池内可用IP少于100个就触发告警,避免任务高峰期"无米下锅"。
自动补货:对接供应商的API提取接口,定时定量拉新IP入池,和剔除逻辑形成一进一出的闭环。
源头把控:IP质量差,再勤快的维护也救不回来。源头选对了,剔除频率自然就低,维护成本直接减半。
选对IP供应商,维护事半功倍
说到源头质量,以国内数据采集场景为例,天启HTTP是国内代理IP服务商,提供动态短效代理、隧道代理等产品,支持HTTP/HTTPS/SOCKS5协议,自建机房、高并发大带宽,IP通过API统一提取,可以直接对接上面这套代理池逻辑——新IP拉取、失效剔除、水位补充,整条链路都能自动化串起来。
需要提醒的是,天启HTTP的资源面向国内业务场景,如果你的采集目标在国内,它能明显降低代理池的维护压力;如果业务需要海外IP,则不在它的适用范围内,选型时要先想清楚自己的目标站点在哪里。
常见问题
Q: 代理池多久做一次健康检查比较合适?
没有统一答案,关键看IP的生命周期。短效代理存活时间短,建议1~5分钟一轮探活;同时用失败计数做实时兜底,两条线配合,既不误杀也不漏杀。
Q: 被剔除的IP还能回收再利用吗?
可以。建议把剔除的IP先放进"冷却区",过一段时间复检,恢复可用再回池。很多"无效"只是临时限流,一棍子打死会白白浪费成本。
Q: 代理池是不是越大越好?
不是。池子越大,检测和维护成本越高,真正该关注的是"有效水位"——保证任意时刻都有足够数量的高分行IP可用,比单纯堆数量重要得多。
Q: 天启HTTP适合接入爬虫代理池吗?
适合国内数据采集场景。天启HTTP是国内IP代理服务商,提供动态短效代理、隧道代理等产品,支持HTTP/HTTPS/SOCKS5协议,通过API提取即可对接自建代理池,实现自动补位。注意它面向国内业务,不适用于需要海外IP的场景。